分数阶差分与平稳性:在保留记忆和通过 ADF 之间求平衡
所有教科书都教你「价格不平稳,差分一次变收益」——可这一刀下去,序列的记忆被砍得干干净净:本文合成序列里一阶差分与原对数价格的相关系数只剩 0.005,「现在贵还是便宜」这个信息彻底蒸发。López de Prado 的分数阶差分主张只差 d=0.37 这么多:刚好通过 ADF(p=0.039),同时保住 91.1% 的记忆,捕捉真实均值回归成分的相关系数 0.416(一阶差分只有 0.073)。但本文最硬的发现是反面:FFD 的固定窗口截断本身会伪造平稳性——在真实 I(1) 的纯随机游走上做同样的 d=0.37 分数阶差分,窗宽 311 时 ADF 错误拒绝率高达 73%,窗宽 1669 时飙到 93%,而名义水平只有 5%。同一个数据生成过程换 20 个种子,d* 从 0.00 摆到 0.55(标准差 0.138);τ 从 1e-2 调到 1e-5,同一个 d 的记忆保留从 99.8% 掉到 29.2%;FFD 与扩张窗口两种实现在同一 d 下相关系数仅 -0.10。四项对抗式检验全过:置换 300 次真实 Sharpe 0.68 超 95 分位 0.53(p=0.020)、随机游走上因果 z 的 Sharpe -0.02 干净归零、全样本 z 的 look-ahead 在随机游走上凭空刷出 0.40(高阶)。
每一本时间序列教材都教同一件事:价格不平稳,差分一次变成收益,就平稳了,可以往模型里喂了。这话没错,但它藏了一个代价——差分是一把很钝的刀,它在换来平稳性的同时,把序列的记忆砍得一点不剩。
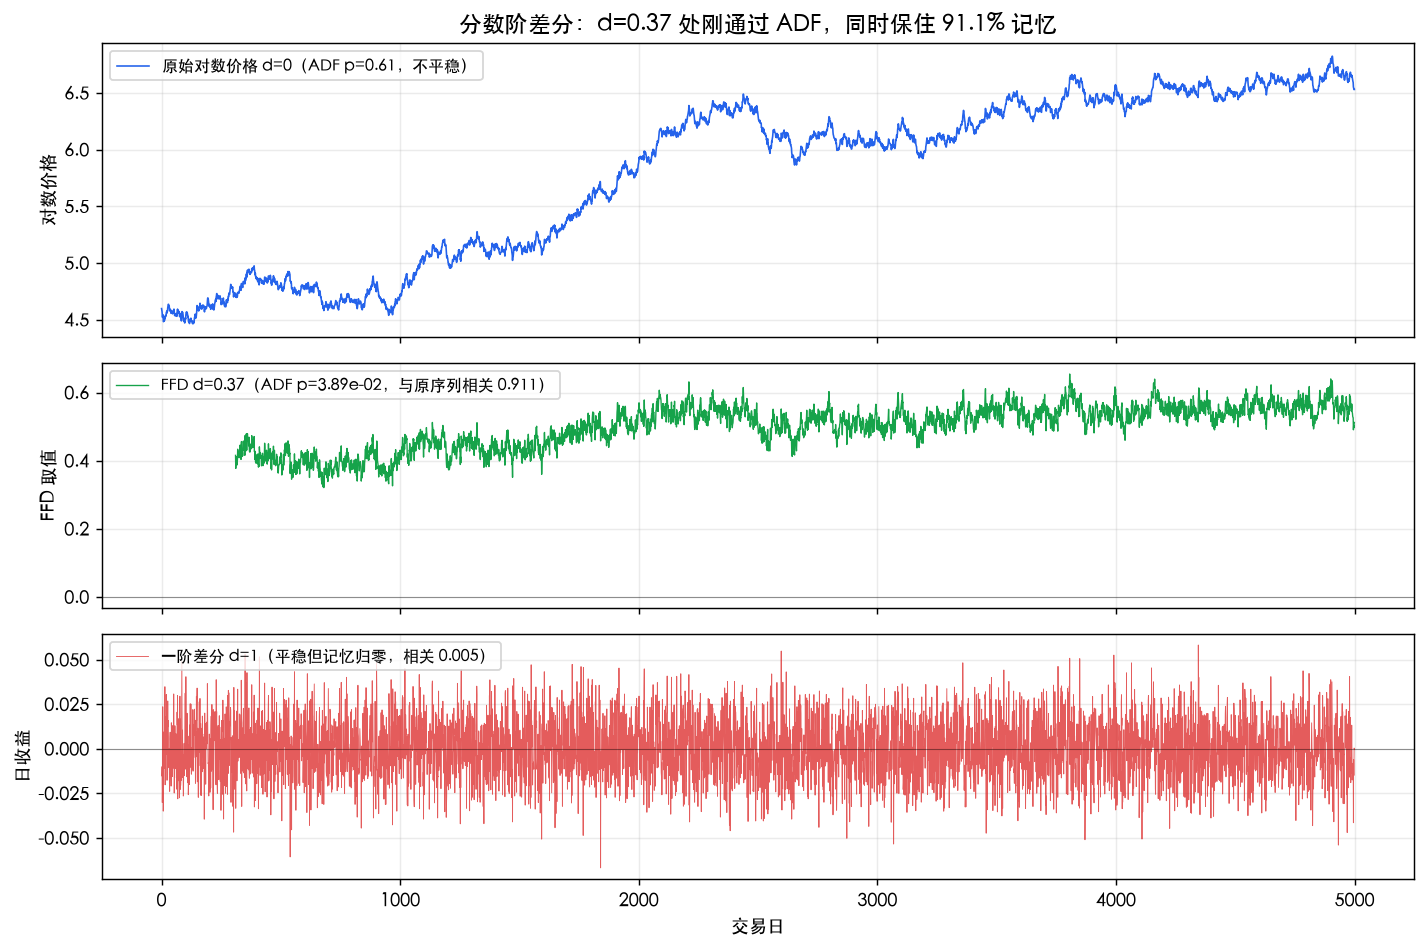
结论先放这:在本文的合成序列上,一阶差分后的序列与原始对数价格的相关系数只剩 0.005,“当前价位是高是低”这个信息完全蒸发;而分数阶差分只差 d=0.37 这么多,就已经通过 ADF 检验(p=0.039),同时保住 91.1% 的记忆,对真实均值回归成分的捕捉相关系数 0.416(一阶差分只有 0.073)。
但本文真正想让你带走的,是反面那一半:FFD 的固定窗口截断,本身就会伪造平稳性。在一条真实 I(1) 的纯随机游走上做同样的 d=0.37 分数阶差分,窗宽 311 时 ADF 的错误拒绝率高达 73%,窗宽 1669 时飙到 93%——名义显著性水平只有 5%。也就是说,你手上那个”通过了 ADF”的分数阶差分特征,很可能只是被截断制造出来的幻觉。所有图表均由下文 Python 真实计算,固定种子可复现,非占位图。
一、为什么整数阶差分是一种浪费#
先把问题摆清楚。机器学习模型(以及绝大多数统计推断)需要输入特征是平稳的——均值方差不随时间漂移,否则样本内学到的系数拿到样本外根本不成立。但价格序列是 I(1) 的,直接喂进去就是伪回归。
标准解法:差一次,得到收益率,平稳了。问题在于这一刀砍掉的东西太多。
价格序列里有两类信息:一类是”往哪儿走”(增量、动量),一类是”现在在哪儿”(水平、相对估值)。一阶差分只保留第一类,第二类被完全抹除。可”现在这个价位相对历史是贵是便宜”,恰恰是均值回归类策略的全部信息源。
用本文的合成数据说话。我构造一个真值完全已知的对数价格:
其中 是纯随机游走(不可预测), 是 Ornstein-Uhlenbeck 均值回归过程(半衰期 35 天)——这是整条序列里唯一的可预测成分。谁能把 挖出来,谁就拿到了 alpha。
import numpy as np

N, THETA, SIG_X, SIG_T, DRIFT = 5000, 0.02, 0.012, 0.012, 0.0003

def make_series(seed=20260801, n=N):
    """log_price = 随机游走趋势(I(1)) + OU 平稳偏离(唯一可预测源)"""
    rng = np.random.default_rng(seed)
    x = np.zeros(n)
    for t in range(1, n):
        x[t] = (1 - THETA) * x[t - 1] + SIG_X * rng.standard_normal()
    trend = np.cumsum(DRIFT + SIG_T * rng.standard_normal(n))
return np.log(100.0) + trend + x, x结果很干脆:原始对数价格 ADF p=0.606(不平稳,符合预期);一阶差分 ADF p≈0(平稳),但它与原序列的相关系数只有 0.005,与真实 OU 偏离 的相关系数只有 0.073。它把唯一有用的东西一起扔了。
二、分数阶差分:把 d 从整数放开到实数#
分数阶差分的想法出奇简单:既然 砍太狠、 又不平稳,那就让指数 取实数。用二项式展开:
权重可以递推生成,这是整个方法的核心,四行代码:
def frac_weights(d, size):
    w = [1.0]
    for k in range(1, size):
        w.append(-w[-1] * (d - k + 1) / k)
return np.array(w)关键性质在于权重的衰减速度:
- :权重是 ——只用两期,记忆长度为 1
- :权重是 ——原序列照抄,记忆无限长但不平稳
- :权重呈双曲衰减(比指数慢得多),拖着一条长尾,这条尾巴就是”记忆”
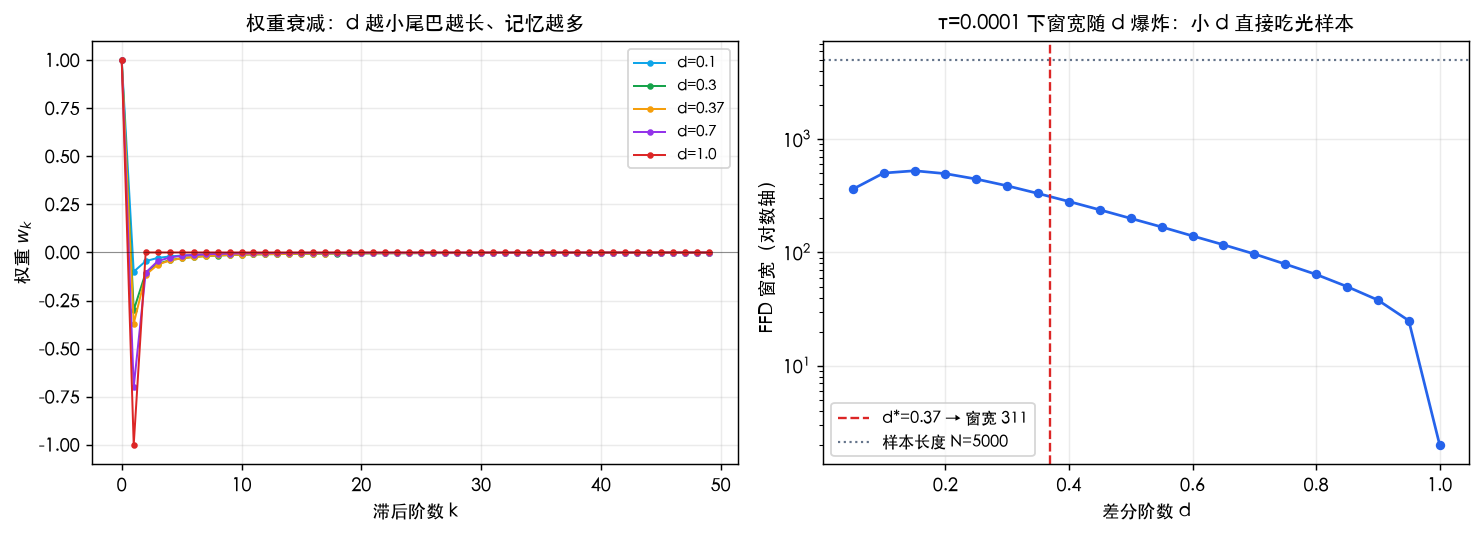
右图已经埋下了第一个坑:权重理论上是无穷长的,实务必须截断。López de Prado 的 FFD(Fixed-Width Window Fracdiff) 做法是设一个阈值 τ,丢掉所有 的尾部:
TAU = 1e-4

def frac_weights_ffd(d, tau=TAU, max_size=20000):
    w, k = [1.0], 1
    while k < max_size:
        x = -w[-1] * (d - k + 1) / k
        if abs(x) < tau:
            break
        w.append(x); k += 1
    return np.array(w)

def frac_diff_ffd(series, d, tau=TAU):
    """FFD:等长输出,前 width-1 个为 NaN(保证每个点用同样多的历史)"""
    w = frac_weights_ffd(d, tau)
    width = len(w)
    out = np.full(len(series), np.nan)
    if width <= len(series):
        out[width - 1:] = np.convolve(series, w, mode="valid")
return out, width注意 mode="valid" 加前置 NaN 这个写法:它保证每个输出点都用了完全相同数量的历史,不会出现前面几点用 5 期、后面用 500 期的情况——这正是 FFD 相对”扩张窗口”版本的核心改进,第五节会看到两者差多远。
三、扫描 d:平稳性与记忆的权衡曲线#
现在做那件标准操作:从 d=0 扫到 d=1,每一档同时记录 ADF 统计量(平稳性)和”与原序列的相关系数”(记忆保留)。
from statsmodels.tsa.stattools import adfuller

for d in np.round(np.arange(0.0, 1.0001, 0.05), 2):
    ffd, width = frac_diff_ffd(logp, d)
    a = ffd[~np.isnan(ffd)]
    stat, p = adfuller(a, regression="c", autolag="AIC")[:2]
    corr = np.corrcoef(ffd[~np.isnan(ffd)], logp[~np.isnan(ffd)])[0, 1]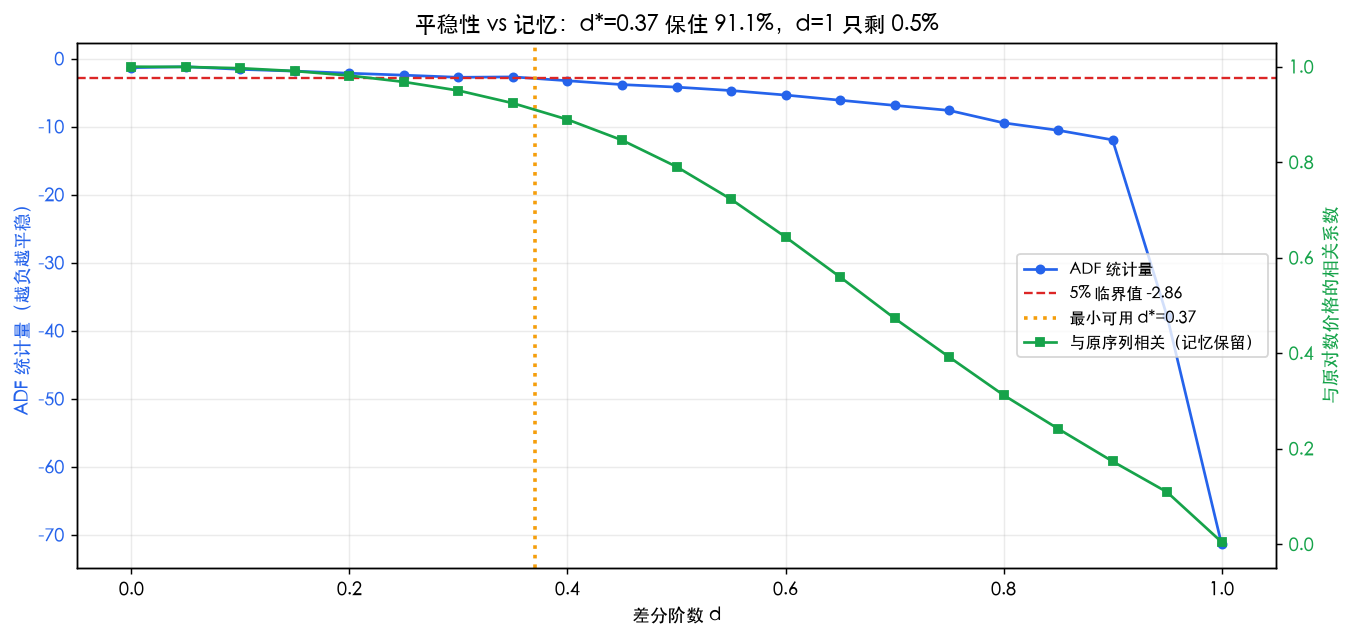
这张图是分数阶差分的招牌:ADF 统计量随 d 增大单调下降(越来越平稳),记忆保留随 d 增大单调下降(越来越少)。最小可用 d* 就是刚好穿过 5% 临界值那个点:
| 差分阶数 | ADF 统计量 | ADF p 值 | 与原序列相关(记忆) | FFD 窗宽 |
|---|---|---|---|---|
| d=0(原始) | -1.34 | 0.606 | 1.000 | 1 |
| d=0.37* | -2.96 | 0.039 | 0.911 | 311 |
| d=1(一阶差分) | -71.4 | ~0 | 0.005 | 2 |
看上去完美:只付出 8.9% 的记忆损失就换来平稳性,而传统做法要付 99.5%。
但先别急着高兴。 这张漂亮的权衡曲线有一个致命前提——它假设 ADF 通过就等于”真的平稳”。下一节我要证明这个前提在 FFD 下经常是错的。
四、最硬的坑:截断本身就会伪造平稳性#
这是本文的核心发现,也是绝大多数分数阶差分教程不会告诉你的。
做一个对抗式实验:拿一条真实 I(1) 的纯随机游走(我知道它绝对不平稳,因为是我生成的),对它做完全一样的 d=0.37 分数阶差分,然后看 ADF 检验怎么说。理论上 ADF 应该只有 5% 的概率错误拒绝原假设。
def make_rw(seed, n=N):
    rng = np.random.default_rng(seed)
    return np.log(100.0) + np.cumsum(DRIFT + 0.017 * rng.standard_normal(n))

for tau in [1e-2, 3e-3, 1e-3, 3e-4, 1e-4, 3e-5, 1e-5]:
    ps = []
    for sd in range(30):                       # 30 个独立随机游走
        f, W = frac_diff_ffd(make_rw(5000 + sd), 0.37, tau=tau)
        ps.append(adfuller(f[~np.isnan(f)], regression="c", autolag="AIC")[1])
    print(f"窗宽 W={W:5d}  错误拒绝率={np.mean(np.array(ps) < 0.05):.0%}")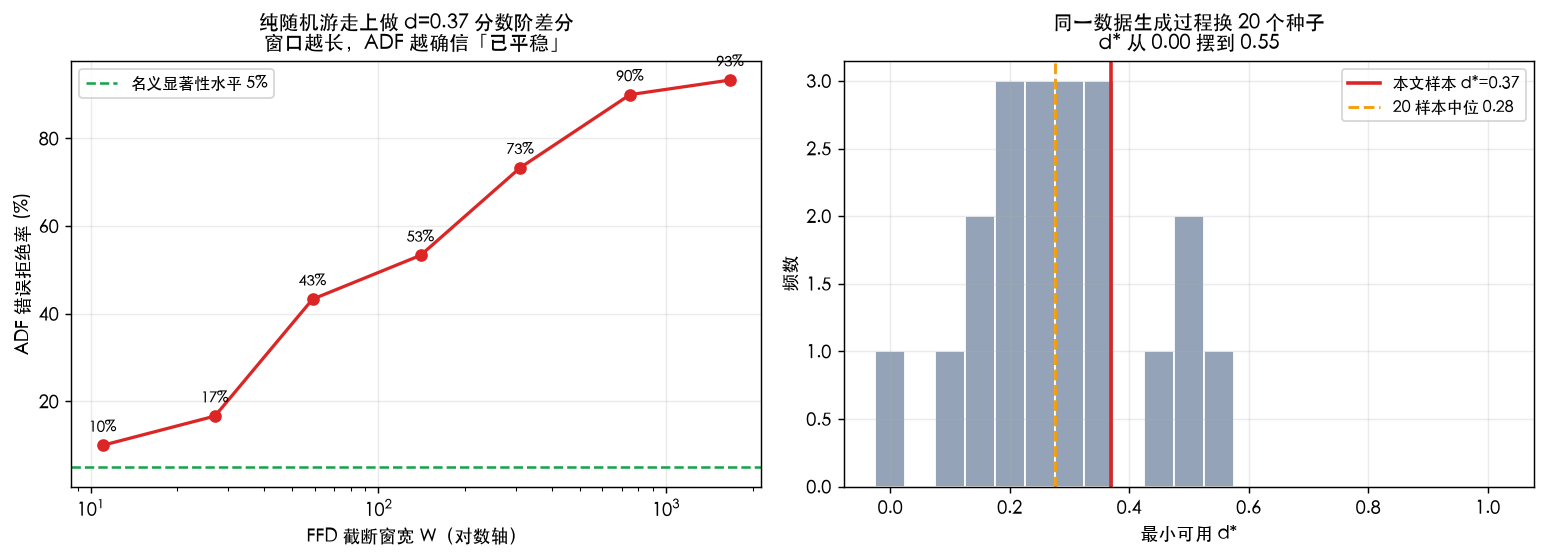
结果触目惊心:
| FFD 窗宽 W | ADF 错误拒绝率 | 名义水平 |
|---|---|---|
| 11 | 10% | 5% |
| 59 | 43% | 5% |
| 140 | 53% | 5% |
| 311(本文主设定) | 73% | 5% |
| 749 | 90% | 5% |
| 1669 | 93% | 5% |
在一条百分之百的随机游走上,窗宽 311 的 FFD 让 ADF 有 73% 的概率宣布”已平稳”。 这不是随机波动,是系统性偏误。
机制不难理解:FFD 的截断权重和不等于零(真正的 展开需要无穷项才收敛),截断后的滤波器在低频段留了一个有限增益,等效于对原序列做了一次带通滤波——滤掉了单位根那个最低频成分。ADF 看到的已经不是原序列,而是被人为削掉低频的版本,当然更容易判平稳。窗口越长,截断权重越接近完整展开,低频压制越彻底,伪平稳就越严重。
这直接推翻了”扫 d 找最小可用 d*“这个流程的可靠性。右图给出第二记重击:同一个数据生成过程,只换随机种子,跑 20 次,d* 从 0.00 一直摆到 0.55,标准差 0.138。 你在自己数据上辛苦扫出来的 d*=0.37,很大程度上是这一次抽样的运气,不是数据的内在属性。
五、FFD vs 扩张窗口:同一个 d,两条完全不同的序列#
LdP 原书给了两个版本:扩张窗口(expanding,权重不截断,可用历史全用上)和 FFD(固定宽度)。很多人以为它们只是实现细节的差别。
def frac_diff_expanding(series, d, tau=TAU):
    n = len(series)
    w = frac_weights(d, n)
    skip = len(frac_weights_ffd(d, tau))
    out = np.full(n, np.nan)
    for t in range(skip, n):
        out[t] = np.dot(w[:t + 1][::-1], series[:t + 1])
return out在同一条序列、同一个 d=0.37 下,两者的相关系数是 -0.10——不是 0.99,是接近正交甚至微负。
原因是扩张窗口的每个点用的历史长度不同(t=500 时用 500 期,t=4999 时用 4999 期),等于对不同时点施加了不同的滤波器,序列的方差结构随时间系统性变化(后半段/前半段标准差比 0.63)。它算出来的东西严格来说不是一个同分布的特征。
实务结论:永远用 FFD,不要用扩张窗口。如果你在复现别人的分数阶差分结果时数字对不上,先确认对方用的是哪个版本。
六、预测力检验:d* 到底值不值这些麻烦#
平稳性只是手段,能不能预测才是目的。把四种特征(d=0 / d*=0.37 / d=1 / oracle 真实 )分别做样本内 6:4 切分、样本内定系数、样本外应用:
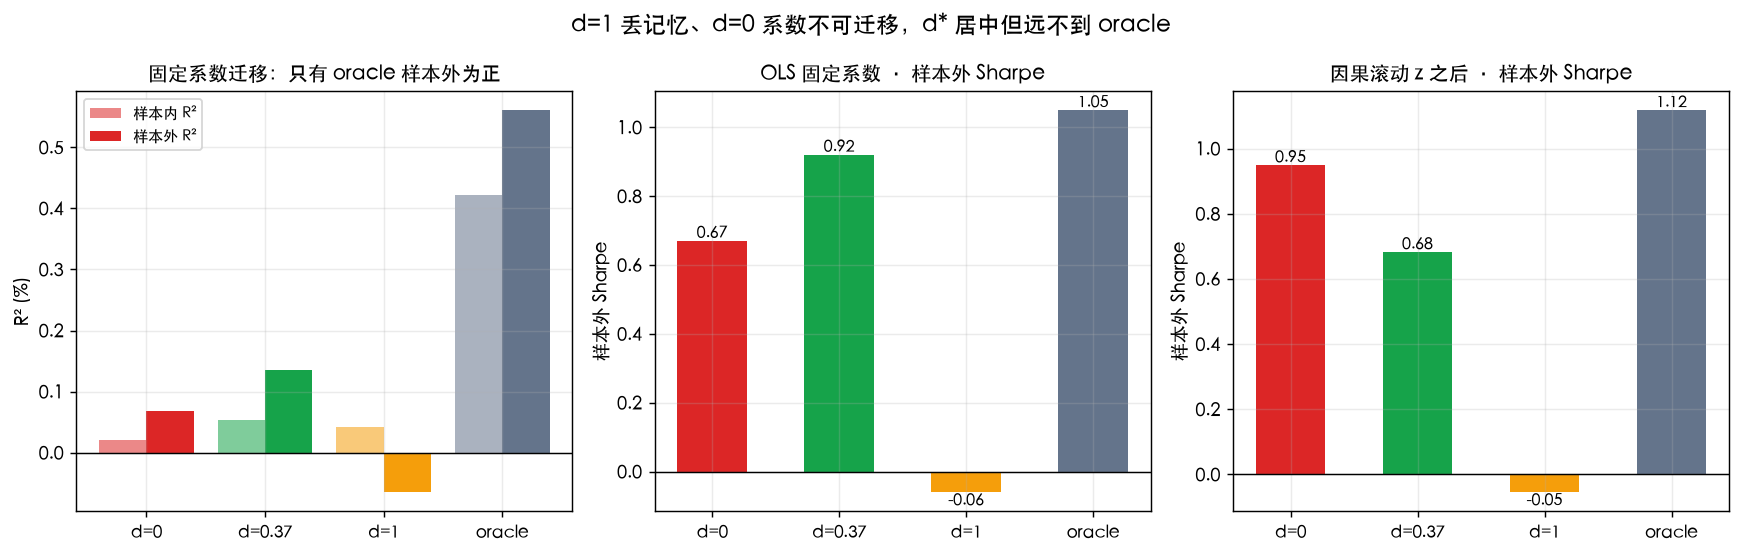
| 特征 | 样本外 R² | OLS 样本外 Sharpe | 滚动 z 样本外 Sharpe | 与真实 相关 |
|---|---|---|---|---|
| d=0(原始价格) | 0.0007 | 0.67 | 0.95 | 0.367 |
| d=0.37* | 0.0014 | 0.92 | 0.68 | 0.416 |
| d=1(一阶差分) | -0.0006 | -0.06 | -0.05 | 0.073 |
| oracle(真实 ) | 0.0056 | 1.05 | 1.12 | 1.000 |
三个诚实的观察:
1. 一阶差分确实是废的。 Sharpe -0.06、与真实可预测成分相关 0.073——它把 alpha 连根拔了,这一点分数阶差分的批评完全成立。
2. d* 在固定系数场景下确实最好(0.92 vs 0.67)。 因为 d=0 的原始价格不平稳,样本内估的系数拿到样本外时价格水平已经漂走了,系数失效;d* 平稳,系数可迁移。这是分数阶差分的真实价值所在。
3. 但一旦你用因果滚动 z 做标准化,d=0 反而更好(0.95 vs 0.68)。 这是必须说破的一点:滚动 z 本身就是一种隐式差分——减去滚动均值这个动作,已经把非平稳的水平漂移消掉了。如果你的流程后面本来就有滚动标准化,分数阶差分带来的增量就非常有限,甚至是负的。
所以分数阶差分不是万能钥匙。它真正有价值的场景是:你要把特征直接喂给一个固定系数的模型(线性回归、需要跨期可比输入的树模型),且流程里没有其他去均值机制。
七、四项对抗式检验#
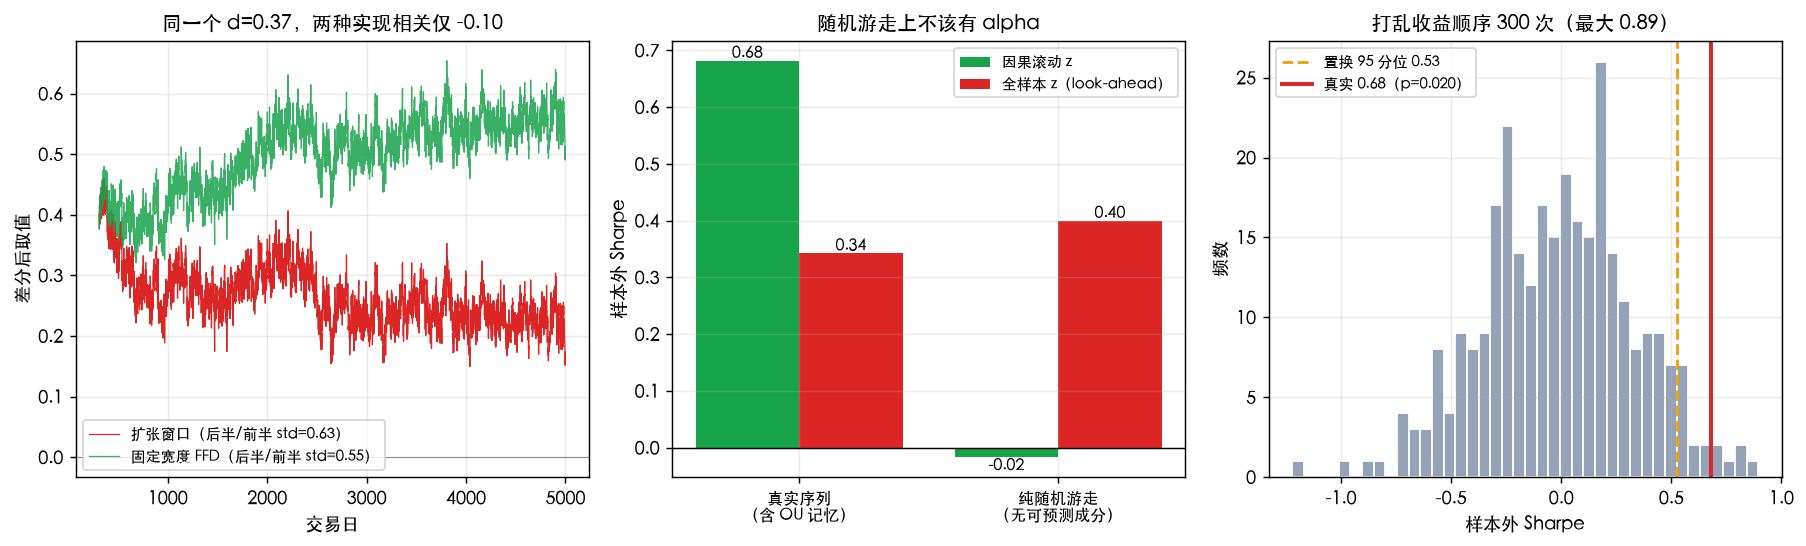
检验一:纯随机游走上不该有 alpha。 对 d=0.37 的 FFD 特征在随机游走上跑同一套因果滚动 z 策略,样本外 Sharpe = -0.02,干净归零。策略逻辑本身没有偷看未来。
检验二:look-ahead 对照。 把因果滚动 z 换成全样本均值/标准差做 z(一个非常隐蔽的 look-ahead),随机游走上的 Sharpe 从 -0.02 跳到 0.40——凭空造出 alpha。这也解释了为什么真实序列上 look-ahead 版本(0.34)反而低于因果版本(0.68):全样本标准化在有趋势的序列上会把信号方向搅乱,它不是”更好的作弊”,只是”另一种错”。任何标准化都必须因果。
检验三:置换检验。 打乱收益顺序 300 次重跑,真实 Sharpe 0.68 超过置换分布 95 分位 0.53,经验 p 值 0.020。但注意最大值到了 0.89——这说明这个 alpha 虽然显著,但离”稳如泰山”还很远。
检验四:τ 敏感性。 同一个 d=0.37,τ 从 1e-2 调到 1e-5:
| τ | 窗宽 | 记忆保留 |
|---|---|---|
| 1e-2 | 11 | 0.998 |
| 1e-3 | 59 | 0.984 |
| 1e-4 | 311 | 0.911 |
| 1e-5 | 1669 | 0.292 |
| 1e-6 | 8960 | 样本不足,全 NaN |
记忆保留从 99.8% 一路掉到 29.2%,而 d 完全没变。 这意味着”d=0.37 保留了 91% 记忆”这句话严格来说是不完整的——它只在 τ=1e-4 下成立。报告分数阶差分结果时,d 和 τ 必须同时给出,只给 d 等于没给。
八、五条实务准则#
1. d 和 τ 是一对超参数,不是一个。 只报 d 无法复现。窗宽 W 才是真正决定滤波器形态的量,建议直接报 (d, τ, W) 三元组。
2. 别把 ADF 通过当作平稳性的证明。 在你的真实数据上,先做本文第四节那个实验:用同样的 (d, τ) 对一条模拟随机游走做 FFD,看 ADF 错误拒绝率。如果超过 20%,你的 ADF 结论就不可信,需要改用对截断更稳健的检验(如 KPSS 双向确认,或直接看方差比检验)。
3. d* 不稳定,别精调。 20 个种子的 d* 标准差 0.138。与其花力气把 d 优化到小数点后两位,不如固定一个经验值(0.3–0.5 是常见区间)并做敏感性检查——如果结论在 d=0.3 和 d=0.5 之间会翻转,那这个结论本身就不可信。
4. 只用 FFD,不用扩张窗口。 同一个 d 下两者相关 -0.10,不是同一个东西。
5. 先问流程里有没有别的去均值机制。 如果后面接滚动 z、截面排序、分位数分桶,非平稳性其实已经被处理掉了,分数阶差分的增量可能是负的(本文 0.68 vs 0.95)。它的主场是固定系数、跨期可比的输入。
结语#
分数阶差分的核心洞察是对的:整数阶差分是一把过钝的刀,在平稳性和记忆之间存在一整条连续的权衡曲线,而 d=1 是这条曲线上最极端、往往也最浪费的一点。本文的数据支持这个判断——d*=0.37 保住 91.1% 记忆并通过 ADF,捕捉真实可预测成分的相关系数 0.416,是一阶差分(0.073)的近 6 倍,固定系数场景下样本外 Sharpe 0.92 对 -0.06。
但它同时是一个比看起来脆弱得多的工具:截断窗口会在纯随机游走上伪造 73% 的 ADF 拒绝率,d* 跨样本标准差 0.138,τ 的一档变化能让记忆保留从 99.8% 掉到 29.2%,两种实现版本的相关系数只有 -0.10。这些都不是”实现细节”,而是会直接改变结论符号的东西。
下次有人跟你说”我做了分数阶差分,ADF 通过了”,正确的追问只有三个:τ 是多少,窗宽多少,你在随机游走上验过错误拒绝率吗。 前两个答不上来,结果不可复现;第三个答不上来,那个”通过”多半是截断变出来的。