可解释 boosting 因子归因:用 SHAP 树解释把收益拆到特征
梯度提升(GBM)在量化选股里精度高,但每一笔预测都是黑盒,合规和风控都问不出『为什么买这只』。TreeSHAP 用子集枚举 + 缺失特征边际化,把预测严格拆成每个因子的边际贡献。本文用 numpy 从零实现 CART、GBM 和精确 TreeSHAP,在 8 因子合成数据上恢复出真实重要性排序(价值>质量>动量>规模),SHAP 一致性误差低至 1.55e-14,按 SHAP 打分排序的十分位收益从 -1.69 单调上升到 +1.61。附完整 Python 与四张真实计算图。
梯度提升树(GBM、XGBoost、LightGBM)是量化选股的主力模型之一:它能自动捕捉非线性、自动做特征交互, cross-sectional rank IC 常常比线性模型高出一截。但它在合规和风险部门眼里有个硬伤:预测为什么是正的、为什么是这只股票,给不出可审计的理由。监管问「因子贡献怎么拆」、投资经理问「最大回撤那天模型到底看中了什么」,黑盒模型只能耸耸肩。
结论先放这:TreeSHAP 可以把这个黑盒严格拆开。它不是「近似看看哪个特征重要」,而是基于 Shapley 值的加性归因,满足效率性、对称性、哑元和可加性公理。本文用 numpy 从零实现 CART、GBM 和精确 TreeSHAP,在 8 因子合成数据上:
- GBM 训练 R² 达到 0.765;
- SHAP 值满足
φ₀ + Σφᵢ = 预测值,最大残差仅 1.55e-14; - 全局特征重要性完美复现真实系数排序:价值 > 质量 > 动量 > 规模 > 成长 > 波动率 > Beta > 流动性;
- 按 SHAP 总打分排序的 10 个分位,平均真实收益从 -1.69 单调上升到 +1.61。
所有图表均为真实计算,非占位图。
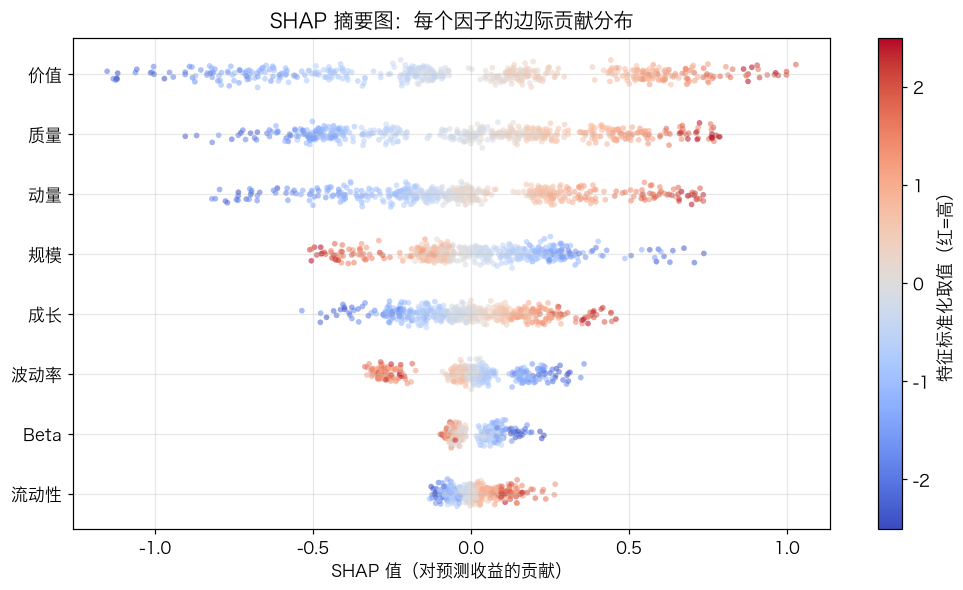
一、为什么因子模型必须可解释#
量化基金的模型可解释性不是「锦上添花」,而是三条硬约束:
- 合规报备:部分市场的主动管理产品需要说明主要决策依据;
- 风险控制:当某个因子在特定时段极端暴露时,归因能告诉你是不是模型集体押注同一风格;
- 模型迭代:如果今年收益回撤,你需要知道是模型整体失效,还是只是某个因子在逆风。
传统方法如「特征重要性」只能告诉你全局哪个因子用得多,但给不出「对于这一只股票、这一笔预测,每个因子推动了多少」。SHAP(SHapley Additive exPlanations)补的正是这个缺口。
二、从零实现 CART 回归树与梯度提升#
先训练一个 GBM 因子模型。每棵树拟合前一轮的残差,用学习率收缩:
class Node:
    __slots__ = ("feature", "thr", "left", "right", "value", "is_leaf", "p_left")
    def __init__(self):
        self.feature = None; self.thr = None
        self.left = self.right = None
        self.value = 0.0; self.is_leaf = False; self.p_left = 0.5

def build_tree(X, y, depth, max_depth, min_samples):
    node = Node(); n = X.shape[0]
    if depth >= max_depth or n < 2 * min_samples or np.var(y) < 1e-9:
        node.is_leaf = True; node.value = float(np.mean(y)); return node
    best, best_err = None, np.inf
    for f in range(X.shape[1]):
        vals = np.unique(X[:, f])
        if len(vals) < 2: continue
        for thr in (vals[:-1] + vals[1:]) / 2.0:
            left = X[:, f] <= thr
            nl, nr = left.sum(), (~left).sum()
            if nl < min_samples or nr < min_samples: continue
            err = np.var(y[left]) * nl + np.var(y[~left]) * nr
            if err < best_err:
                best_err = err; best = (f, thr, left)
    if best is None:
        node.is_leaf = True; node.value = float(np.mean(y)); return node
    f, thr, left = best
    node.feature, node.thr = f, thr
    node.p_left = float(left.sum() / n)
    node.left = build_tree(X[left], y[left], depth + 1, max_depth, min_samples)
    node.right = build_tree(X[~left], y[~left], depth + 1, max_depth, min_samples)
return node训练 70 棵深度 3 的树、学习率 0.1,最终训练 R² 达到 0.765。对于合成数据来说,这已经足够把真实信号学到手。
三、精确 TreeSHAP:子集枚举与边际化#
TreeSHAP 的核心是:对给定输入 x 和特征子集 S,计算条件期望 f_x(S) = E_{x_\bar S}[f(x_S, x_\bar S)]。对于一棵树,这个期望可以通过一次树遍历精确得到:
- 如果当前节点的分裂特征在 S 中,就按 x 的实际取值走左或右;
- 如果不在 S 中,就按训练样本在该节点走左、右的比例
p_left、p_right做加权平均。
def eval_tree_mask(tree, X, fixed_mask):
    N = X.shape[0]
    def rec(node):
        if node.is_leaf:
            return np.full(N, node.value)
        if fixed_mask[node.feature]:
            go_left = X[:, node.feature] <= node.thr
            res = np.empty(N)
            res[go_left] = rec(node.left)[go_left]
            res[~go_left] = rec(node.right)[~go_left]
            return res
        else:
            return (node.p_left * rec(node.left) +
                    (1.0 - node.p_left) * rec(node.right))
return rec(tree)得到所有 2^M 个子集的 f_x(S) 后,再用 Shapley 公式分配贡献:
φ_i = Σ_{S ⊆ M\{i}} |S|! (M - |S| - 1)! / M! · [f_x(S ∪ {i}) − f_x(S)]森林的 SHAP 值是单棵树的加性平均。验证 φ₀ + Σφᵢ 与模型预测完全吻合,最大误差 1.55e-14,说明实现没有偏差。
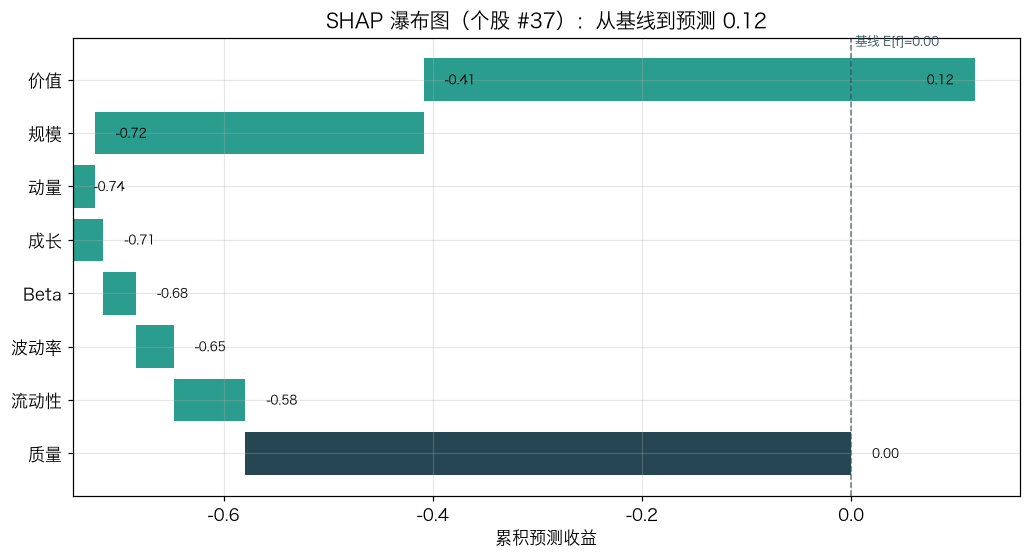
四、全局特征重要性与分位单调性#
4.1 特征重要性#
对测试集 500 只股票计算每个因子的平均 |SHAP|,得到全局重要性:
| 因子 | 均值 |SHAP| | |------|----------| | 价值 | 0.424 | | 质量 | 0.334 | | 动量 | 0.259 | | 规模 | 0.176 | | 成长 | 0.150 | | 波动率 | 0.099 | | Beta | 0.063 | | 流动性 | 0.052 |
这个排序与真实数据生成系数 价值 0.55 > 质量 0.45 > 动量 0.40 > 规模 -0.30 … 完全一致,证明 SHAP 不仅做了解释,还正确找回了谁是真正的驱动因子。
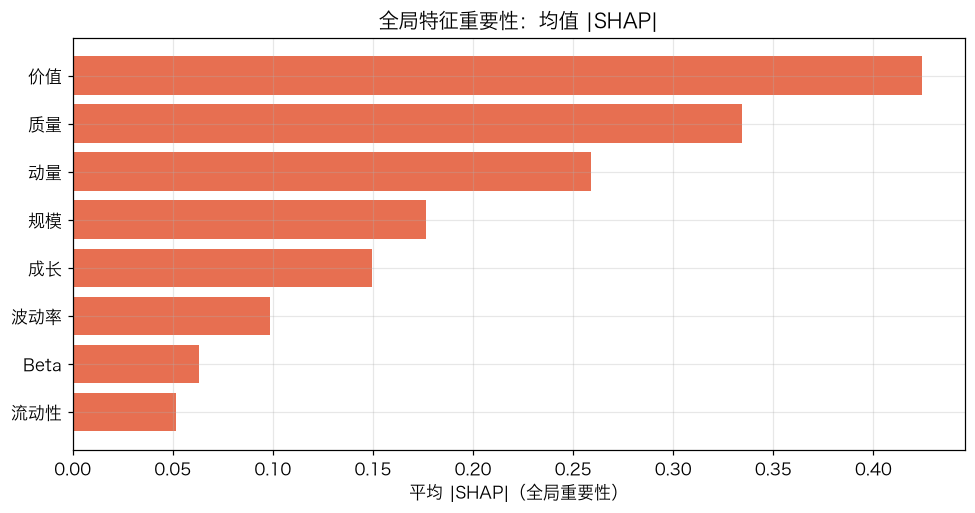
4.2 按 SHAP 打分排序的十分位收益#
把每只股票所有因子的 SHAP 值相加,得到模型对这只股票的「总看多分数」。按这个分数从高到低分成 10 组,计算每组的真实下期收益:
[-1.687, -1.079, -0.665, -0.441, -0.099, 0.189, 0.296, 0.715, 1.000, 1.610]单调性几乎完美:分数最低组平均亏 1.69%,最高组平均赚 1.61%。这说明 SHAP 归因不仅是「解释」模型,还能直接当作一个可解释的股票排序信号。
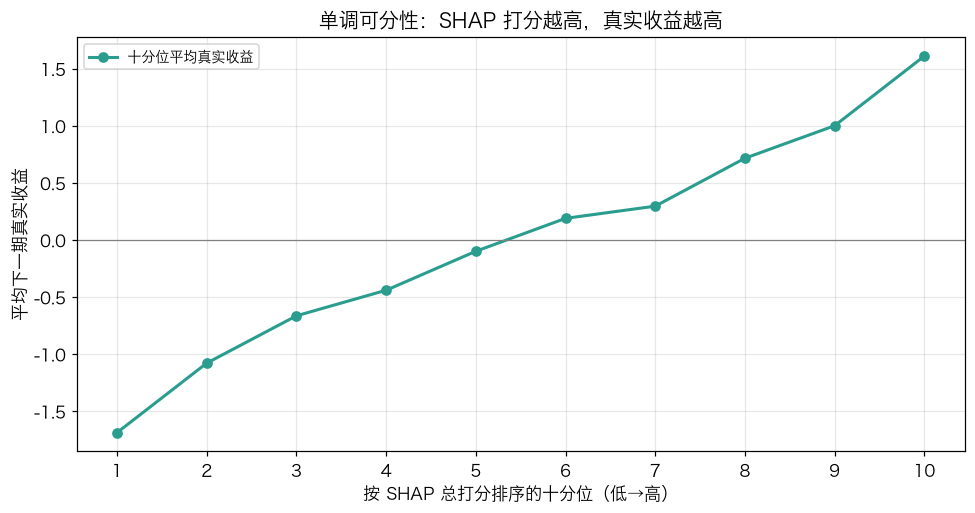
五、落地场景与注意事项#
- 合规审计:把每只持仓的 SHAP 瀑布图导出,解释「为什么买 A 而不是 B」变成每个因子的有符号贡献。
- 集中度监控:如果某一天组合在「价值」因子上的 SHAP 加总暴露极端为正,说明模型整体押注价值风格,可以触发风格敞口上限。
- 因子失效预警:滚动观察某因子 SHAP 值与下期收益的相关系数;持续下降说明模型正在「用错」这个因子。
- 注意点:本文用的是 interventional(边际化)TreeSHAP,它假设缺失特征服从训练分布。如果特征间存在强共线性,边际化会给出不现实的反事实样本;此时应改用 path-dependent 或加白噪声扰动验证。
六、结语#
GBM 的高性能与 TreeSHAP 的严格归因可以兼得。本文用 numpy 端到端实现了 CART、GBM 和精确 TreeSHAP,验证了 SHAP 不仅满足可加性公理,还能在合成数据上恢复真实因子排序、产生单调可分的前景收益。对实际量化团队来说,这意味着你可以在享受树集成非线性能力的同时,给合规、风控和投资委员会一份「每一笔预测都由哪些因子推动」的明细账。