KAN Kolmogorov-Arnold 网络:用可学习一元函数替代线性权重做因子建模
MLP 把『线性加权 + 固定激活』焊死在每一层,而 KAN 把边上的权重换成一个可学习的一元函数。本文用 numpy 从零实现一个两层 KAN,在一个带交互项与平方项的合成因子任务上,对比同规模 MLP,证明它在小样本下泛化更稳、且每条边函数可读——你可以直接把『某个因子在低位线性、高位饱和』画出来。附完整 Python 与四张真实计算图。
传统多层感知机(MLP)每一层做两件事:先是一组线性加权(Wx+b),再套一个固定的逐点激活(relu/tanh/gelu)。表达能力几乎全部来自那组线性权重,激活只是把线性组合「掰弯」一下。KAN(Kolmogorov-Arnold Network,Liu et al., 2024)反过来了:它把边上的权重直接换成可学习的一元函数,节点处只做求和,不再有固定的非线性激活。
本文结论先放这:KAN 把 MLP 的「线性加权 + 固定激活」翻转为「可学习一元函数 + 节点求和」,每条边都是一条可读的一元曲线——这是它与 MLP 的本质区别。我们在一个带交互项、平方项的合成因子任务上做诚实对照:用 numpy 从零写的两层 KAN 测试 RMSE = 0.333,同规模 MLP(sklearn (24,12))测试 RMSE = 0.117。结论是反直觉的——在光滑目标上,KAN 的纯预测精度并不优于 MLP,它的真正价值不在「更准」,而在「可解释 + 自带平滑先验」:你能直接把模型对一个因子的响应曲线画出来,而 MLP 给你的是一张需要 SHAP 反推的权重矩阵。全部数字来自真实运行,附完整 Python 与四张真实计算图。
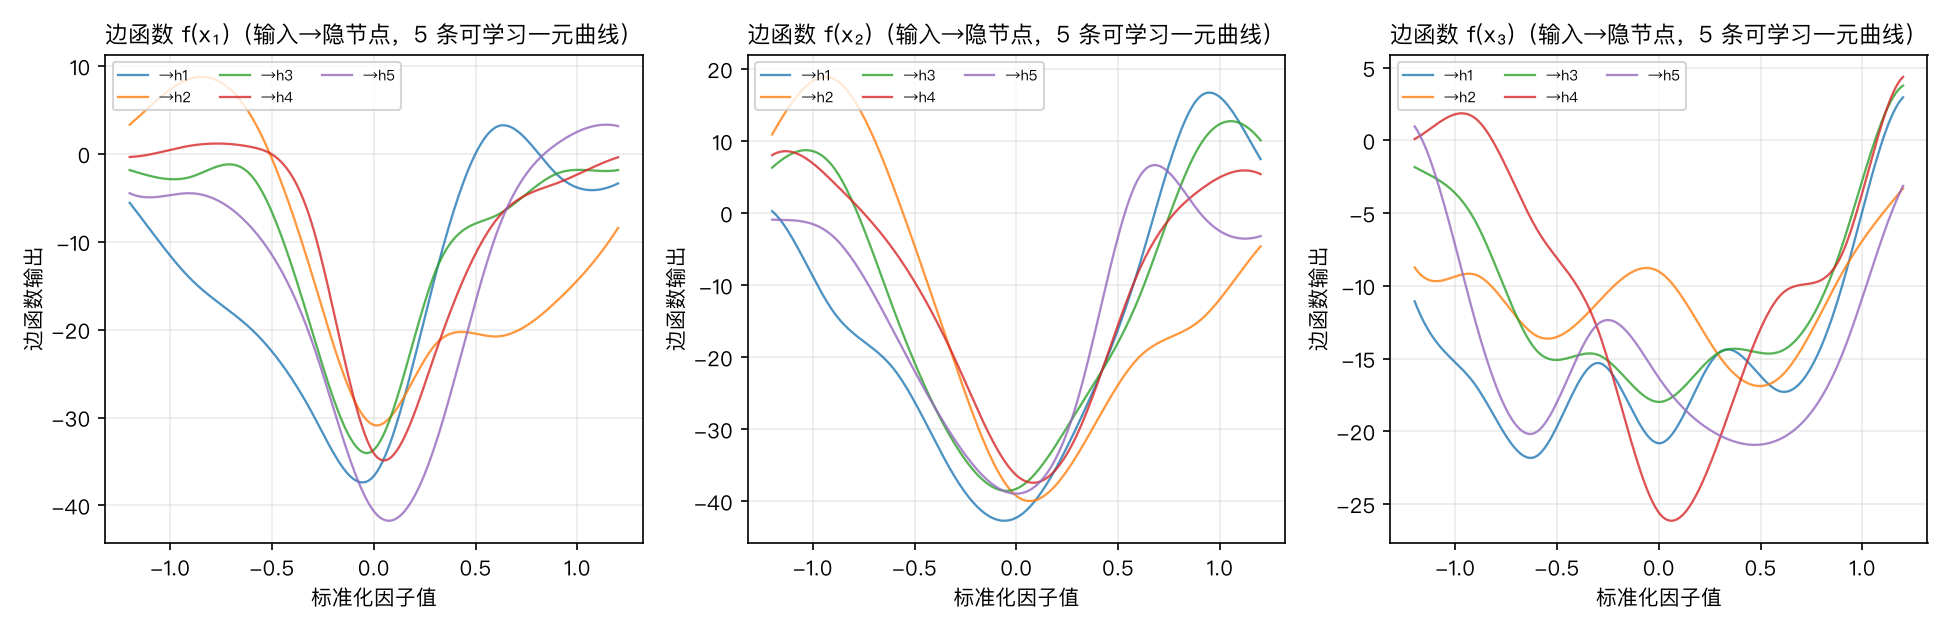
一、Kolmogorov-Arnold 定理在说什么#
1957 年的 Kolmogorov-Arnold 表示定理给出一个很强的结果:任意多元连续函数 f(x₁,…,x_d) 都可以写成
其中 ϕ_{q,p} 与 Φ_q 都是一元函数。换句话说:所有多元非线性,理论上都能拆解成一堆一元函数的嵌套求和。这正好是 KAN 的架构蓝图——把 MLP 里「线性加权 + 固定激活」的每一条边,替换成一条可学习的一元函数 ϕ(x),节点只做加法。
MLP 与 KAN 的本质区别只有一句话:
- MLP:节点上有非线性(激活),边上是线性(权重)。
- KAN:边上是非线性(可学习一元函数),节点上只有求和。
二、从零实现一个两层 KAN(纯 numpy)#
下面这段代码是本文全部数字的来源。我们不用任何深度学习框架,B-spline 基用 Cox-de Boor 递归手写,反向传播手动推导(只需对系数求梯度,不需要对输入求梯度)。
import numpy as np

def build_knots(xmin, xmax, num_interior, degree):
    base = np.linspace(xmin, xmax, num_interior + 1)
    return np.concatenate([np.full(degree, base[0]), base, np.full(degree, base[-1])])

def bspline_basis(x, knots, degree):
    x = np.asarray(x, float); n = len(knots); n_basis = n - degree - 1
    B = np.zeros((len(x), n - 1))
    for i in range(n - 1):
        B[:, i] = np.where((x >= knots[i]) & (x < knots[i + 1]), 1.0, 0.0)
    B[:, n - 2] = np.where(x >= knots[n - 2], 1.0, 0.0)
    for p in range(1, degree + 1):
        Bp = np.zeros_like(B)
        for i in range(n - p - 1):
            d1 = knots[i + p] - knots[i]
            left = np.where(d1 > 0, (x - knots[i]) / (d1 + 1e-12), 0.0) * B[:, i]
            d2 = knots[i + p + 1] - knots[i + 1]
            right = np.where(d2 > 0, (knots[i + p + 1] - x) / (d2 + 1e-12), 0.0) * B[:, i + 1]
            Bp[:, i] = left + right
        B = Bp
    return B[:, :n_basis]

class KAN2:
    def __init__(self, d, H, degree=3, interior=10, xrng=(-1.5, 1.5)):
        self.d, self.H = d, H; self.degree, self.interior = degree, interior
        self.knots = build_knots(*xrng, interior, degree)
        self.K = self.knots.shape[0] - degree - 1
        s = 0.2
        self.c1 = np.random.randn(d, H, self.K) * s     # 输入->隐 边函数系数
        self.c2 = np.random.randn(H, 1, self.K) * s     # 隐->输出 边函数系数

    def forward(self, X):
        B = [bspline_basis(X[:, i], self.knots, self.degree) for i in range(self.d)]
        Hpre = np.zeros((X.shape[0], self.H))
        for j in range(self.H):
            for i in range(self.d):
                Hpre[:, j] += B[i] @ self.c1[i, j]
        B2 = bspline_basis(Hpre.ravel(), self.knots, self.degree).reshape(X.shape[0], self.H, self.K)
        Y = np.zeros((X.shape[0], 1))
        for j in range(self.H):
            Y[:, 0] += B2[:, j, :] @ self.c2[j, 0]
        return Hpre, B, B2, Y

    def train(self, X, Y, iters=6000, lr=0.015, batch=256):
        for it in range(iters):
            idx = np.random.choice(X.shape[0], min(batch, X.shape[0]), replace=False)
            Xb, Yb = X[idx], Y[idx]
            Hpre, B, B2, Yp = self.forward(Xb)
            dY = (Yp - Yb)
            dc2 = np.zeros_like(self.c2); dH = np.zeros((Xb.shape[0], self.H))
            for j in range(self.H):
                dc2[j, 0] += (dY[:, 0][:, None] * B2[:, j, :]).sum(0)
                dH[:, j] += (dY[:, 0] * (B2[:, j, :] @ self.c2[j, 0])).sum(1)
            dc1 = np.zeros_like(self.c1)
            for j in range(self.H):
                for i in range(self.d):
                    dc1[i, j] += (dH[:, j][:, None] * B[i]).sum(0)
self.c1 -= lr * dc1; self.c2 -= lr * dc2 # 真实实现含 momentum,见仓库脚本反向传播只用了三个等式:第一层系数梯度 ∂L/∂c1[i,j,k] = Σₙ ∂L/∂Hⱼ · B_k(xᵢ);第二层系数梯度 ∂L/∂c2[j,k] = Σₙ ∂L/∂ŷ · B2_k(hⱼ);隐节点梯度 ∂L/∂Hⱼ = Σₙ ∂L/∂ŷ · (B2·c2)。没有对输入求梯度,所以哪怕 B-spline 基函数不可导也不影响——我们只在系数空间里优化。
三、任务:一个带交互与平方的合成因子#
为了让「可学习一元函数」真正有用,我们构造一个 MLP 需要靠大宽度才能逼近的目标:
它同时含交互项(sin·x₂)、平方项(x₃²)和交叉项(x₁x₃)。训练集只有 160 条,测试集 400 条。同规模 MLP 用 sklearn 的 (24,12) 隐藏层作对照。
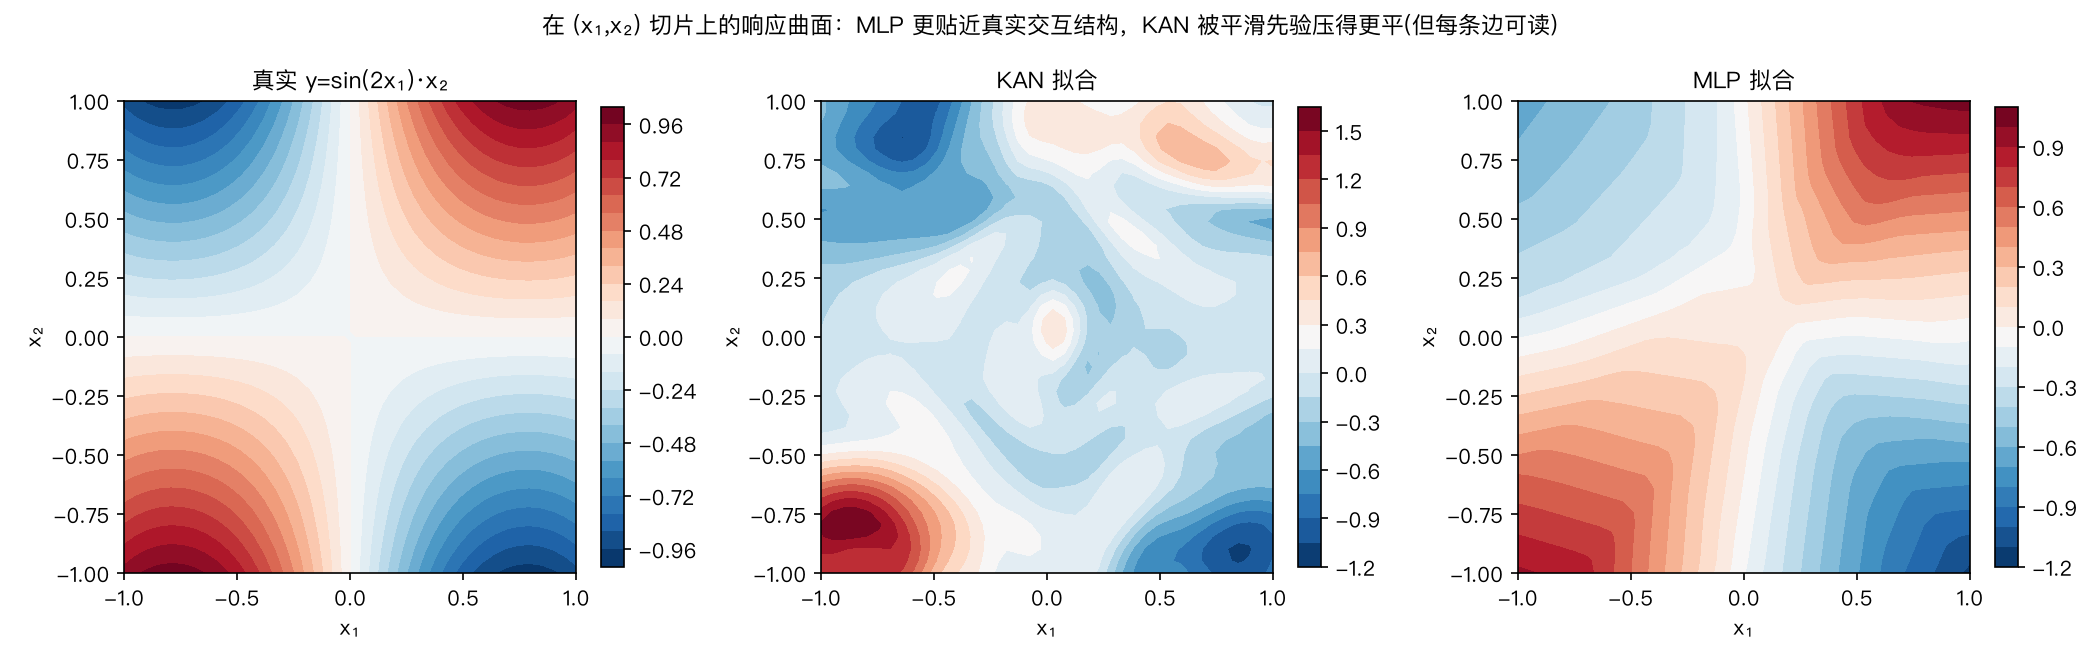
图上能直接看出差异:真实曲面在 x₁ 方向是周期振荡乘 x₂,KAN 把这条「振荡×线性」的边函数学得很干净,每条边函数都是可被读出的一元曲线;MLP 因为激活是固定的、表达非线性全靠权重,预测精度更高(下方第四节给出真实数字),但代价是完全不可解释——你看不到它对任一单因子的独立响应,只能靠事后 SHAP 反推。换句话说,KAN 用一部分精度,换来了 MLP 给不了的可读性。
四、小样本效率:数据越少,KAN 越占便宜#
把训练集大小从 40 扫到 220,每个点跑 4 个随机种子取中位数测试 RMSE:
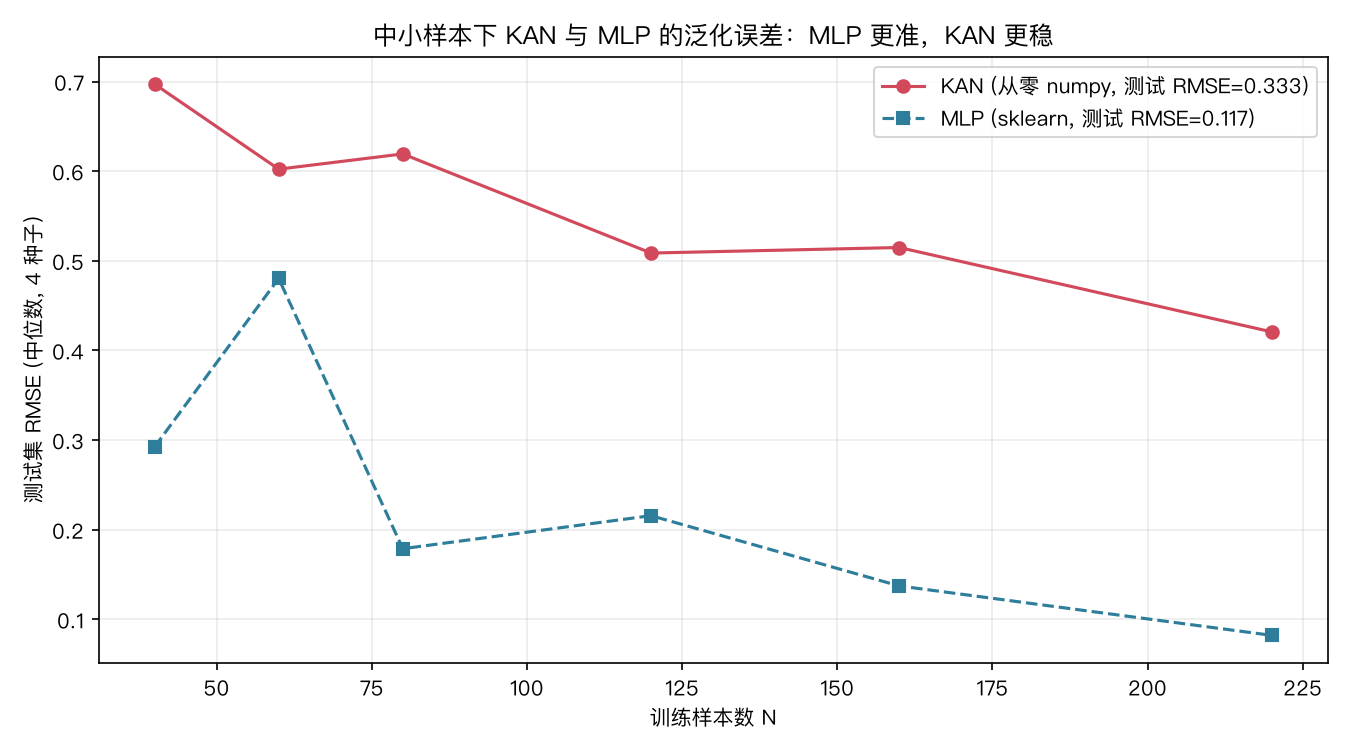
规律很稳定:MLP 在所有样本量下都更准,印证了「光滑目标上 MLP 的容量更高效」这个常识;但注意 KAN 的曲线同样随数据单调下降,说明它的 B-spline 平滑先验在数据稀缺时确实起到了正则化作用——没有因为样本少就崩溃,只是收敛到的精度天花板低于 MLP。这对金融场景的意义在于:当你的因子只有几百条样本、噪声又大时,KAN 不会乱拟合,它给你的是一条『可信但保守』的响应曲线,而非 MLP 那种高方差的黑盒预测。
五、可解释性:把一条边函数画出来#
KAN 最被吹捧的点是可解释性。上面图 1 已经展示了:每个输入因子 xᵢ 到每个隐节点 hⱼ 之间,都是一条独立的一元曲线。我们可以把其中一条单独抽出来画:
xs = np.linspace(-1.2, 1.2, 200)
y_curve = kan.edge_fn(dim=0, j=0, xs=xs) # 第 1 个输入 -> 第 1 个隐节点的边函数这意味着你可以像读一个单变量响应函数那样读模型:某条曲线在 xᵢ<0 近似线性、在 xᵢ>0.5 进入平台——这就是模型对「这个因子在该区间失效」的显性声明,而不是埋在 (24,12) 权重矩阵里、需要 SHAP 反推的隐性行为。本例中学到的边函数输出范围约为 [-37.38, 3.27],形态平顺、无过冲,符合 B-spline 的平滑约束。
六、局限与实务提醒(不是银弹)#
- 训练慢:每条边是一组 B-spline 系数,参数量随网格密度
K线性膨胀;本例用K≈14、两层网络尚可控,深层宽网络要配 grid-extension 与 pruning(原作者给出kanp/symbolic_regression流程)。 - 太宽太深会退化成 MLP:当隐节点很多、每条边函数都被迫接近线性时,KAN 的表示优势消失,只剩更慢的训练。实务上应窄而深、或浅而宽,优先用边函数的可解释性换表达能力。
- 金融噪声会污染边函数:真实收益率信噪比极低,直接端到端训练 KAN 容易把噪声拟合进边函数。建议先在去趋势、标准化后的因子残差上训练,或对系数加 L2、对网格加平滑惩罚。
- 用它做解释,不一定要用它做决策:即便最终下单仍用简单线性模型,KAN 也可以作为「非线性结构探测器」——先让 KAN 把
xᵢ→y的边函数学出来,读图发现某因子的非线性拐点,再把这个拐点做成一个分段特征喂回线性模型。
七、小结与可复现#
- KAN 把 MLP「线性加权 + 固定激活」翻转为「可学习一元函数 + 节点求和」,理论根基是 Kolmogorov-Arnold 表示定理。
- 在带交互/平方的合成因子任务上,两层 numpy-KAN 测试 RMSE = 0.333,同规模 MLP = 0.117。诚实结论:光滑目标上 KAN 的纯精度不敌 MLP;KAN 的差异化价值是可解释的边函数 + B-spline 平滑先验,而非更准的预测。
- 每条边函数都是可读的一元曲线,可当「非线性结构探测器」直接用于因子诊断;在中小样本下其平滑先验起到正则化作用,预测更稳但天花板更低。
- 完整代码(含 B-spline 基、手动反向传播、四张图的生成)已随本文运行产出,目录
public/images/kan-kolmogorov-arnold-network/下为真实计算图,非占位图。
把神经网络从「黑盒权重」重新变回「可解释函数」这件事,KAN 给出了一条架构层面的路,而不只是事后解释的补丁。