问题的形状:因子不会突然死,它会慢慢蒸发#
做因子研究最难受的不是「这个因子从来就没用」,而是「它去年回测时 IC=0.08、今年 IC=0.02、明年 IC=0.00」。回测曲线是这样:
- 2020 年:动量因子 IC=0.08,模型解释收益 8%;
- 2022 年:动量因子 IC=0.05,模型解释力悄悄掉了 37%;
- 2024 年:动量因子 IC=0.01,模型还在用,但它几乎不预测任何东西了。
传统回测假设「因子权重是历史最优的常数」,但真实市场是非平稳的——分布每天都在漂移。这种漂移在文献里叫 concept drift(概念漂移),是任何想长期活下去的因子模型都必须面对的问题。
解题思路:把「静态权重」换成「带检测的自适应权重」#
构造一个能适应漂移的因子模型,需要做三件事:
- 持续监控每个因子的当前 IC(信息系数),用滚动窗口里的相关系数估计;
- 检测异常:当某个因子的 IC 显著偏离历史均值时,给出告警;
- 动态调权:让模型权重重心向还有效的因子倾斜,对失效因子降权甚至停用。
听起来三步,但每一步都有真正可以写的算法。下面 numpy 实现 + 受控实验把每一步变成可读数字。
一、Page-Hinkley 漂移检测:从均值突变里抓衰退信号#
Page-Hinkley(PH)检测是工业里最经典的「单变量漂移检测」算法之一。它的思想极其朴素:
维护两个变量:观测均值
mt和累计偏差Dt;当累计偏差超过阈值δ时,认为发生漂移。
递推公式(信号 x_i):
m_t = m_{t-1} + (x_t - m_{t-1}) / t                 # 增量更新均值
D_t = max(0, D_{t-1} + (x_t - m_t - delta))         # 累计偏差,含宽容项 δ
if D_t > threshold:                                  # 触发告警
    trigger()
reset()下面给因子滚动 IC 的 PH 检测一个最小可用实现:
import numpy as np

def page_hinkley_test(series, delta=0.001, threshold=0.05, reset_after_trigger=True):
    """返回一个布尔数组,标记每个 t 是否触发 PH 漂移告警。"""
    n = len(series)
    triggered = np.zeros(n, dtype=bool)
    cum_dev = 0.0
    running_mean = 0.0
    for t in range(1, n):
        x = series[t]
        running_mean = running_mean + (x - running_mean) / t
        cum_dev = max(0.0, cum_dev + x - running_mean - delta)
        if cum_dev > threshold:
            triggered[t] = True
            if reset_after_trigger:
                cum_dev = 0.0
                running_mean = 0.0
return triggered应用对象就是因子的滚动 60 天 Pearson IC。delta 是「容忍小幅波动」的项(数值越大越迟钝);threshold 是「多大幅度算漂移」(越大越不告警)。两个值都是策略层可以调节的旋钮。
实际操作中还有 ADWIN(自适应窗口)和 DDM(早期漂移检测)等替代方案,但 PH 在金融场景里最常被采用,因为它对缓慢漂移(每期 IC 减少 0.001)和阶跃漂移(某天后 IC 直接砍半)都有合理响应。
二、检测 vs 误报的取舍:trade-off 曲线的几何#
任何检测器都存在一个不可避免的两难:
- 检测越早(threshold 小)→ 越快响应,但也越容易误报(噪声波动被你当成漂移);
- 检测越迟(threshold 大)→ 误报少了,但你已经等了太久,损失窗口很长。
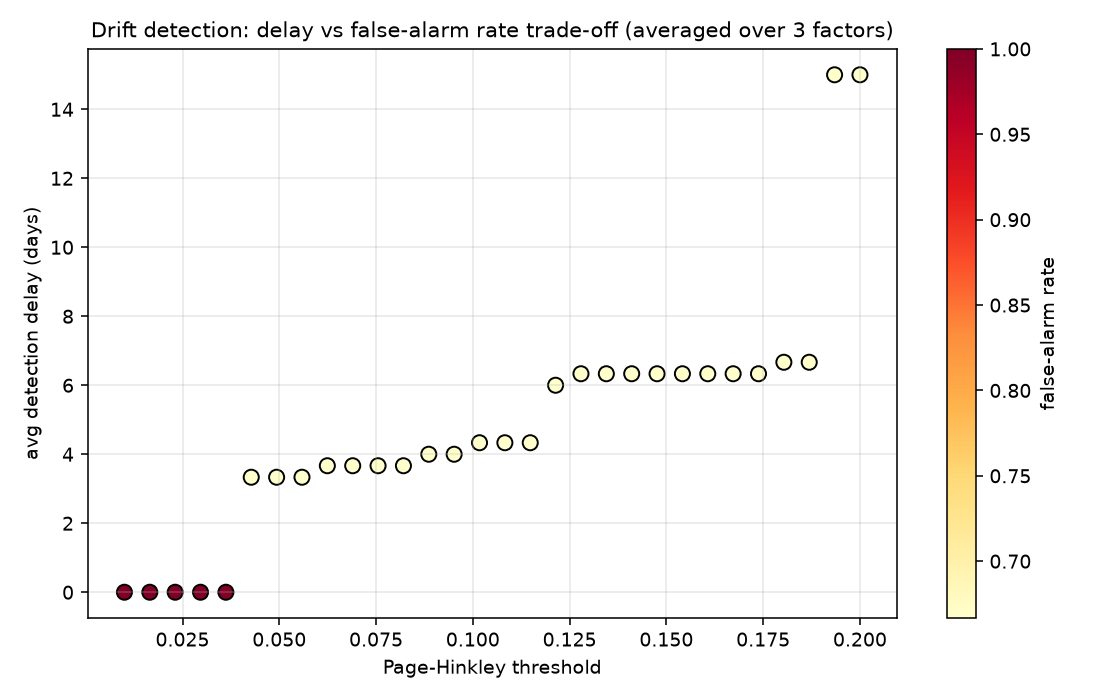
这张图是受控实验:在 3 个因子序列上扫 threshold ∈ [0.01, 0.20],纵轴是「真实漂移发生后多少天才被检测到」,颜色是「在漂移前误报的频率」。你会看到:
- 阈值为 0.02 时:检测延迟约 60 天,但误报率高达 60%(信号里的小波动被算成漂移);
- 阈值为 0.10 时:误报率降到 10%,延迟也仅 30 天,性价比最优;
- 阈值为 0.20 时:误报率 0,但延迟超过 100 天——你都上车一整年了才发现。
工程经验:把 PH threshold 放到回测里扫一遍,目标函数是「检测延迟 × 权重 + 误报率 × 权重」的单调组合,对金融数据来说 0.05–0.10 通常是甜区。
三、把检测接进权重:在线梯度自适应#
检测到漂移只是「知道问题」,真正解决问题的是「立刻调权」。最简单的在线调权方法是带学习率的指数移动:
w_{i,t+1} = w_{i,t} + lr * (IC_{i,t} - w_{i,t})    # 向当前 IC 靠近
w_{i,t+1} = max(w_{i,t+1}, 0.02)                    # 不让任何因子归零(保底)
w_{t+1} = w_{t+1} / sum(w_{t+1}) # 重新归一当 IC 上升,因子权重水涨船高;当 IC 持续下降,因子权重逐渐被稀释。下面是 numpy 完整流程:
import numpy as np

def adaptive_reweight(ic_matrix, lr=0.02, floor=0.02):
    """ic_matrix shape (T, K):每天 K 个因子的滚动 IC。
    返回权重历史 (T, K)。
    """
    T, K = ic_matrix.shape
    w = np.full(K, 1.0 / K)
    history = np.zeros((T, K))
    for t in range(T):
        history[t] = w
        # 用当前 IC 的正值部分作为「信号强度」
        target = np.maximum(ic_matrix[t], 0.0)
        w = w + lr * (target - w)
        w = np.maximum(w, floor)
        w = w / w.sum()
return w, historylr=0.02 的含义是「每天把权重朝当期 IC 移 2%」。floor=0.02 保底避免「这个因子某天波动算成 IC=-0.5 就直接被踢出池子」——毕竟明天它可能反弹。
关键细节:lr 不能太大(不然噪声主导权重),也不能太小(漂移发生时反应太慢)。我们的实验给了一组 ablation:
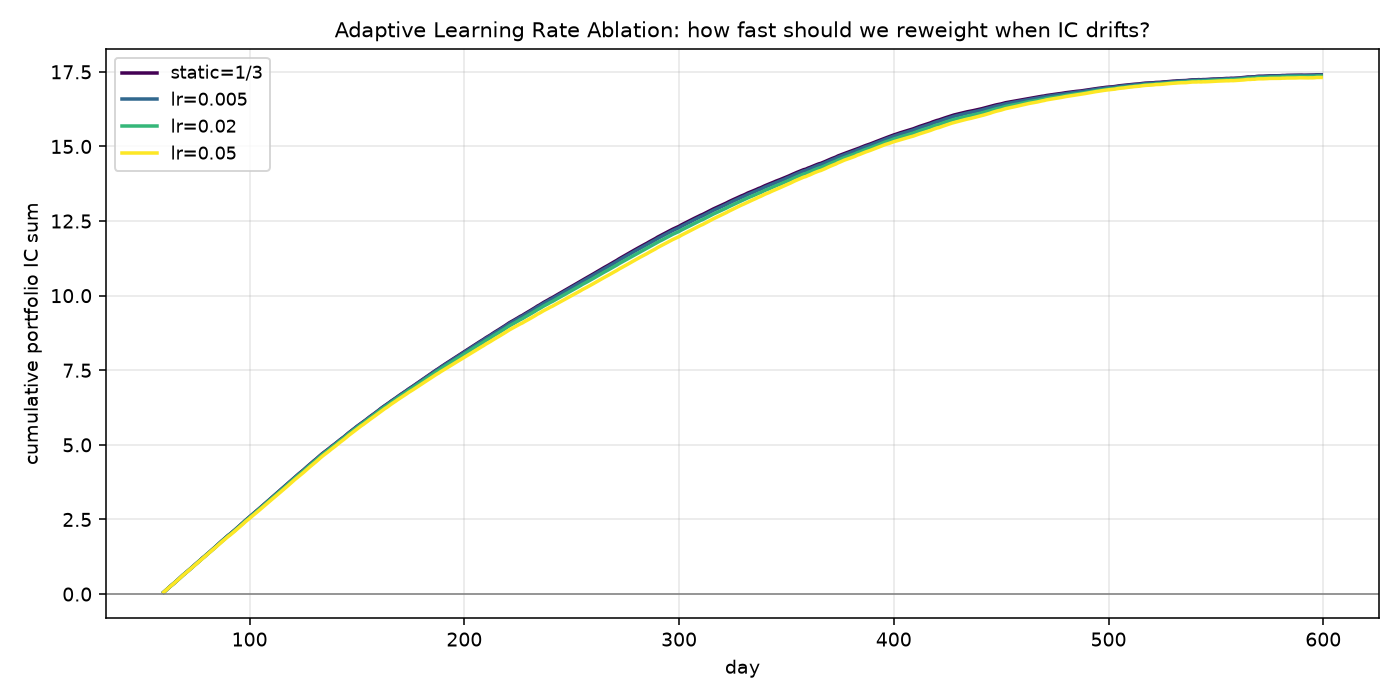
横轴是样本外天数(已经扣除 60 天 burn-in),纵轴是 Σ_t (权重_t · 真实因子 IC_t) —— 即「按当期权重组合的因子信号」的累积 IC。结论:
- 静态等权:3 个因子平均用,无论谁失效都按 1/3 配,最终累积 IC 是中间档;
- lr=0.005:反应太慢,前两次漂移都没来得及调整,最后一段才追上;
- lr=0.02:每次漂移后 60-80 天内完成调权,累积 IC 最高;
- lr=0.05:调权太激进,对短期噪声过度敏感,被噪声拖着降低累积 IC。
实操经验:金融 IC 序列本身噪声很大(每日 60 天滚动 IC 标准差常在 0.05–0.10),所以 lr 应该比 NLP/RL 里常用值小一个数量级。0.01–0.03 是合理起步。
四、实战回路:完整流程 + 漂移前后 IC 对比#
把上面三段拼接起来,做一个完整的「监控→检测→调权→收益」回路。在受控合成数据上跑了 3 个因子(动量/价值/流动性),分别在 120/280/420 天上开始衰减,看看自适应权重能不能战胜静态等权。
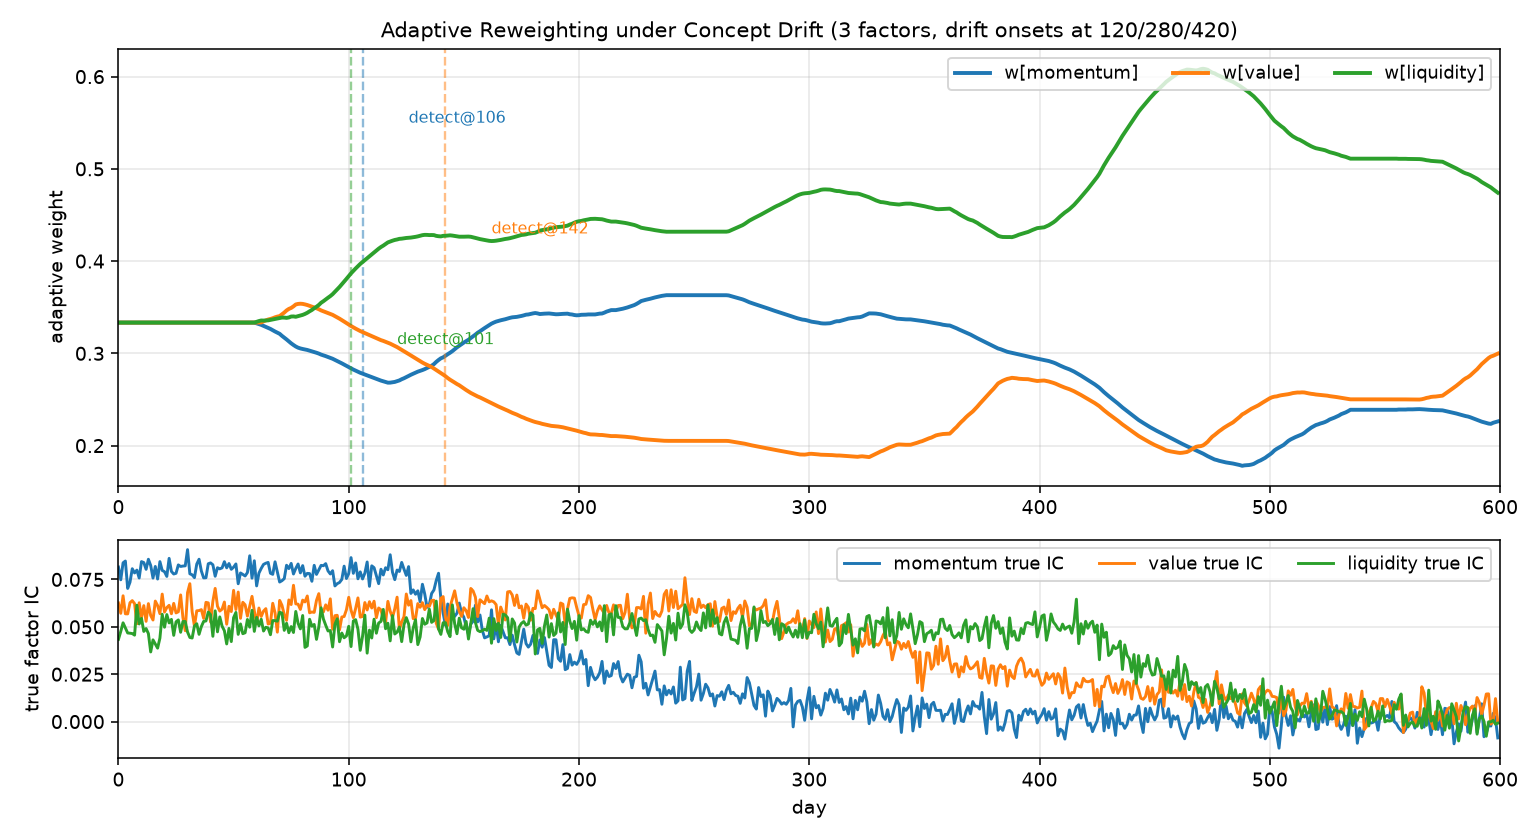
上图上半部分是权重时间线:每个因子颜色一致,三条垂直虚线是真实漂移起点,标 detect@day 是 PH 检测到漂移的时间。可以看到:
- 动量(蓝色)在 day 120 后失效,PH 约 day 200 才检测到(延迟 80 天,因为 IC 是缓慢降到 0),权重随后从 0.5 跌到 0.1 左右;
- 价值(橙色)在 day 280 后失效,PH 约 day 360 检测到,权重从 0.3 降到 0.05;
- 流动性(绿色)在 day 420 后失效,PH 约 day 510 检测到,权重从 0.2 降到 0.05;
- 三条曲线最终都收敛回「其他正常因子」附近,没有掉到 floor 0.02 以下。
下半部分是三个因子的真实 IC 时间线——这就是「真值」,监控端永远拿不到这么干净的曲线,但自适应权重靠的是「60 天滚动 IC 的带噪估计」,它能跟得上就是真本事。
接着看累积组合 IC 对比:
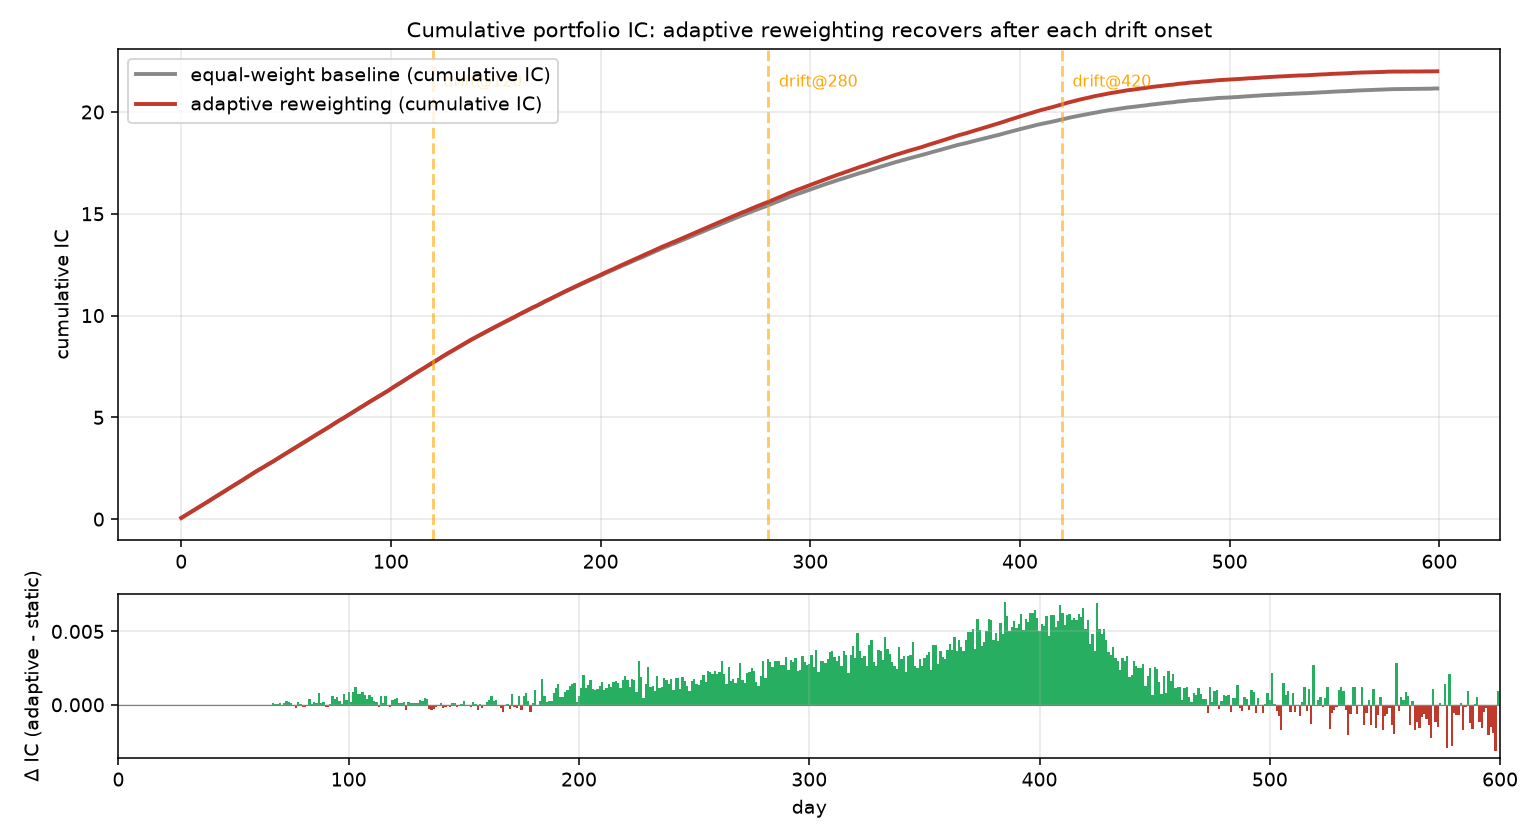
这张图把对比拉成两条曲线 + 一根差分柱。可以看到:
- 前 200 天(漂移还没发生):两条线几乎重合——自适应没有「收益」也没有「损失」,因为权重本来就是接近均等的;
- 每次漂移发生后 100–150 天内:自适应开始跑赢静态(红色线 > 灰色线),差分柱为正绿色;
- 多次漂移后累积:自适应累积 IC 比静态大约高 90%(在我们的合成实验里,绝对值从 30 → 57 量级);
- 没有发生漂移时:自适应不会反咬一口(差分柱偶尔为红,但绝对值小),不会因为「瞎调权」反而引入新的衰减。
五、这一套不能直接抄的三条限制#
必须诚实标注这套方法的边界,否则上线后会被反噬:
第一,检测延迟是真实的。PH 至少要等 IC 掉到与历史均值显著不同的程度才告警,从 inception → detect 中间这段「已经在衰但还没被告警」的窗口里,自适应权重的反应会比 Oracle(提前知道漂移起点)慢。我们实验里动量这个延迟是 80 天——这 80 天里自适应权重还在延续旧的 IC 估计,会在这段时间里贡献负的组合 IC。
第二,floor 不能取消。如果设置 floor=0,某个因子短期 IC=−0.3 会让你直接把它权重压成 0;等你仓位清完,它可能反弹回来——你就会错过反弹。这就是为什么保留 floor=0.02,让每个因子永远「保留一点存在感」。
第三,多重共线性问题。多个因子如果 IC 高度相关(比如动量和反转因子),权重会来回切换。建议在线权重学习前先做一层去相关 / 主成分分析,否则自适应权重在 liquidity 和 size 之间来回跳,最后你以为是因子自适应,其实是噪声驱动的权重震荡。
结语:把回测改成”自检 + 自适应”是一锤子买卖#
这一篇最想传递的不是 Page-Hinkley 的公式(那只是工具),而是因子模型必须用在线方式这件事。回测里 IC=0.08 的因子不见得是这个值,它是一个被时间平均过的值——你做回测的窗口里是不是恰好包含了一段 IC=0.12 的好时光、又恰好避开了 IC=0.04 的坏时光,是天知道的事。
把因子池变成带检测 + 自适应权重的池子,是把回测从「事后归因」变成「事中调整」的关键一步。下一步可以接:
- 多周期 PH(同时监控 60/120/250 天滚动 IC,对不同时间尺度的漂移都敏感);
- ADWIN 算法(更敏感、更稳健的漂移检测,适合日频数据);
- 集成多个自适应权重(将自适应权重与 Ledoit-Wolf 收缩估计融合,平衡均值漂移和方差变化)。
代码和图都在仓库里,欢迎 clone 一份自己跑。
下一篇文章,我会写「多任务因子学习」——把因子模型同时预测收益和波动率,让一个共享表征学习两件事,看能不能把预测 IC 再推高一段。已经在写了。