PIN 知情交易概率:用买卖单不平衡估计市场里有多少『内幕单』#
Glosten-Milgrom 那篇文章留了一个尾巴。模型说:价差由知情者占比 μ 决定,μ 越高做市商要价越宽,μ=0.5 时价差是 μ=0.1 时的五倍。理论很漂亮,但有个致命的实操问题——μ 是模型参数,不是可观测量。没人举手承认自己是知情者。
Easley、Kiefer、O’Hara、Paperman 在 1996 年给出了微观结构实证史上最优雅的答案之一:你不需要知道谁知情,只需要数每天有多少买单、多少卖单。知情交易会在数据里留下一个无法抹掉的指纹——单边的订单不平衡。这个从买卖单计数反解出来的量就是 PIN(Probability of INformed trading),它把 GM 的抽象 μ 变成了每只股票每个季度都能算的数字。
本文用模拟完整复现 EKOP 模型:怎么分簇、怎么估、精度多少、坑在哪。
一、模型:三种日子,三种指纹#
EKOP 模型(沿用四位作者首字母)对”一个交易日”的描述只有三条规则:
- 每天开盘前,信息事件以概率 α 发生;发生时以概率 δ 是坏消息,1−δ 是好消息
- 不知情交易者永远在场:买单以泊松强度 ε_b 到达,卖单以 ε_s 到达——他们因为流动性需求、再平衡、噪声而交易,与消息无关
- 知情交易者只在事件日出现,且只打单边:好消息日全部买入(额外强度 μ),坏消息日全部卖出
于是每天的买单数 B 和卖单数 S 服从三种可能的泊松组合:
| 日子类型 | 概率 | B 的强度 | S 的强度 |
|---|---|---|---|
| 无消息日 | 1−α | ε_b | ε_s |
| 好消息日 | α(1−δ) | ε_b + μ | ε_s |
| 坏消息日 | αδ | ε_b | ε_s + μ |
用 α=0.3、δ=0.4、μ=60、ε_b=50、ε_s=45 模拟 750 个交易日:
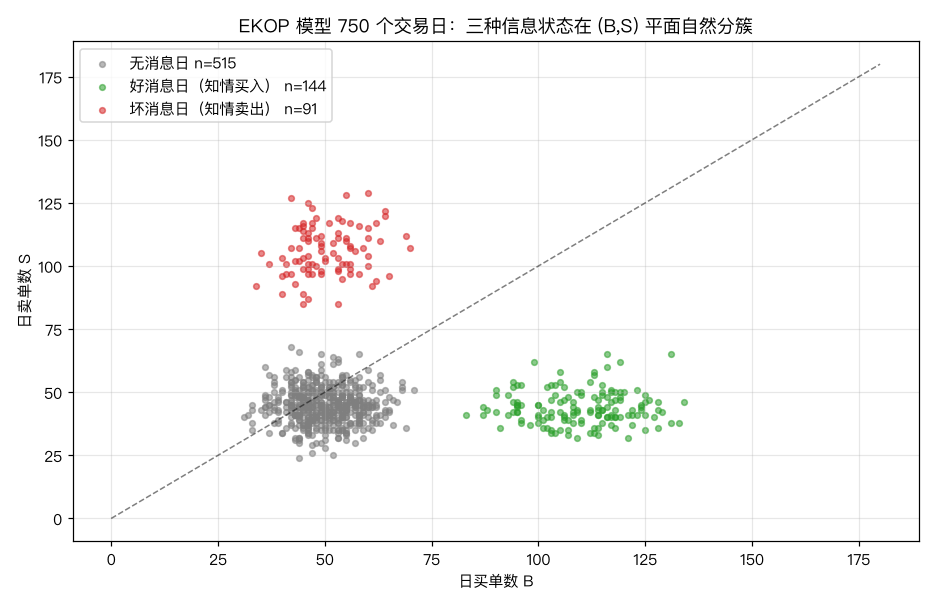
三簇肉眼可分:无消息日蹲在 (50, 45) 附近,好消息日整体右移到 (110, 45),坏消息日上移到 (50, 105)。知情交易的指纹不是成交量大,而是成交量单边——这是整个模型的灵魂。一个双边都放量的日子(财报后多空对砍)在这个模型里更像 ε 的抬升而非 μ 的出现。
PIN 的定义是”随机抽一笔成交,它来自知情者的概率”:
分子是知情单的日均到达量(事件概率 × 知情强度),分母是全部成交的日均到达量。上面参数组合的真实 PIN = 0.3×60/(0.3×60+95) ≈ 0.159——每六笔成交里约有一笔来自知情者。
二、估计:混合泊松的极大似然#
参数五个(α, δ, μ, ε_b, ε_s),数据只有每天一对 (B, S),靠混合泊松似然反解:
代码上有两个必须处理的工程问题。第一,B、S 动辄上百,泊松概率里的阶乘会溢出,必须全程在对数域用 log-sum-exp;第二,似然面多峰(α 和 μ 可以互相顶替:小 α 大 μ 与大 α 小 μ 产生相似的边际分布),必须多起点重启:
from scipy.special import gammaln

def neg_loglik(params, B, S):
    a, d, mu, eb, es = params
    def logpois(k, lam):
        return k * np.log(lam) - lam - gammaln(k + 1)
    l_none = np.log(1 - a)       + logpois(B, eb)      + logpois(S, es)
    l_good = np.log(a * (1 - d)) + logpois(B, eb + mu) + logpois(S, es)
    l_bad  = np.log(a * d)       + logpois(B, eb)      + logpois(S, es + mu)
    M = np.maximum(np.maximum(l_none, l_good), l_bad)
    return -(M + np.log(np.exp(l_none - M) + np.exp(l_good - M)
                        + np.exp(l_bad - M))).sum()

# 多起点 Nelder-Mead,取似然最优解
pin = a * mu / (a * mu + eb + es)多长的样本才够?每组 40 次蒙特卡洛、五档窗口长度的实测:
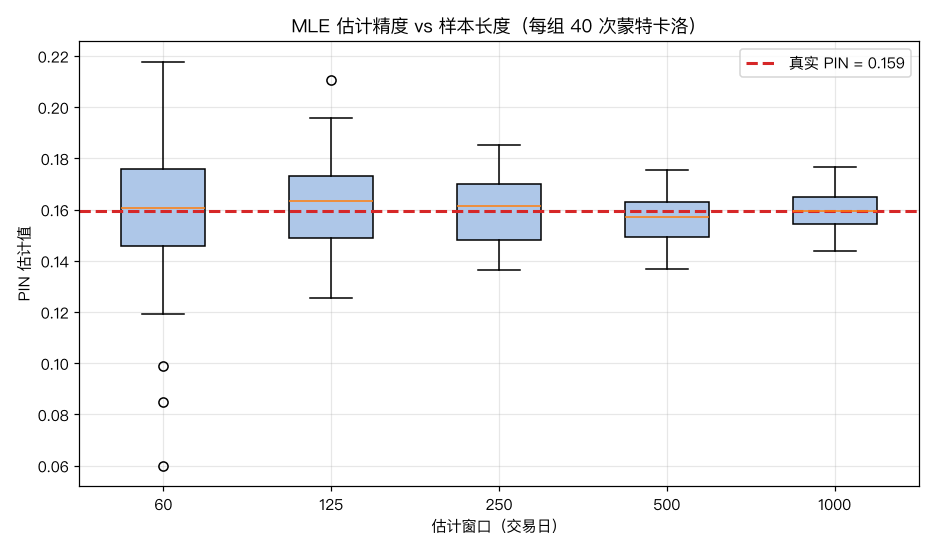
| 窗口(交易日) | PIN 估计均值 | 标准差 |
|---|---|---|
| 60 | 0.158 | 0.032 |
| 125 | 0.162 | 0.018 |
| 250 | 0.160 | 0.013 |
| 500 | 0.157 | 0.009 |
| 1000 | 0.160 | 0.008 |
三个读数:无偏性极好——60 天的均值就贴住真值 0.159,混合泊松结构给的信息量很足;±0.032 的季度噪声意味着单季 PIN 的小幅波动(0.14→0.18)完全可能是噪声,别过度解读;做截面排名(比较几百只股票的 PIN)建议至少一年窗口,让个股估计误差压到 ±0.013 以内,否则排名前列的可能只是估计噪声的幸运儿。
三、闭环:PIN 直接进价差公式#
EKOP 模型的开盘价差有解析解。做市商在第一笔成交前的报价宽度是:
形式上与 GM 的”价差 = μ×信息价值”完全同构——PIN 就是 GM 里那个 μ 的可估计版本:
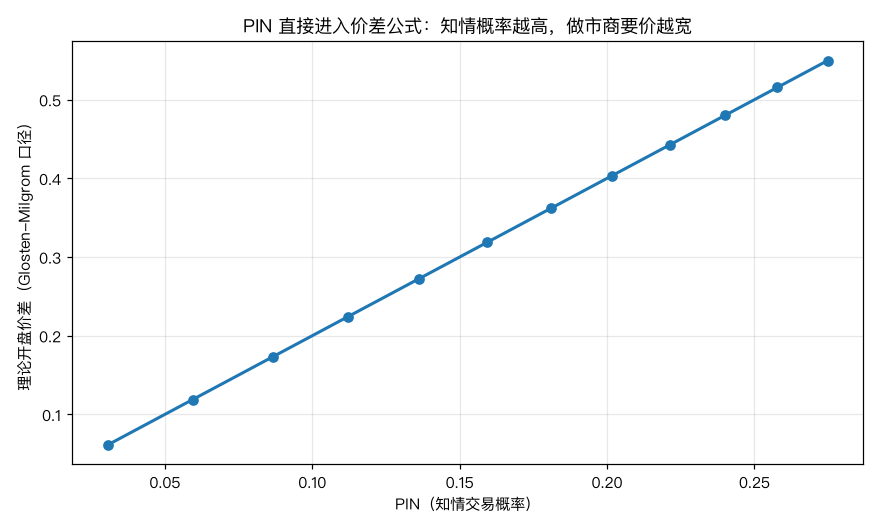
这条线完成了微观结构系列的一个重要闭环:GM 给了价差的信息论解释(价差是不知情者向知情者交的转移税),PIN 给了税率的测量仪。EKOP 原文的实证也正是这么做的:低成交量股票的 PIN 显著更高(0.22 vs 活跃股 0.16),解释了为什么小盘股价差宽——不是做市成本高,而是每笔成交里知情者浓度高。
后续文献把 PIN 用成了一个事件雷达:并购公告前目标公司的 PIN 系统性爬升(内幕消息渗漏进订单流)、盈余公告前 PIN 上升且与公告日跳空幅度正相关。逻辑都一样:信息还没进价格,但已经进了订单流。
四、两个反直觉边界:用模拟拍实#
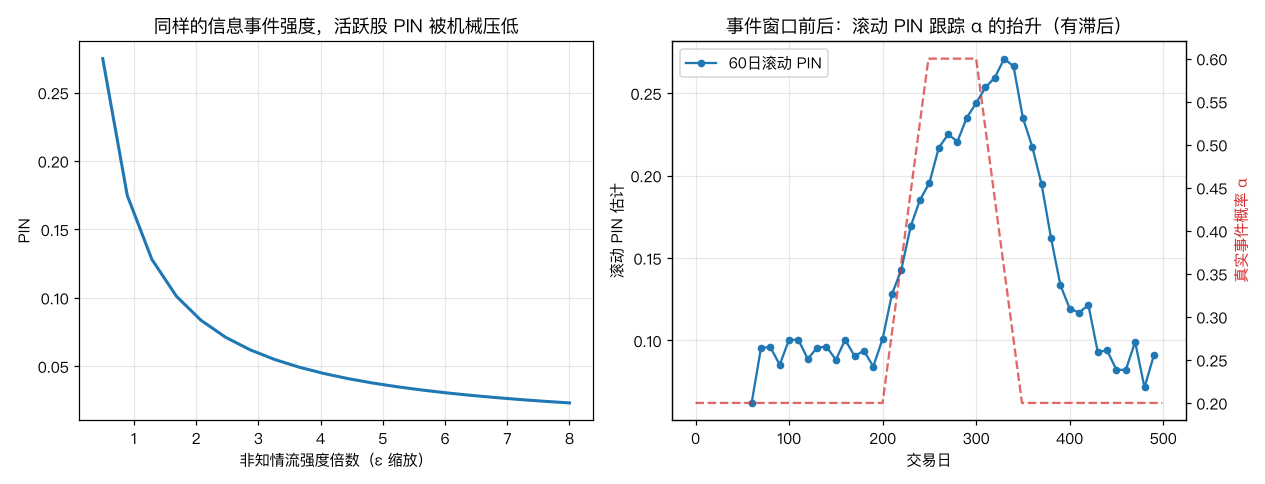
边界一:活跃股的 PIN 被机械压低(左图)。 固定信息事件强度(α、μ 不变),只把不知情流 ε 放大——PIN 从 0.16 单调跌到 0.03。这就是 PIN 公式的算术:分母里的 ε 是”稀释剂”。含义很扎心:PIN 截面上与市值/成交量的强负相关,一半是信息结构差异,另一半纯粹是稀释算术。直接拿 PIN 排序买”知情浓度高”的股票,你买到的很大程度是低流动性本身——这正是 Duarte-Young (2009) 之争的核心:他们把 PIN 拆解后发现,PIN 对收益的定价能力大部分来自流动性成分而非信息成分。用 PIN 做因子必须先对流动性正交化。
边界二:滚动 PIN 能跟踪事件概率,但有窗口滞后(右图)。 模拟一个 α 从 0.2 爬到 0.6 再回落的”事件窗口”(红色虚线),60 日滚动 MLE(蓝线)确实跟上了抬升,峰值位置和幅度大体正确——这验证了并购预测文献的可行性。但滞后也很明显:滚动窗口是移动平均,α 的阶跃要半个窗口才充分反映。想要更快的响应,要么缩窗口(噪声爆炸,见第二节的 60 日 ±0.032),要么换 VPIN 这类按成交量桶滚动的高频亲戚。
五、工程清单与诚实边界#
买卖分类是地基。 模型的输入 (B, S) 需要给每笔成交标方向。美股历史数据用 Lee-Ready 算法(成交价对中间价的位置),错误率 10-15%,分类噪声会同时抬高 ε、压低 μ,PIN 被低估。A 股 Level-2 逐笔数据自带主动买卖标识,是更干净的原料。
泊松假设是已知的最大简化。 真实订单流日内聚簇(开盘收盘 U 型、事件后爆发),过度离散会让混合结构把”聚簇”误读成”事件日”,α 偏高。文献的修补方向是负二项分布替代泊松、或加入日内季节性调整。
参数不平稳。 α、μ 随信息环境漂移,财报季与平静期不是同一组参数。滚动估计是标配,但窗口选择就是第四节右图展示的噪声-滞后权衡。
高频时代的接棒者是 VPIN。 Easley-López de Prado-O’Hara (2012) 把日历时间换成成交量时间、用成交量不平衡直接代理知情流,绕过了 MLE 的收敛问题,2010 年闪崩前 VPIN 的飙升是其成名作。但 VPIN 丢掉了结构模型的可解释性(不再能分离 α 和 μ),两者是精度与速度的取舍而非替代。
定位一句话:PIN 是把 Glosten-Milgrom 的理论参数 μ 变成可测量数字的桥——它测的不是价格里的信息,而是订单流里还没进价格的信息。
参考文献#
- Easley, D., Kiefer, N. M., O’Hara, M., & Paperman, J. B. (1996). Liquidity, Information, and Infrequently Traded Stocks. Journal of Finance, 51(4), 1405-1436.
- Duarte, J., & Young, L. (2009). Why is PIN priced? Journal of Financial Economics, 91(2), 119-138.
- Easley, D., López de Prado, M., & O’Hara, M. (2012). Flow Toxicity and Liquidity in a High-frequency World. Review of Financial Studies, 25(5), 1457-1493.