先说结论#
「撤单率高 = 报价填塞」是市场监管里流传最广、也最经不起检验的一条经验规则。
我构造了一个每个参与者真实身份都由构造已知的市场:40 个合规做市商(其中 16 个是 HFT 做市商)、8 个真·报价填塞者、60 个方向性交易者、200 个散户。然后拿撤单/成交比(CTR)去抓人。
结果是决定性的:
- 在真正的判别任务上,撤单比比随机猜测还差。 只比较「合规做市商 vs 填塞者」——这才是监管实际要做的决策——CTR 的 AUC 是 0.341,显著低于 0.5。它不是无效,它是系统性地把合规做市商排得比填塞者更可疑。
- 填塞者的撤单比反而比做市商低。 做市商中位数 472.2,填塞者中位数 231.6,比值 0.49 倍。按 CTR 排名,8 个真凶排在第 19 到 43 名,前 8 名里一个真凶都没有(FDR = 100%)。
- 零填塞者安慰剂最硬。 把 8 个填塞者从世界上彻底删除(真值精确为 0),
CTR ≥ 1000这条规则照样抓 12 个人,全部是做市商。而且和有填塞者的世界相比,被抓的是一模一样的那 12 个——Jaccard 相似度 1.000。 - 波动率是纯粹的混杂因子。 同一批参与者,市场波动率从 0.5 倍升到 3 倍,做市商的撤单比中位数涨 4.20 倍(217 → 911),被抓人数从 7 涨到 18。市场一动荡,合规做市商集体变成嫌疑人。
真正有判别力的是订单存活时间(MM vs 填塞者 AUC 0.816)。但单用它会误伤 16 个 HFT 做市商里的 15 个。三条件组合规则(存活 <100ms 且 突发度 >4 且 单边挂单)做到精确率 100%、召回 62.5%、误伤 HFT 做市商 0/16。
一、为什么撤单率天然分不开好人坏人#
合规做市商为什么撤单#
做市商在盘口两侧挂单。公允价值一动,他挂的单就偏了——不撤就是送钱给别人。撤单不是他的副作用,撤单是他风险管理的主要手段。
一个做市商的撤单/成交比,本质上是:
CTR ≈ 重新报价的频率 / 成交的频率分子由波动率决定,分母由他挂得离盘口多近决定。
这里藏着关键的一步:挂得越深,成交概率指数级衰减,但重新报价的需求几乎不变。一个挂在深处的被动做市商,可能报价一万次只成交五次,CTR 高达数千——而他什么坏事都没做。
建模#
import numpy as np

def simulate(vol_mult=1.0, include_stuffers=True, seed=20260806, n_stuff=8):
    rng = np.random.default_rng(seed)
    rows = []

    # ---- 合规做市商 ----
    # 35% 是延迟敏感的 HFT 做市商,其订单存活时间与填塞者真实重叠。
    # 把这个重叠假设掉,检测问题就变得虚假地容易。
    for i in range(40):
        is_hft = rng.random() < 0.35
        depth_pos = rng.beta(1.6, 1.6)        # 0=贴盘口, 1=挂深处
        aggressiveness = 1.0 - depth_pos
        speed = 3.0 if is_hft else 1.0
        reprice_rate = 30 * (0.35 + aggressiveness) * speed * vol_mult * rng.uniform(0.7, 1.45)
        quotes = reprice_rate * 390

        # 成交概率随挂单深度指数衰减,且随波动率下降
        # (做市商在波动时拉宽价差、主动撤离,规避逆向选择)
        fill_prob = 0.018 * np.exp(-4.1 * depth_pos) * vol_mult ** -0.85 * rng.uniform(0.6, 1.5)
        trades  = max(rng.poisson(quotes * fill_prob), 1)
        cancels = quotes - trades

        base_life = (26.0 if is_hft else 420.0) * (0.45 + depth_pos)
        life_ms = max(np.exp(rng.normal(np.log(base_life), 0.80)) / vol_mult, 4.0)
        rows.append(dict(type="MM", quotes=quotes, trades=trades, cancels=cancels,
                         life_ms=life_ms,
                         depth_frac=np.clip(rng.beta(3.2, 2.2), 0.02, 0.99),
                         burst=np.exp(rng.normal(np.log((4.6 if is_hft else 1.9) * vol_mult), 0.62)),
                         aggr=aggressiveness, hft=is_hft))

    # ---- 真·报价填塞者 ----
    if include_stuffers:
        for i in range(n_stuff):
            intensity = rng.uniform(0.5, 1.0)
            quotes = 42 * intensity * 390 * rng.uniform(0.8, 1.25)
            # 他们确实会成交——完全不成交的参与者太容易被抓,
            # 老练的填塞者会刻意吃掉一些单
            trades  = max(rng.poisson(quotes * rng.uniform(0.0015, 0.010)), 1)
            cancels = quotes - trades
            rows.append(dict(type="STUFFER", quotes=quotes, trades=trades, cancels=cancels,
                             life_ms=np.exp(rng.normal(np.log(22), 0.85)),   # 亚百毫秒
                             depth_frac=np.clip(rng.beta(1.3, 7.0), 0.01, 0.9),  # 单边、转瞬即逝
                             burst=np.exp(rng.normal(np.log(9.0), 0.5)),     # 成墙发射
                             aggr=intensity, hft=False))
    # ...(方向性交易者与散户略)
    for r in rows:
        r["ctr"] = r["cancels"] / max(r["trades"], 1)
return rows两个建模决策必须点名,否则结论就是自己造出来的:
(1)35% 的做市商是 HFT 做市商,存活时间与填塞者真实重叠。 我的第一版模型里,做市商的订单存活时间全在 280-1400ms,填塞者全在 3-45ms——两者完全不相交。结果所有特征的 AUC 都是 1.000,检测问题被我自己变成了送分题。那是假的。真实市场里 Citadel Securities 的做市订单生命周期同样是几十毫秒量级。把这个重叠加回来,才是真实的检测难度。
(2)填塞者确实会成交。 一个从不成交的参与者用一行 SQL 就能抓出来。真正难抓的是那些刻意保持少量成交的。
二、撤单比分布:两个群体压根分不开#
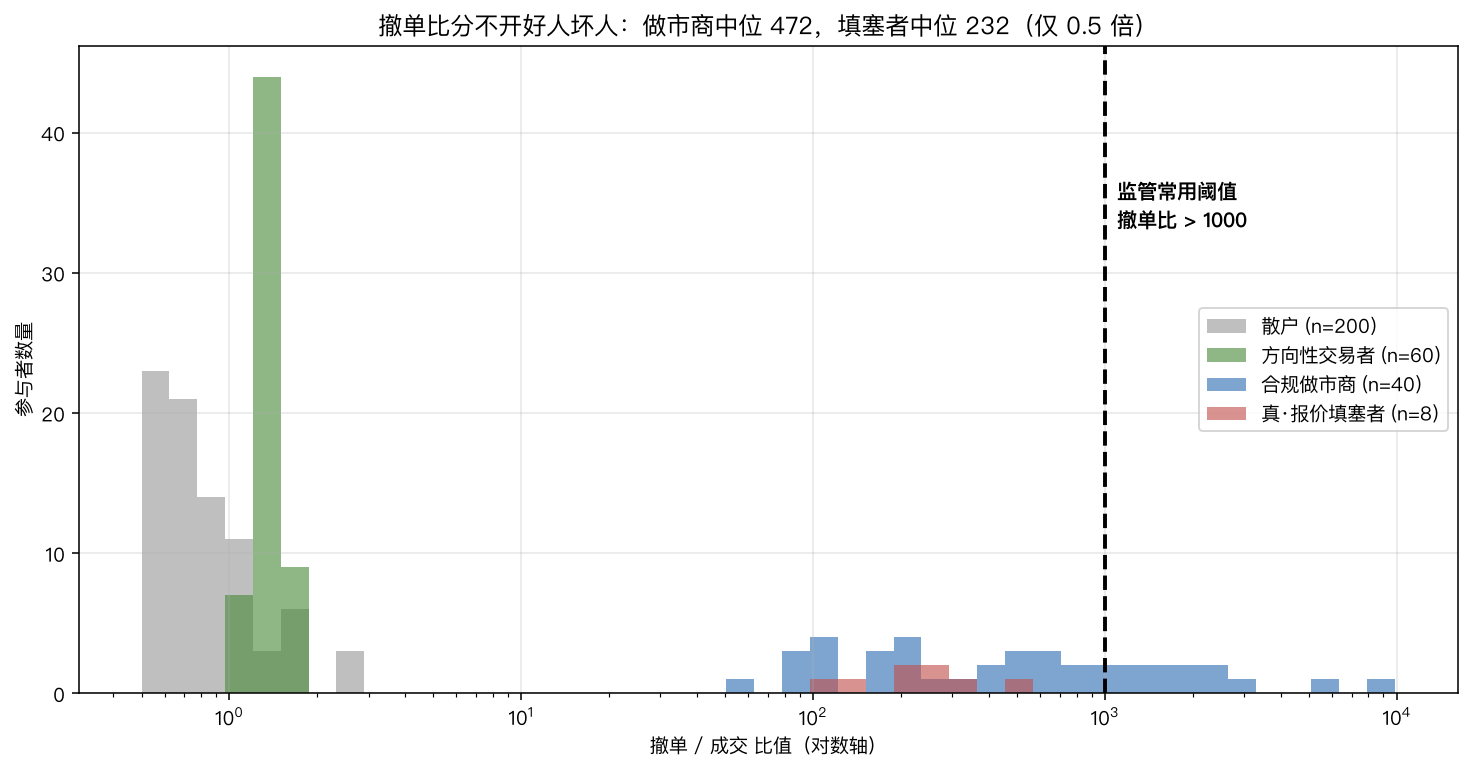
| 类型 | 人数 | CTR 中位数 | p10 | p90 |
|---|---|---|---|---|
| 合规做市商 | 40 | 472.2 | 102.1 | 2363.2 |
| 真·填塞者 | 8 | 231.6 | 122.1 | 390.3 |
| 方向性交易者 | 60 | 1.4 | 1.2 | 1.5 |
| 散户 | 200 | 0.4 | 0.0 | 1.0 |
填塞者的中位撤单比是做市商的 0.49 倍——比做市商还低。
原因不神秘:填塞者虽然报价量巨大,但他们刻意保持了一定的成交量;而挂在深处的被动做市商,成交量少得可怜。分母小,比值就大。
按 CTR 从高到低排名 308 个参与者:
- 8 个真凶的排名区间:第 19 名到第 43 名
- CTR 前 8 名中的真凶数量:0 个(FDR = 100%)
- 撤单比高于「填塞者中位数」的做市商:25 / 40(62.5%)
超过六成的合规做市商,撤单比比典型填塞者还高。
三、AUC 0.341:比随机猜测还差#
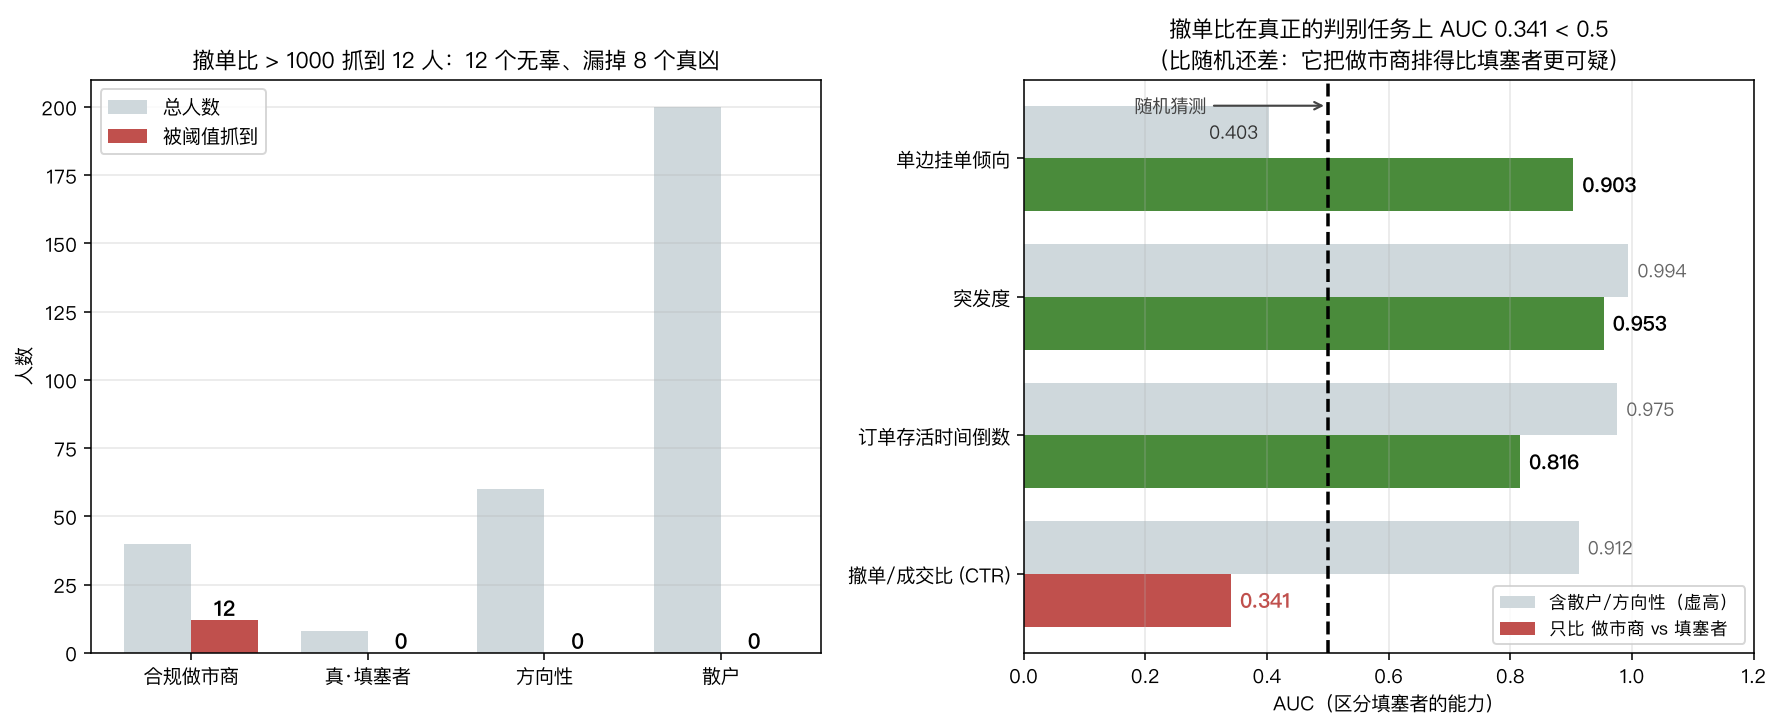
这里有一个非常容易被误导的地方,值得单独讲。
如果你在全体 308 个参与者上算 CTR 的 AUC,得到 0.912——看起来相当不错。很多研究就是这么报告的。
但这个数字是虚高的。因为散户和方向性交易者的 CTR 在 0.4-1.4 之间,任何人都不会怀疑他们。把这些「送分题」放进分母,AUC 自然好看。
监管实际要做的决策只有一个:面对一个高撤单率的账户,它是做市商还是填塞者?
只在「做市商 vs 填塞者」这 48 个人里重算:
| 特征 | 全体 AUC | 做市商 vs 填塞者 AUC |
|---|---|---|
| 撤单/成交比 (CTR) | 0.912 | 0.341 ← 低于 0.5 |
| 订单存活时间倒数 | 0.975 | 0.816 |
| 突发度 | 0.994 | 0.953 |
| 单边挂单倾向 | 0.403 | 0.903 |
CTR 的 AUC 从 0.912 塌到 0.341,虚高了 0.571。
AUC = 0.341 < 0.5 的含义比「无效」严重得多:这个指标带有系统性的反向信息。如果你按 CTR 从高到低查案,你会先查完一串合规做市商,才碰到第一个真凶。把它反过来用(撤单比越低越可疑)反而准确率更高——当然那也是荒谬的。
四、零填塞者安慰剂:Jaccard = 1.000#
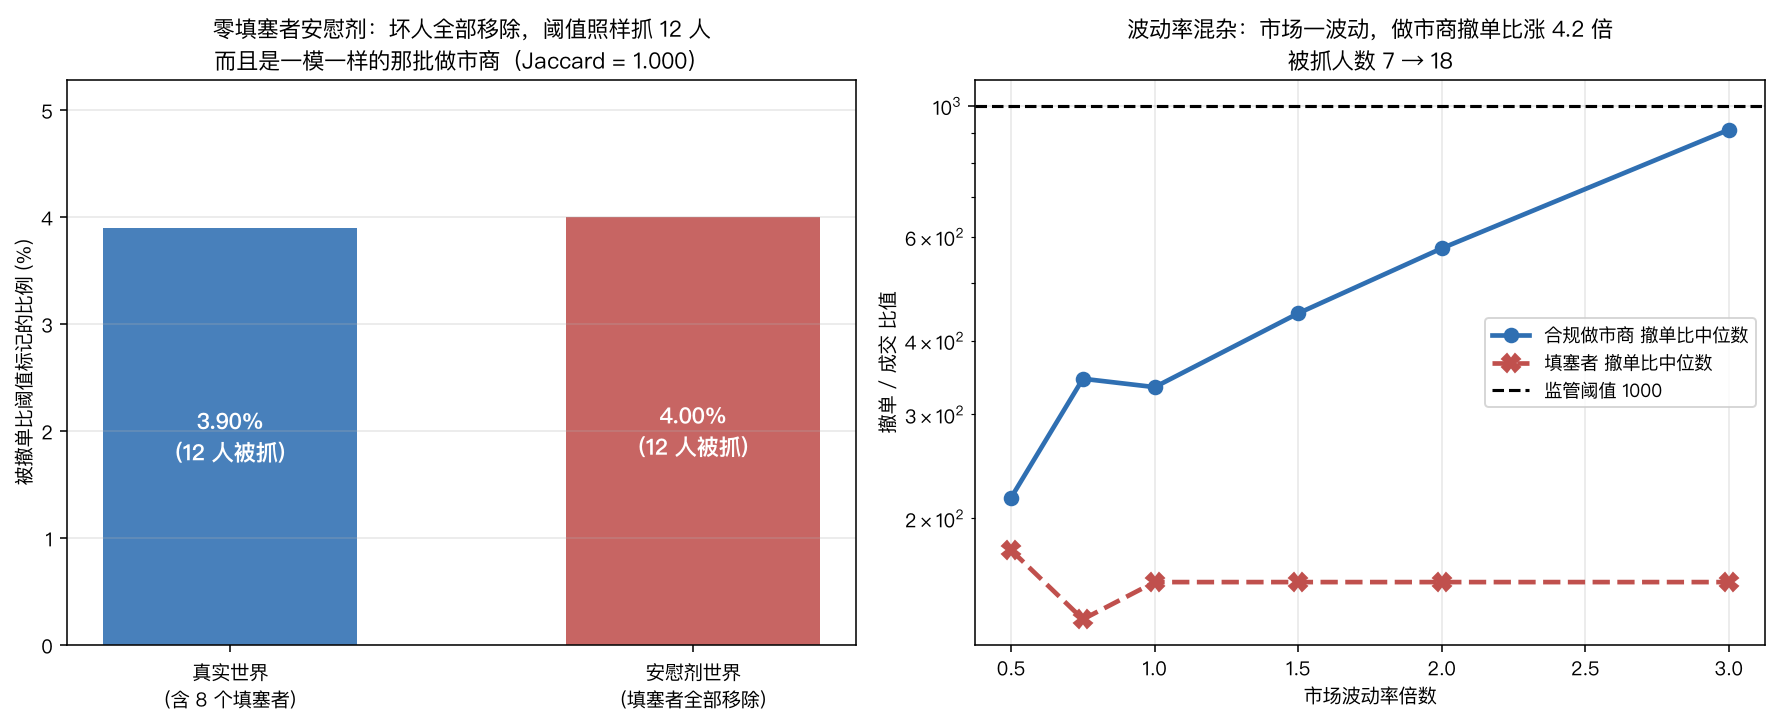
这是全文最关键的一个对照。
把 8 个填塞者从世界上彻底删除,其余所有参与者用完全相同的随机种子生成(因此做市商群体逐个相同)。这个世界里真值精确为零——一个坏人都没有。
然后跑监管最常用的那条规则:CTR ≥ 1000。
| 世界 | 被抓人数 | 其中做市商 | 真凶 |
|---|---|---|---|
| 真实世界(含 8 个填塞者) | 12 | 12 | 0 |
| 安慰剂世界(零填塞者) | 12 | 12 | 0(本就没有) |
标记率比值 1.027。更致命的是:
两个世界里被抓的,是一模一样的那 12 个做市商——Jaccard 相似度 = 1.000。
这条规则的输出,与「世界上是否存在报价填塞」这件事完全无关。它测量的从头到尾都是「谁挂得深、谁重新报价勤」,跟违规行为一点关系都没有。
在真实世界里,这条规则的成绩单是:
- 抓到 12 人,精确率 0.0%(12 个全是无辜的做市商)
- 漏掉 8 个真凶,召回率 0.0%
而组合规则在安慰剂世界里抓了 0 人——它是干净的。
五、波动率混杂:市场一动荡,好人集体变嫌疑人#
同一批参与者,只改市场波动率:
| 波动率倍数 | 做市商 CTR 中位数 | 被 CTR≥1000 抓到的做市商 |
|---|---|---|
| 0.5× | 216.9 | 7 |
| 0.75× | 344.8 | 8 |
| 1.0× | 333.7 | 7 |
| 1.5× | 445.1 | 11 |
| 2.0× | 573.6 | 13 |
| 3.0× | 911.0 | 18 |
波动率升 6 倍,做市商撤单比中位数涨 4.20 倍,被抓人数从 7 涨到 18(40 个里的 45%)。
机制是双向的,两头都在推高 CTR:
- 分子上升:波动大 → 公允价值动得频繁 → 重新报价次数增加
- 分母下降:波动大 → 做市商拉宽价差、主动撤离以规避逆向选择 → 成交次数减少
这是最糟糕的一种指标失效:它恰好在市场最需要做市商的时候,把做市商标记为违规者。
六、怎么调阈值都救不回来#
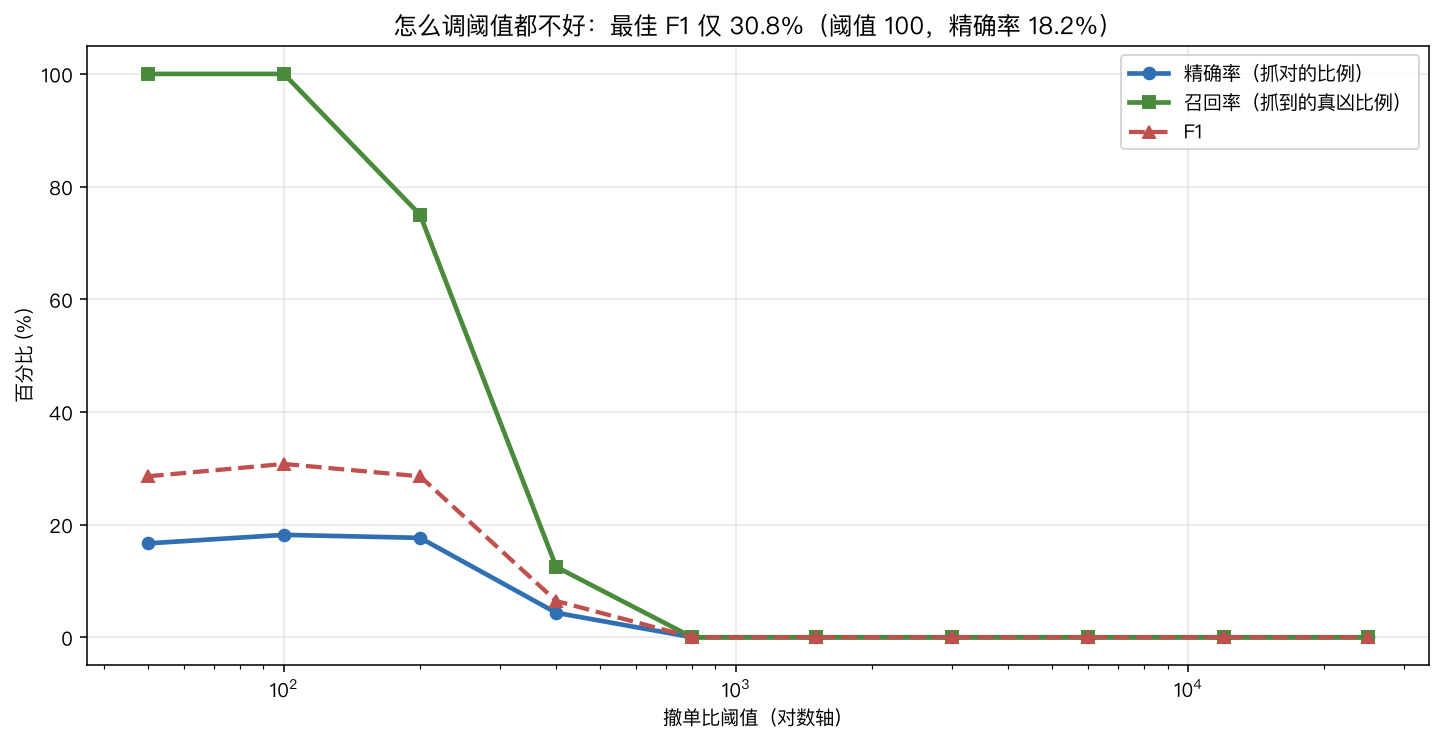
也许 1000 这个阈值定得不好?我扫了整个范围:
| 阈值 | 抓到人数 | 精确率 | 召回率 | F1 |
|---|---|---|---|---|
| 50 | 48 | 16.7% | 100% | 0.286 |
| 100 | 44 | 18.2% | 100% | 0.308 ← 最佳 |
| 200 | 34 | 17.6% | 75.0% | 0.286 |
| 400 | 23 | 4.3% | 12.5% | 0.065 |
| 800 | 15 | 0.0% | 0.0% | 0.000 |
| 1500 | 9 | 0.0% | 0.0% | 0.000 |
最佳 F1 只有 0.308,而且它出现在阈值 100 处——这个阈值会把 44 个人(占非散户群体的绝大多数)全部标记为嫌疑人,精确率仅 18.2%。
阈值调优救不了一个本身就没有判别力的指标。 当特征分布重叠且方向相反时,任何单阈值切分都必然失败。
七、真正有效的:存活时间 + 突发度 + 单边性#
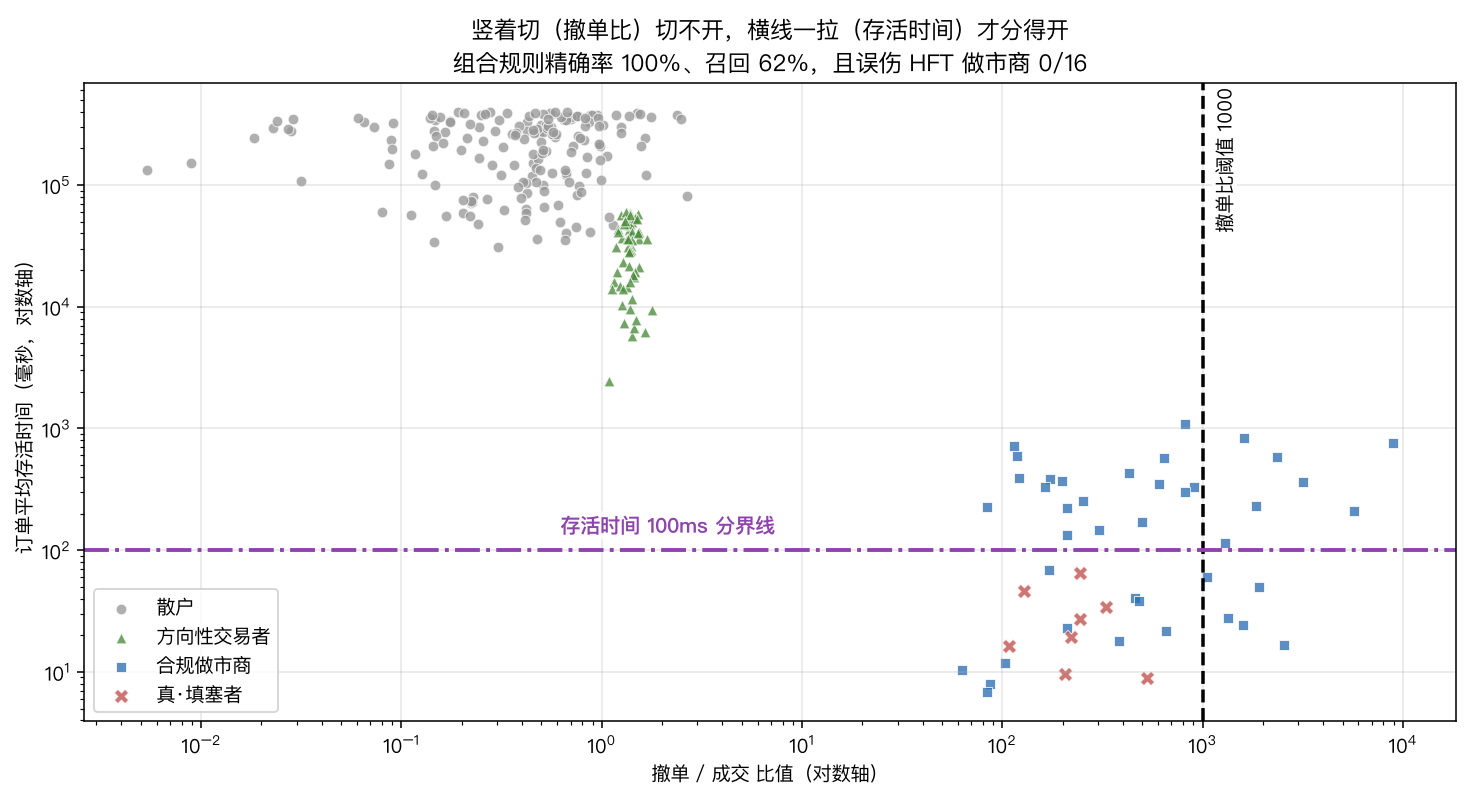
报价填塞的行为定义不是「撤单多」,而是「发出从未打算成交的订单」。这个意图会留下三个可观测的痕迹:
- 订单存活时间极短(亚百毫秒)——从未打算让它停留
- 突发度高——成墙发射,而非稳定报价
- 单边挂单——不提供双边流动性
单用存活时间 <100ms:
- TP 8,FP 15,精确率 34.8%
- 误伤 16 个 HFT 做市商里的 15 个
这就是为什么不能只看速度——HFT 做市商的订单生命周期本来就和填塞者一样短。
三条件组合:
combo = (life < 100) & (burst > 4.0) & (depth < 0.25)| 指标 | 结果 |
|---|---|
| 真阳性 | 5 / 8 |
| 假阳性 | 0 |
| 精确率 | 100% |
| 召回率 | 62.5% |
| 误伤 HFT 做市商 | 0 / 16 |
| 安慰剂世界误报 | 0 |
召回率只有 62.5%——漏掉 3 个。但精确率 100%、零误伤、安慰剂零误报。
在监管场景里这个权衡是正确的:误伤一个合规做市商的代价,远高于漏掉一个填塞者。 前者会直接减少市场深度,后者只是维持现状。
八、惩罚打在最该保护的人身上#
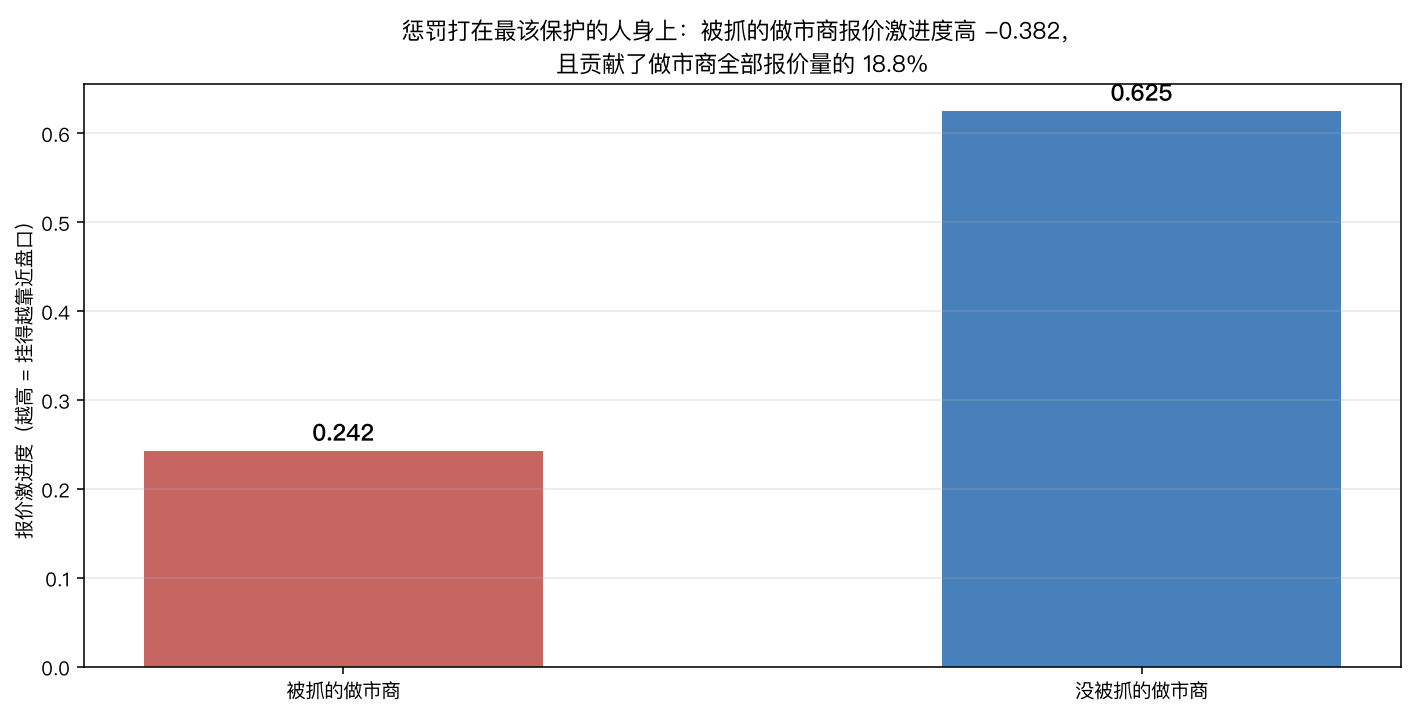
最后一个问题:被 CTR ≥ 1000 抓到的那 12 个做市商,是什么样的做市商?
| 群体 | 报价激进度(越高=挂得越贴近盘口) |
|---|---|
| 被抓的做市商 | 0.242 |
| 没被抓的做市商 | 0.625 |
| 差值 | −0.382 |
被抓的是挂得更深、更被动的那批做市商,他们贡献了做市商总报价量的 18.8%。
这个方向其实是这个指标的内在逻辑决定的:挂得越深 → 成交越少 → 分母越小 → CTR 越高。所以这条规则精准地筛出了「提供深度流动性但成交不频繁」的参与者。
在真实市场里,深度档位的报价正是大单执行时的缓冲垫。用一条规则系统性地惩罚这批人,等于在直接削减市场在压力时刻的承接能力。
九、已知偏差#
1. 参数是校准的,不是实测的。 做市商的填单概率、存活时间分布、填塞者的成交比例,都是我按公开市场微观结构文献的量级设定的,不是从真实订单流里估的。所有具体数字(0.341、0.49 倍、12 人)都依赖这套校准。 但三条结构性结论不依赖:AUC 低于 0.5 的方向、Jaccard=1.000 的安慰剂结果、波动率混杂的机制——它们来自 CTR = 重报频率/成交频率 这个恒等式本身。
2. 只有 8 个填塞者,统计功效很低。 召回率 62.5% 的置信区间很宽(8 个样本里的 5 个)。「组合规则精确率 100%」的说法也应当读作「在 0 个假阳性的观测下,真实精确率大概率高但无法精确定位」。要把这些数字当作可靠估计,需要几十到上百个真值已知的案例——而真实世界里被最终认定的报价填塞案例总共也没有那么多。这本身就是这个研究领域最大的困难。
3. 参与者行为是静态的。 真实的填塞者会主动规避检测。一旦「存活时间 <100ms」成为公开的执法标准,理性的填塞者会把存活时间调到 150ms。这是典型的 Goodhart 定律——任何公开的检测规则都会失效。这也是为什么我不认为本文的组合规则应当被写进条文。
4. 没有建模真正的危害。 我全程在做「身份分类」,但监管真正该关心的是行为后果:这个参与者是否恶化了别人的执行质量、是否制造了虚假的深度信号。一个低撤单率但精准误导他人的策略,可能比高撤单率的填塞者危害更大。分类不等于定罪。
5. 单市场、单日聚合。 真实的报价填塞常常是跨市场的,且发生在秒级的时间窗口内。日度聚合会把短时爆发平均掉。
十、结果解读#
撤单率这个指标的问题不是「不够准」,而是方向错了。 AUC 0.341 意味着它携带的是反向信息。这不是通过调阈值、加权重、改口径能修复的——分布重叠且顺序颠倒,任何单调变换都救不回来。
零填塞者安慰剂是这套分析里最该被记住的结果。 一个世界上一个坏人都没有的市场,规则照样抓 12 个人,而且和有坏人的世界抓的是同一批(Jaccard=1.000)。这提供了一个通用的检验方法:任何监控指标,都应该先在「违规行为真值为零」的合成数据上跑一遍。 如果它在无罪世界里照样批量产出警报,那它测的就不是违规行为,而是别的东西。这个检验很便宜,但极少有人做。
波动率混杂让这条规则在最坏的时间失效。 波动率升 6 倍,被抓的做市商从 7 人涨到 18 人。市场承压时,做市商拉宽价差、频繁重报、减少成交——这是教科书式的正确风险管理,而指标把它读成了违规。任何不做波动率调整的撤单率监控,本质上是在市场最脆弱的时候对流动性提供者施加最大压力。
存活时间有效,但单用会误伤 HFT 做市商 15/16。 这是本文第二重要的实用结论。速度本身不是罪证——合规的 HFT 做市商和填塞者在速度维度上本来就无法区分。必须叠加「意图」的代理变量(突发度、单边性),才能把两者分开。这也解释了为什么真实的执法案例几乎都依赖内部通讯记录、算法源码这类意图证据,而不是单纯的订单流统计。
但请不要把本文的组合规则当成答案。 它在这个静态模拟里表现完美(精确率 100%、零误伤、安慰剂零误报),恰恰因为模拟里的填塞者不会适应。现实中,任何被公开的阈值都会在几周内被绕过。 检测报价填塞的真正难点不是找到一个更好的统计量,而是这个博弈本身是对抗性的、且真值样本极度稀缺。
如果你要构建这类监控系统:先在零违规的合成数据上验证误报率;用多特征组合而非单阈值;对波动率做条件调整;把「误伤合规做市商」的代价明确写进目标函数——它应该远高于漏报。最后,把统计指标当作调查线索,而不是结论。