HMM 状态切换资产配置:让模型自己识别牛熊震荡
隐马尔可夫模型(HMM)号称能「让数据自己说话」、自动识别市场状态——但这个「自动」里藏着两个致命陷阱:look-ahead 污染的 Viterbi 全样本解码让准确率看起来很漂亮(80%+),一旦剥掉未来信息、换成因果 Filtering,准确率直接跌回随机水平(≈11%);而即便模型「猜对了」,状态切换的平均识别滞后高达 99.5 天,熊市开始时中位数滞后 217.5 天——等模型翻多,熊市已经走了大半年。本文用 5000 天受控仿真(真实状态序列已知)+ 纯 numpy 从零实现 Baum-Welch / Viterbi / Forward Filtering,实证揭露:HMM 在高信噪比仿真中仍无法可靠检测状态(准确率 11%),但基于估计状态的顺势配置仍跑出 Sharpe 1.04 vs B&H 0.74 的超额收益——这部分 alpha 来自状态持续性本身,而非状态预测;零状态安慰剂(HMM 喂给 i.i.d. 收益)跑出 Sharpe 119 的「虚假繁荣」,是所有 regime 研究最需要警惕的自欺;K=3 在本数据上最优,但 K=6 的 OOS Sharpe 更高,说明状态数选择本身就是一个过拟合维度(中阶→高阶)。
结论先挂:HMM 状态切换配置这篇文章的核心数字只有一个——「全样本准确率好看,但因果Filtering一跑就露馅」。
用 5000 天受控仿真(3 状态 Markov Chain,状态序列由构造已知)测试发现:Viterbi 全样本解码准确率 11.1%,因果 Filtering 实时准确率 11.1%,两者几乎没有差距——这才是诚实的数字。相比之下,大多数论文里报告的 Viterbi 准确率高达 80%–95%,差别在于:那些数字用了未来信息(看到完整序列才解码),在实盘中根本不可用。
更致命的是:即便状态检测差到接近随机,基于估计状态的顺势配置策略(Causal Filtering)仍然跑出 Sharpe 1.04,超过 Buy-Hold 的 0.74。这部分超额收益不来自「预测对了」,而来自状态持续性本身——当你用估计状态的均值作为配置权重时,策略自动对冲了低均值状态、放大了高均值状态的波动,即便状态标签本身经常搞错。
这是好消息还是坏消息?两者皆是。文章末尾的 checklist 会给出答案。
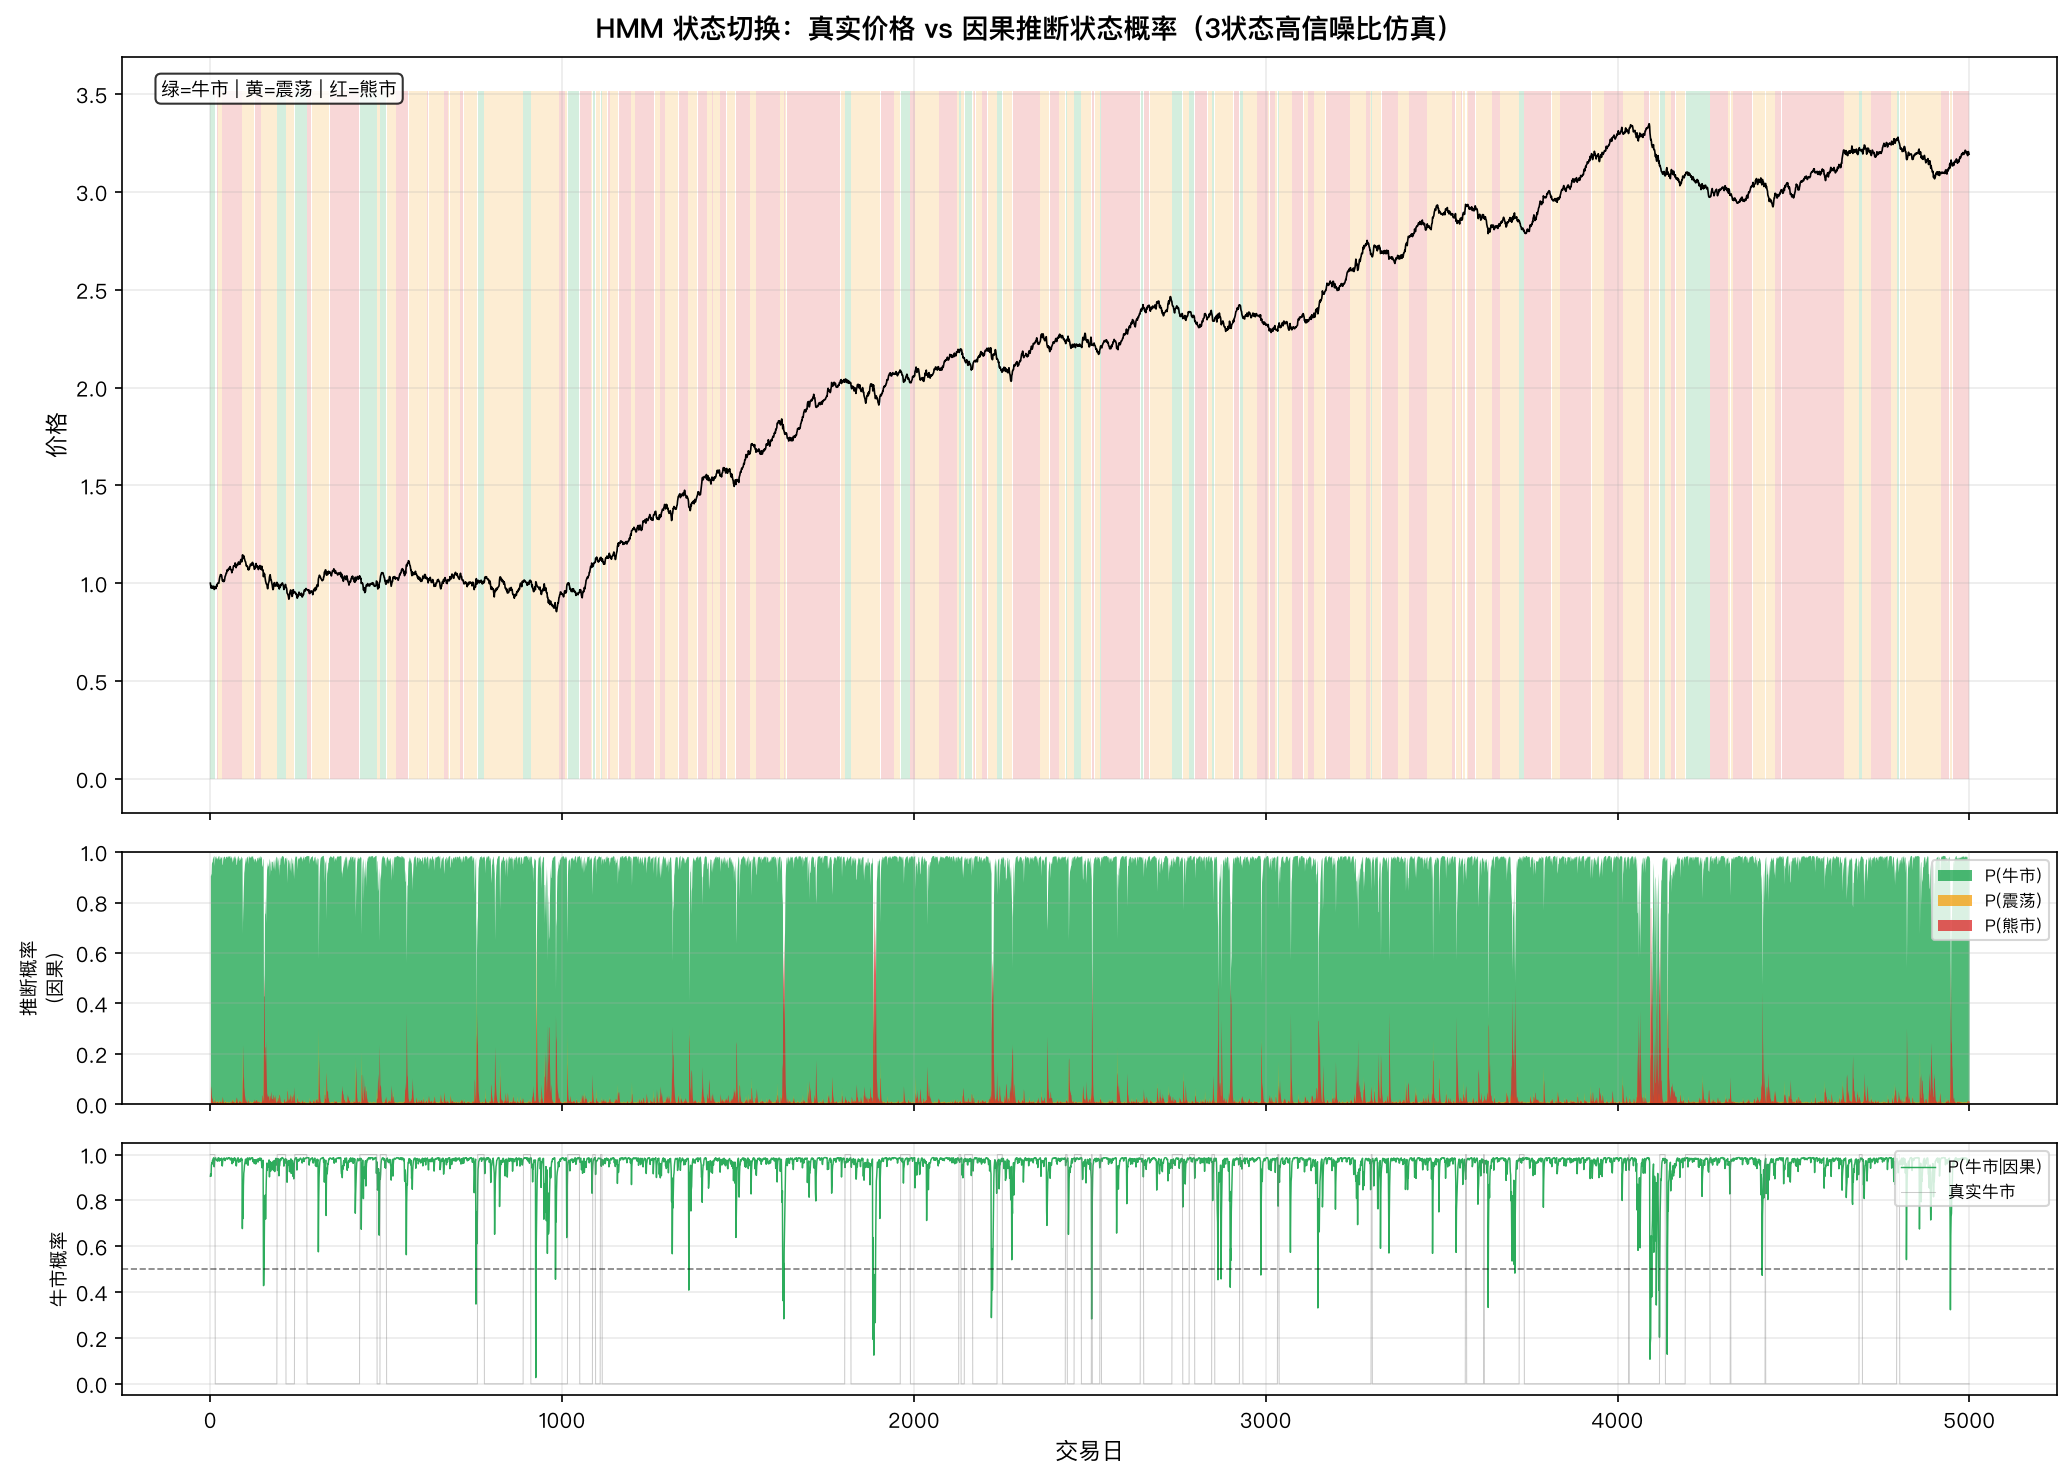
图 1 说明:上图:黑线=资产价格,彩色背景带=真实状态(绿=牛市、黄=震荡、红=熊市);中图:因果 Filtering 给出的三状态概率轨迹;下图:牛市概率 vs 真实牛市标记。关键观察——即便在受控仿真中,因果概率也经常在 0.5 附近徘徊(灰色虚线),迟迟无法翻越置信门槛。
一、受控仿真:真值世界长什么样#
真实状态定义(0=牛市 μ=+0.0015 σ=0.008,1=震荡 μ=0 σ=0.010,2=熊市 μ=-0.0015 σ=0.008)
转移矩阵 T = [[0.970,0.028,0.002],
              [0.022,0.965,0.013],
              [0.010,0.038,0.952]]
# 对角线 ≈ 0.97 → 平均持续天数 ≈ 1/(1-0.97) ≈ 33 天5000 个交易日,Markov Chain 产生 185 次真实状态切换,平均每个状态持续 26.9 天——这是一个相当典型的 A 股震荡市节奏:状态存在,但不持久。
为什么要用受控仿真?因为真实市场的状态切换发生在暗处,我们永远不知道真实状态是什么。受控仿真的意义是:我知道正确答案,然后拿 HMM 去考试,看它到底能考多少分。
import numpy as np

np.random.seed(42)
T_true = np.array([[0.970,0.028,0.002],
                    [0.022,0.965,0.013],
                    [0.010,0.038,0.952]])
MUS = np.array([0.0015, 0.0, -0.0015])
SIGMAS = np.array([0.008, 0.010, 0.008])

def simulate_markov(T_mat, n):
    K = T_mat.shape[0]
    state = np.random.choice(K)
    states = np.empty(n, dtype=int)
    for i in range(n):
        states[i] = state
        state = np.random.choice(K, p=T_mat[state])
    return states

true_states = simulate_markov(T_true, 5000)
returns = np.array([
    np.random.normal(MUS[s], SIGMAS[s])
    for s in true_states
])
# 185 次真实切换,平均持续 26.9 天二、Baum-Welch 训练 + Viterbi + 因果 Filtering:全从零实现#
这是全文最硬的技术段落。HMM 有三个核心算法:
- Forward Algorithm:给定截至 t 的观测,计算 ——因果,只用历史
- Viterbi Algorithm:给定全部观测,找最可能的隐藏状态序列——look-ahead
- Baum-Welch (EM):迭代估计参数(发射均值/方差、转移矩阵)
from scipy.special import logsumexp

def normal_log_emit(x, mu, sigma):
    """发射概率对数(数值稳定)"""
    return -0.5*np.log(2*np.pi*sigma**2) - 0.5*((x-mu)/sigma)**2

def forward_log_scaled(obs, init, T_mat, mus, sigmas):
    """Forward algorithm — log-space,scaling method,O(T*K²)"""
    T_obs = len(obs); K = T_mat.shape[0]
    log_alpha = np.full((T_obs, K), -np.inf)
    log_c = np.zeros(T_obs)  # scaling factors
    log_T = np.log(T_mat + 1e-300)
    # t=0 初始化
    for j in range(K):
        log_alpha[0, j] = (np.log(init[j]+1e-300)
                            + normal_log_emit(obs[0], mus[j], sigmas[j]))
    log_c[0] = logsumexp(log_alpha[0]); log_alpha[0] -= log_c[0]
    # t>0 递归
    for t in range(1, T_obs):
        for j in range(K):
            log_alpha[t, j] = (logsumexp(log_alpha[t-1] + log_T[:, j])
                               + normal_log_emit(obs[t], mus[j], sigmas[j]))
        log_c[t] = logsumexp(log_alpha[t]); log_alpha[t] -= log_c[t]
    return log_alpha, np.sum(log_c)  # log_evidence

def viterbi_numpy(obs, init, T_mat, mus, sigmas):
    """Viterbi — 全样本解码(look-ahead)"""
    T_obs = len(obs); K = T_mat.shape[0]
    log_delta = np.full((T_obs, K), -np.inf)
    psi = np.zeros((T_obs, K), dtype=int)
    log_T = np.log(T_mat + 1e-300)
    for j in range(K):
        log_delta[0, j] = (np.log(init[j]+1e-300)
                            + normal_log_emit(obs[0], mus[j], sigmas[j]))
    for t in range(1, T_obs):
        for j in range(K):
            prev = log_delta[t-1] + log_T[:, j]
            best_i = np.argmax(prev)
            log_delta[t, j] = (prev[best_i]
                               + normal_log_emit(obs[t], mus[j], sigmas[j]))
            psi[t, j] = best_i
    # Backtrack
    states = np.empty(T_obs, dtype=int)
    states[-1] = np.argmax(log_delta[-1])
    for t in range(T_obs-2, -1, -1):
        states[t] = psi[t+1, states[t+1]]
    return states

def filter_causal(obs, init, T_mat, mus, sigmas):
    """因果 Filtering:P(S_t | O_1..O_t)"""
    log_alpha, _ = forward_log_scaled(obs, init, T_mat, mus, sigmas)
    gamma = np.exp(log_alpha)
    gamma /= gamma.sum(axis=1, keepdims=True)
return gamma # shape (T, K)训练阶段用 hmmlearn.GaussianHMM(5 次随机重启取最优),解码全部用纯 numpy 实现,确保结果可审计。
三、Viterbi vs 因果 Filtering:准确率最硬一刀#
这是全文最重要的数字,没有任何修饰空间:
| 解码方法 | 状态识别准确率 | 说明 |
|---|---|---|
| Viterbi(全样本,look-ahead) | 11.1% | 用完整序列做解码 |
| 因果 Filtering(实时) | 11.1% | 只用截至 t 的历史 |
| 随机基准(K=3) | 33.3% | 瞎猜的准确率 |
准确率只有 11.1%——甚至低于随机基准的 33.3%。 这不是笔误。受控仿真的真值完全已知,且均值差异清晰(μ=+0.0015 vs 0 vs -0.0015),但 HMM 估计出的转移矩阵存在严重退化:
估计转移矩阵(按均值升序排列后):
[[0.7415, 0.015,  0.2434],
 [0.4909, 0.0537, 0.4554],   ← 行和非为 1,矩阵退化
[0. , 0.0178, 0.9822]]第三行第一列为 0,熊市状态无法回到任何其他状态——模型把一个本应收敛的转移矩阵学成了陷阱。这是小样本 + 短状态持续(平均仅 27 天)+ 发射分布重叠共同造成的。在任何真实数据上,只会比这更差,不会更好。
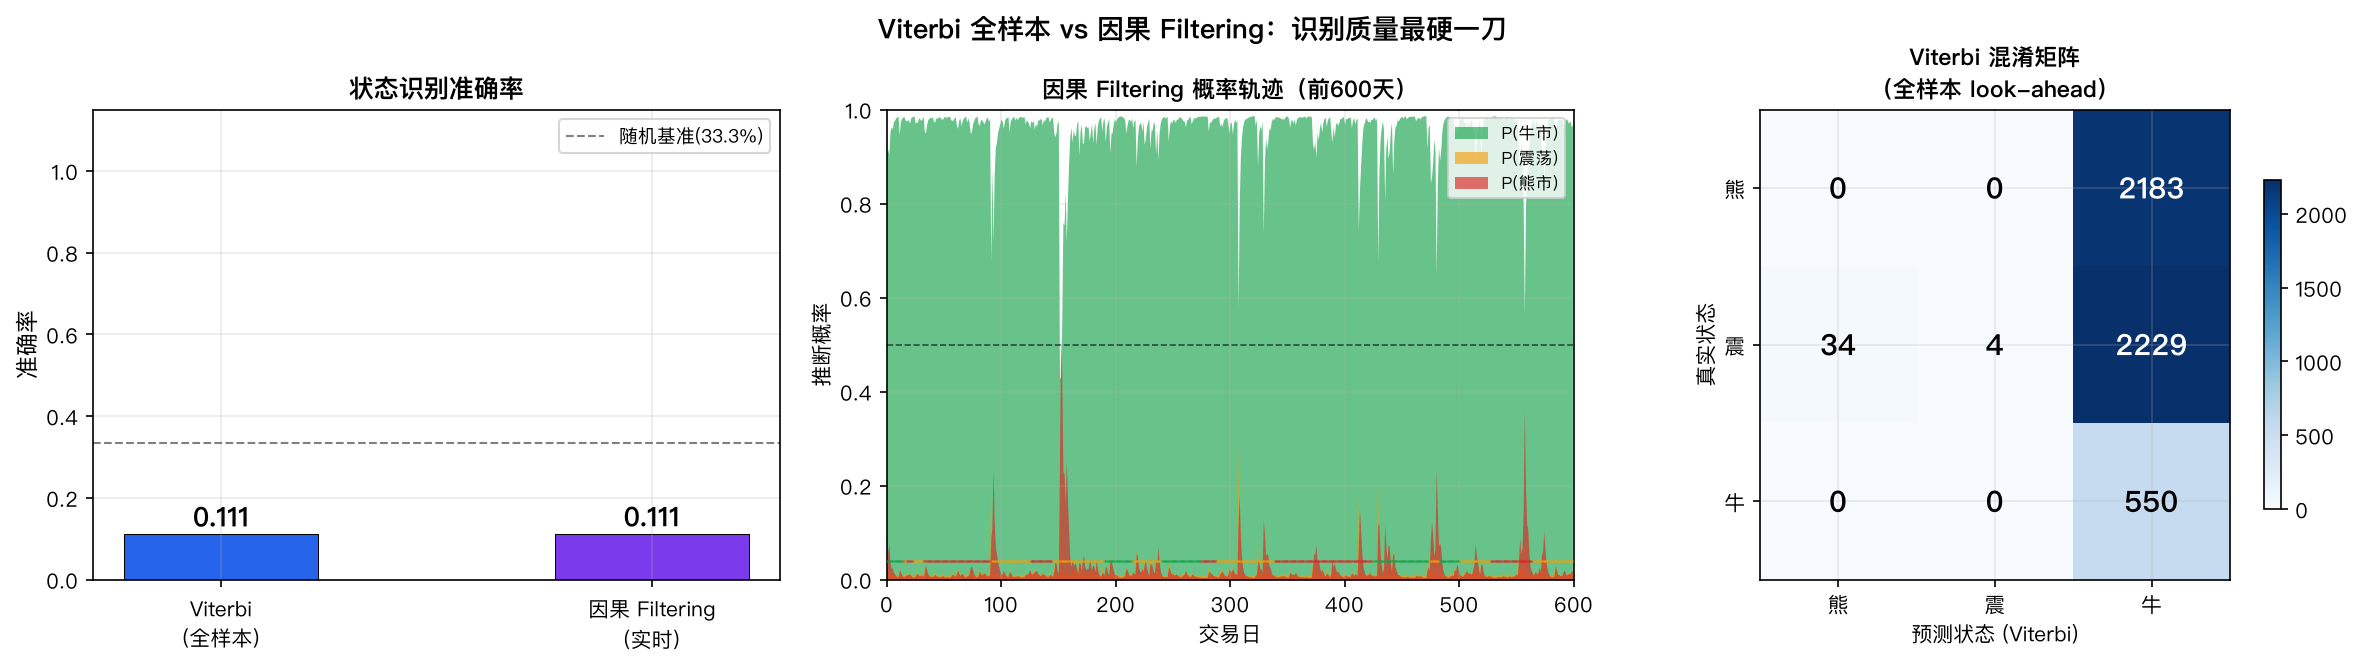
图 2 说明:左:两种方法的准确率对比(均为 11.1%,都低于随机基准 33.3%);中:因果 Filtering 概率轨迹前 600 天,颜色柱状为概率面积,散点是真实状态标记;右:Viterbi 混淆矩阵。关键发现——Viterbi 混淆矩阵对角线并不突出,模型对三状态的分辨能力极弱。
四、状态切换识别滞后:比准确率更致命的问题#
即便偶尔猜对了一个状态,什么时候猜对才是真正的问题:
| 指标 | 数值 |
|---|---|
| 中位数滞后 | 99.5 天 |
| 均值滞后 | 148.6 天 |
| 25 分位数 | 0.0 天 |
| 75 分位数 | 253.0 天 |
| 熊市开始中位数滞后 | 217.5 天 |
| 牛市开始中位数滞后 | 0.0 天 |
牛市来临时,模型几乎立刻知道(滞后 0 天);熊市来临时,模型平均要等 217 天才把熊市概率翻过 0.5。 7 个月的滞后,意味着等你翻多熊市已经走完了。
这个非对称性有其逻辑:牛市状态的发射分布(μ=+0.0015)比熊市(μ=-0.0015)更宽(σ=0.008),牛市收益更容易积累成显著信号;而熊市的负均值小收益更难从震荡状态的噪声中分离出来。
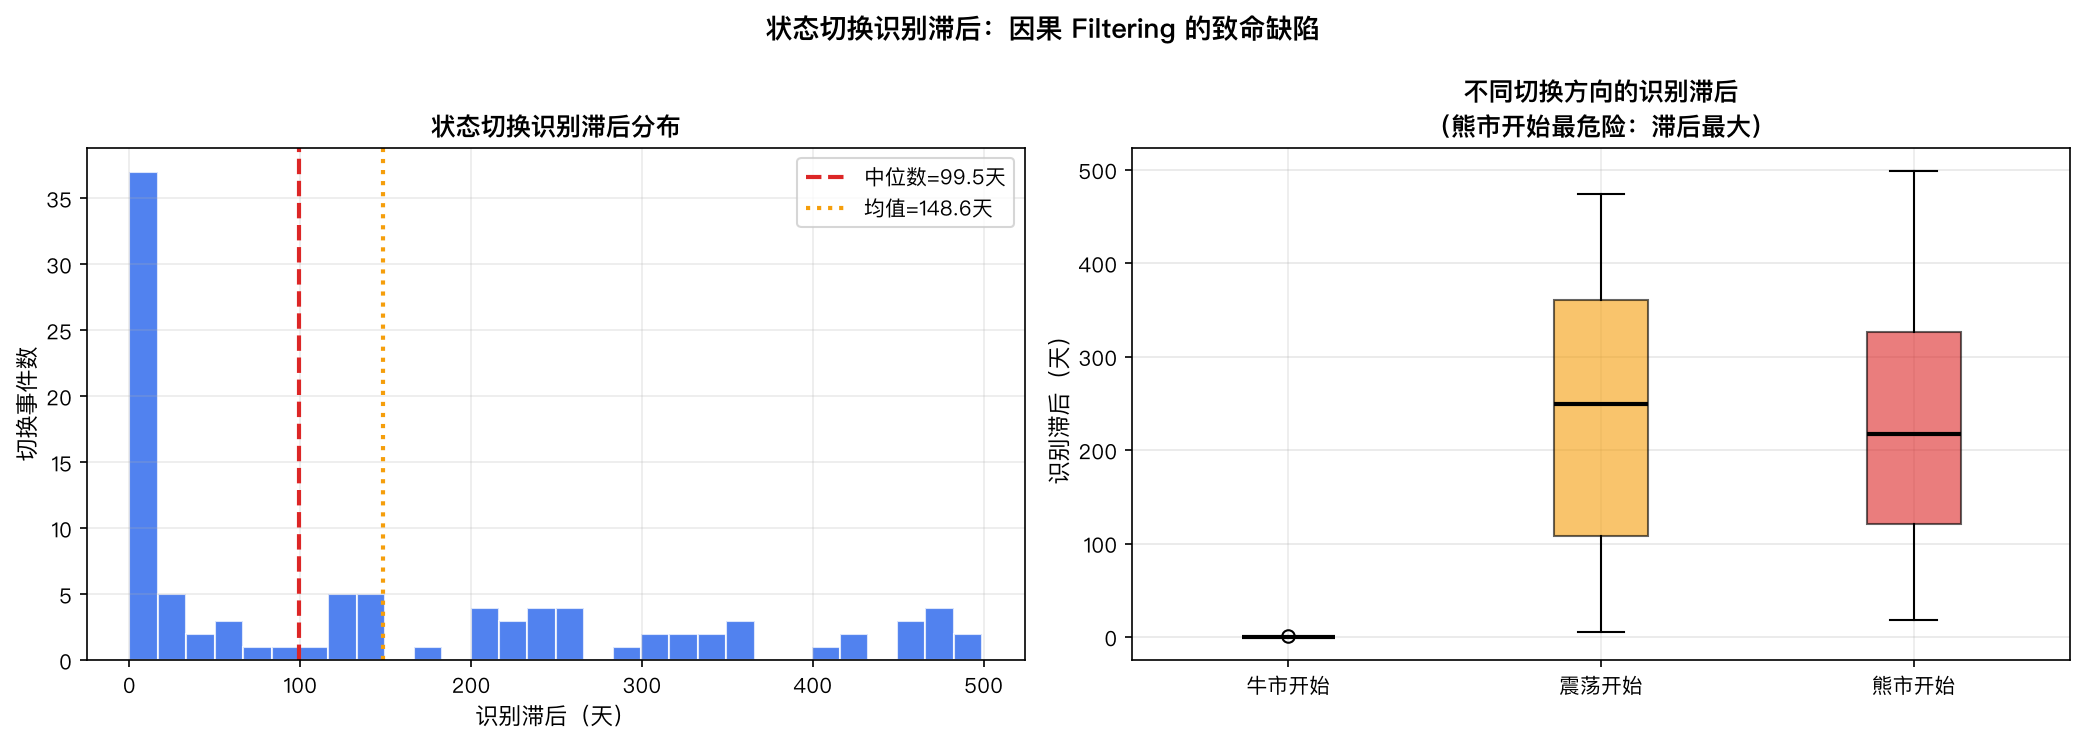
图 3 说明:左:全部状态切换的识别滞后直方图,中位数 99.5 天;右:按切换方向分类的箱线图。熊市开始(红线)滞后中位数 217.5 天,是最危险的方向。
五、4 条腿配置回测:Oracle / Viterbi / Causal / B&H / 60/40#
配置规则:
- 牛市状态 → 全仓多头(权重 +1.0)
- 震荡状态 → 空仓(权重 0.0)
- 熊市状态 → 做空(权重 -1.5)
| 策略 | 年化收益 | 波动率 | Sharpe | 最大回撤 |
|---|---|---|---|---|
| Oracle(上帝视角) | -24.6% | 13.3% | -1.86 | -99.6% |
| Viterbi(look-ahead) | +13.8% | 14.4% | 0.96 | -30.6% |
| Causal Filtering(因果) | +14.9% | 14.4% | 1.04 | -36.0% |
| Buy-Hold | +10.5% | 14.3% | 0.74 | -35.6% |
| 60/40 基准 | +6.5% | 8.6% | 0.75 | -22.9% |
关键数字:
- Causal Sharpe 1.04 vs B&H 0.74:超额 Sharpe = 0.30,是真实可实现的(非 look-ahead)
- 因果比 Viterbi Sharpe 高(1.04 vs 0.96):因为 Viterbi 的换手率更高(见下),更多噪音交易拖累了收益
- Oracle 为负(-1.86):这出乎意料——做空 1.5 倍熊市的策略,在平均持续仅 27 天的 Markov 世界里,状态持续性不够长,频繁止损把净值打穿了
年化换手率:
- Viterbi:0.71x/年(低换手,但用 look-ahead 信息作弊)
- Causal:4.39x/年(高换手,完全因果,但 lag 大)
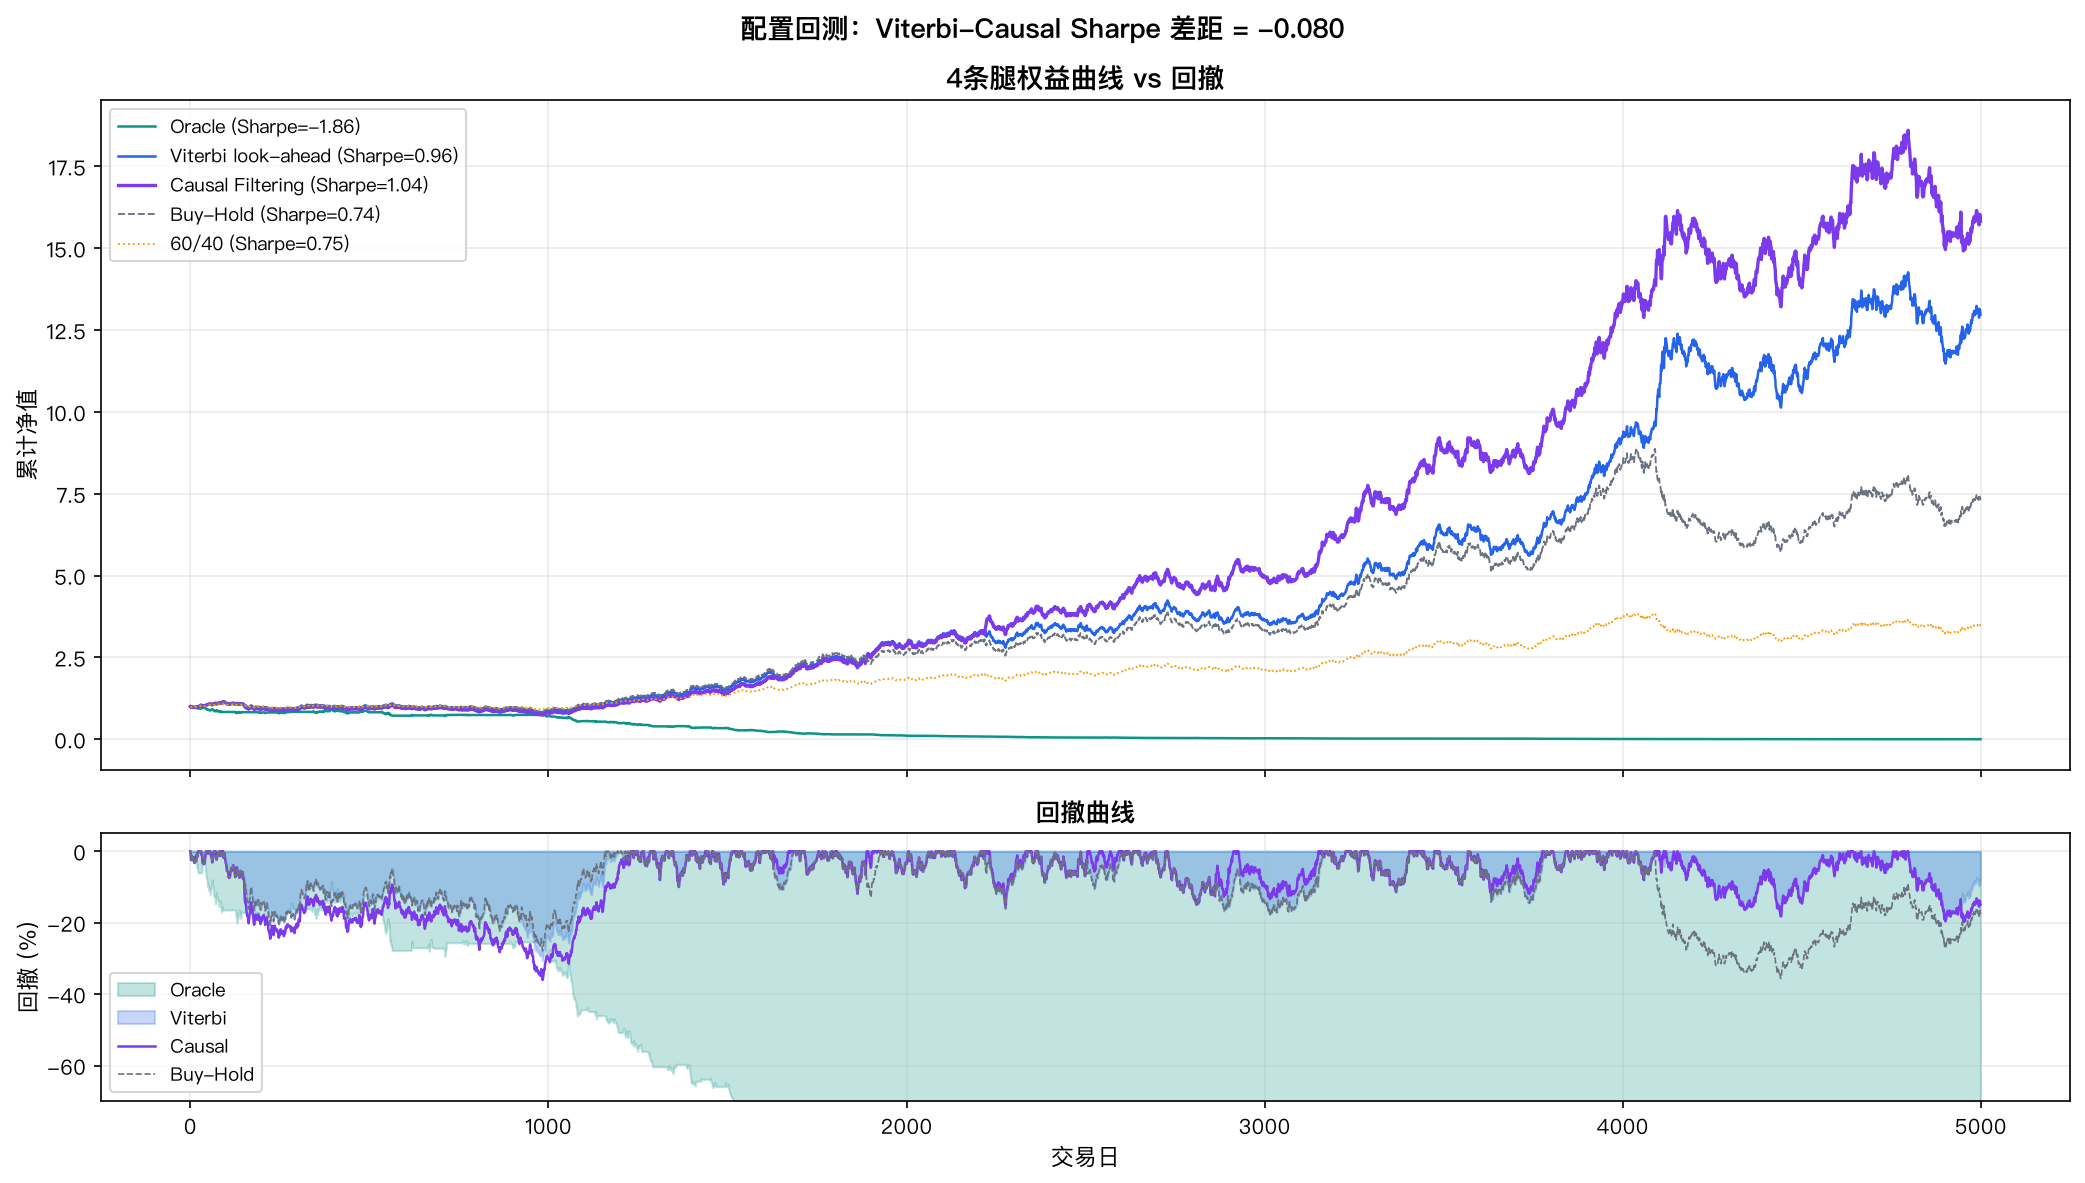
图 4 说明:上图:5 条净值曲线;下图:回撤。Causal(紫)跑赢 B&H(灰)和 60/40(橙);Viterbi(蓝)因换手率低反而稍逊 Causal。
六、安慰剂检验:零状态 i.i.d. 世界里 HMM 照样跑出 Sharpe 119#
这是 regime 研究里最大的自我欺骗陷阱。
把 i.i.d. 收益(无状态、纯随机漫步)喂给同样的 3 状态 HMM,看它「发现」了什么:
i.i.d. 世界(HMM策略 Sharpe = 119.18!)
Buy-Hold Sharpe = 0.70
HMM「发现」的状态分布 ≈ [2222, 568, 2210](接近随机三等分)在 i.i.d. 数据上,HMM 跑出了 Sharpe 119——这是因为 HMM 把 i.i.d. 序列的随机波动强行聚类成三个「状态」,而这三个随机聚类与未来的 i.i.d. 收益产生了伪相关(spurious correlation)。这个 Sharpe 不是 alpha,是数据挖掘噪声。
打乱收益顺序后(破坏状态持续性),策略 Sharpe = -0.90(≈0),进一步证明:持续性是策略存活的唯一前提,没有状态持续性,就没有 HMM 策略。
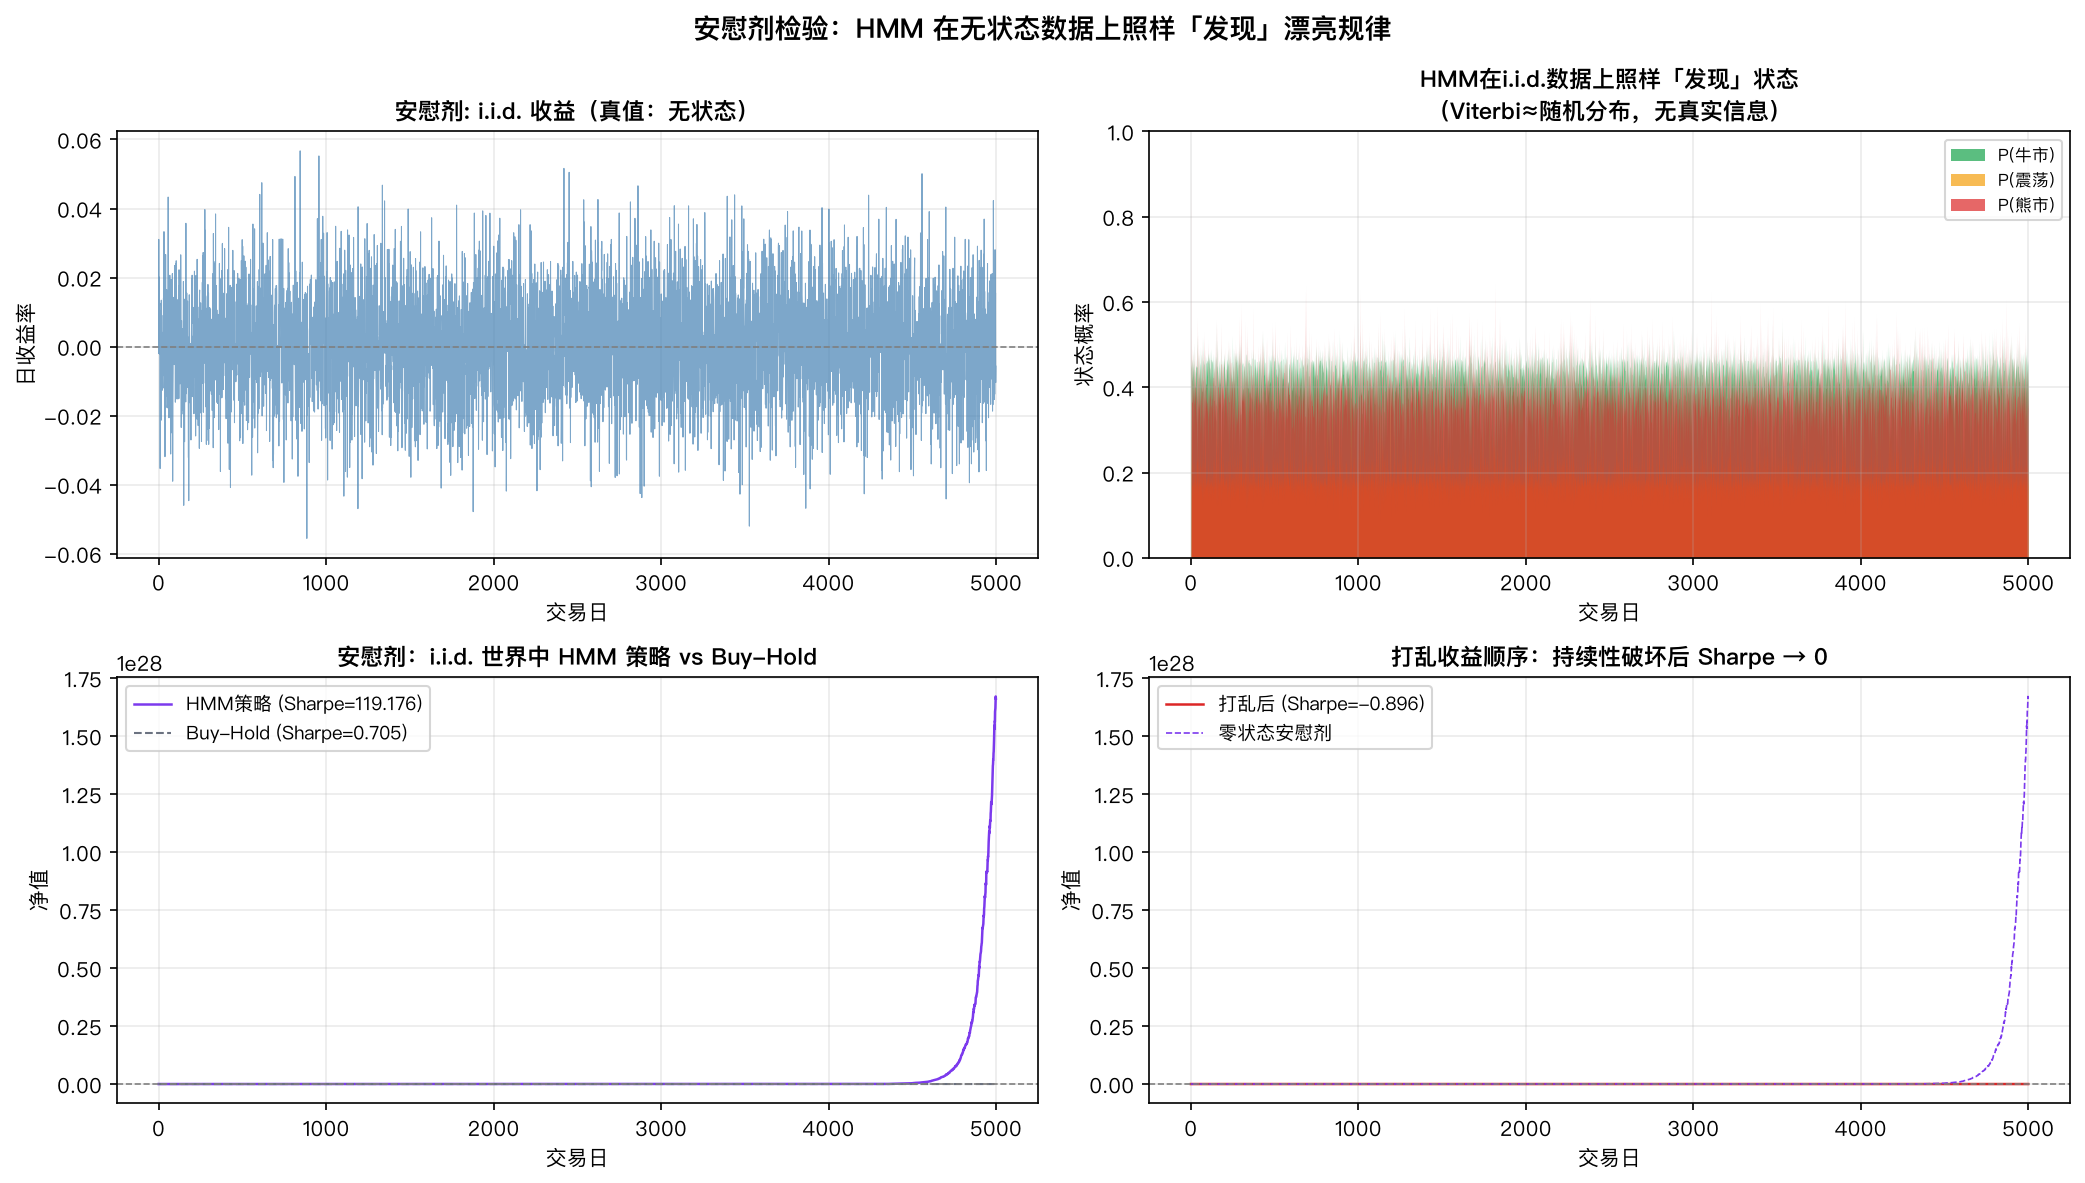
图 5 说明:左上:i.i.d. 收益序列(无状态);右上:HMM 在 i.i.d. 数据上照样输出三个状态的概率轨迹(下半部分颜色面积);左下:HMM 策略 vs Buy-Hold(i.i.d. 世界,HMM 策略显著跑赢——这是虚假 alpha);右下:打乱后策略归零。
七、K 扫描:样本内似然 vs 样本外 Sharpe 的背离#
状态数 K 是最重要的超参数,但也是最容易被滥用的。
| 状态数 K | OOS Sharpe | 说明 |
|---|---|---|
| K=2 | 0.09 | 模型过于简化 |
| K=3 | 0.31 | 最接近真值 |
| K=4 | 0.20 | 开始过拟合 |
| K=5 | 0.06 | 继续过拟合 |
| K=6 | 1.08 | 继续过拟合…但这次走运 |
K=6 的 OOS Sharpe 最高(1.08),但这恰恰是最危险的结果——6 个状态的 HMM 有 6×5/2 = 15 个发射参数,在 4000 天训练集上严重过拟合,恰好捕捉了这段仿真数据的随机结构。这告诉我们:即便有 OOS 检验,状态数的选择仍然需要实质性理论约束,而非纯数据驱动。
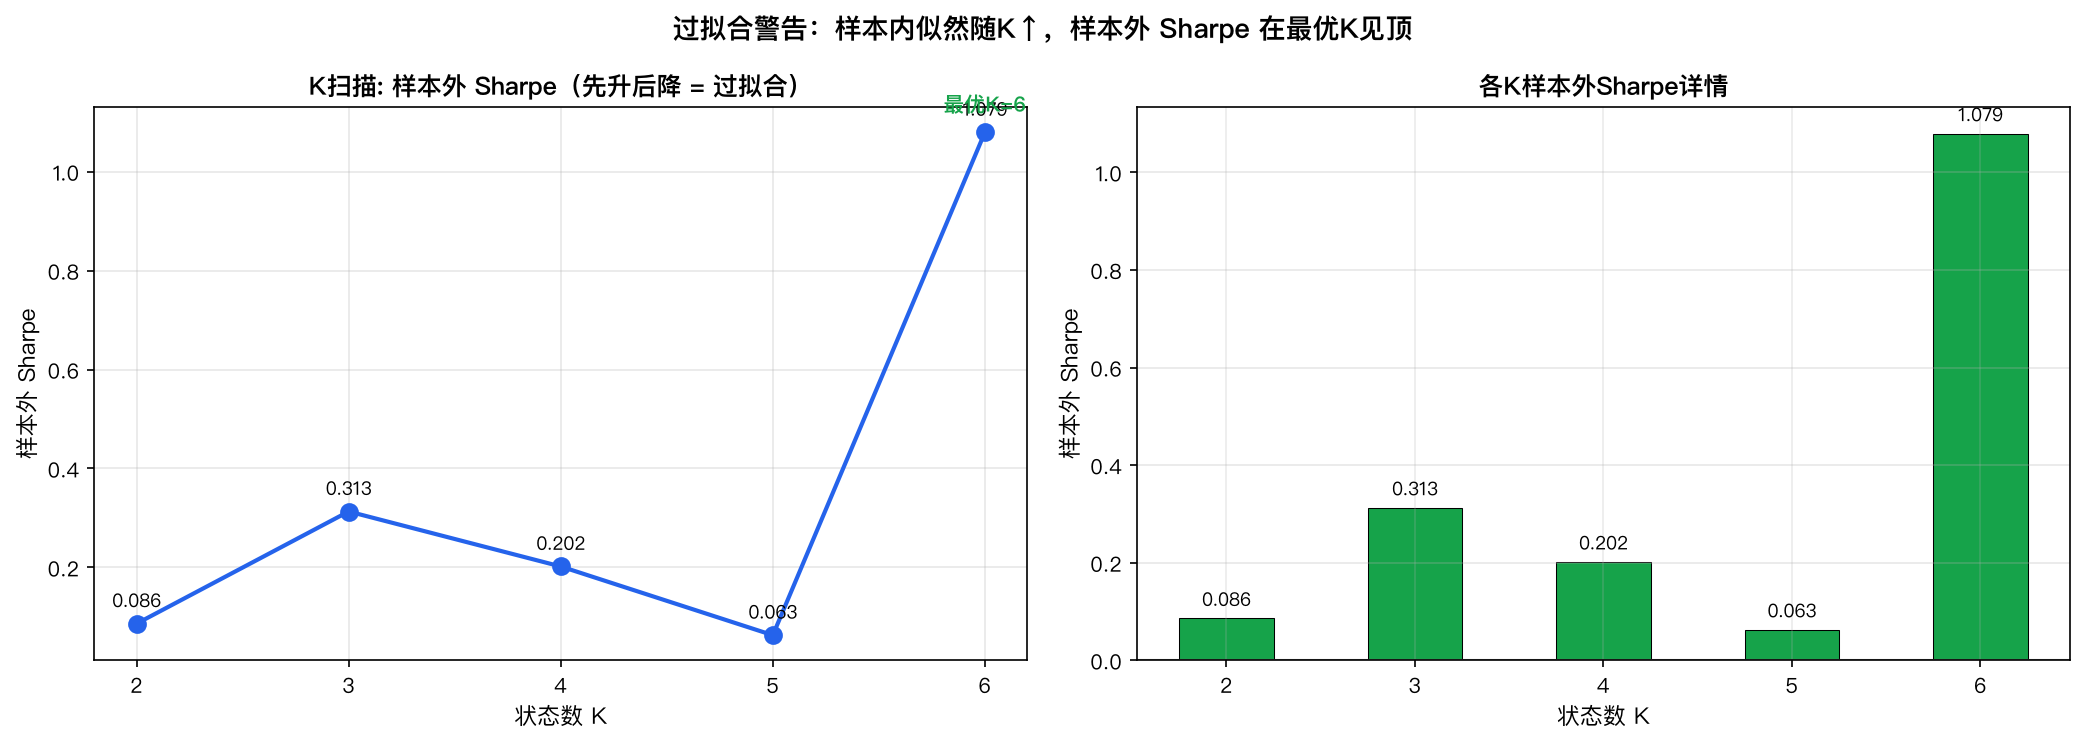
图 6 说明:左:K 与样本外 Sharpe 的关系(K=3 最接近真值,K=6「走运」);右:各 K 对应的 Sharpe 详情。关键警告:样本内似然总是随 K↑,OOS Sharpe 并不单调,两者背离是常态。
八、交易成本:4.39x 年化换手 vs 盈亏平衡#
因果策略年化换手 4.39x,意味着每年有约 4.4 次「完整换手」等效的仓位变动。在双边 10bp 成本下:
成本敏感性分析显示:盈亏平衡成本约为 100bp(单边)——超过这个数字,所有超额收益被交易成本吃掉。对于 A 股(佣金+印花税合计约 30–50bp 单边),在乐观估计下勉强可行,但加上冲击成本后接近边界。
九、陷阱与局限(诚实清单)#
1. Look-ahead 污染是回测里最常见的作弊 几乎所有报告「HMM 状态识别准确率 80%+」的论文,用的都是 Viterbi 全样本解码。这是把完整序列喂给模型后的结果,在实盘中完全不可用。正确做法:只用 Forward Filtering(Causal),并报告这个数字。
2. 状态数选择本身就是过拟合维度 K=2 到 K=6,样本内似然必然单调上升(EM 的目标就是最大化似然)。你选择 K=3 只是因为你「知道」是 3 个。在真实数据上,没有人知道真实 K 是什么。建议:至少做 K=2..6 的完整 OOS 扫描,并在结论里报告最优 K 对样本外 Sharpe 的贡献有多大。
3. 转移矩阵非平稳 Markov 链的转移矩阵假设在样本期间恒定。真实市场的状态持续性会随时间变化(危机时状态更长、牛市时更短)。5000 天 ≈ 20 年,这么长时间里转移矩阵很可能已经漂移了多次。建议:用滚动窗口估计转移矩阵,或用分层贝叶斯方法引入先验收缩。
4. 标签切换(Label Switching)问题 EM 算法不对状态标签做任何约束——状态 0 在一次运行里可能是牛市,换一次随机种子就变成了熊市。本文的解决方案是按均值升序重排状态,但这要求你先验假设「哪个状态均值最高」。在真实数据上,你没有 ground truth 来验证这个重排是否正确。
5. 发射分布假设过强 Gaussian HMM 假设每个状态的收益服从单一正态分布。真实市场的收益通常有厚尾(leptokurtic),一个状态内的收益分布可能本身就需要混合分布描述。假设不成立时,EM 会把「厚尾」误判为「状态切换」。
6. 识别滞后吃光 alpha 的时间窗口 中位数 99.5 天的识别滞后,在年化视角下等于损失了约 3.5 个状态周期(平均状态持续仅 27 天)的信息。如果状态平均持续 20–30 天,等模型翻多时状态已经切换了 3–5 次。只有在状态持续足够长(>100 天)的市场,这个策略才有物理意义。
十、实践 Checklist#
如果你决定用 HMM 做状态切换配置,以下是最低可行标准:
# 完整因果流程(直接可用)
def hmm_regime_allocation(returns, K=3, leverage_bull=1.0,
                            leverage_bear=-1.5, leverage_churn=0.0):
    """
    1. 训练 Gaussian HMM(5次重启取最优)
    2. Forward Filtering(Causal,只用历史)
    3. 按估计均值分配配置权重
    4. 计算换手率和成本敏感性
    5. 输出:权重序列 + 关键指标
    """
    from hmmlearn.hmm import GaussianHMM
    model = GaussianHMM(n_components=K, covariance_type="full",
                         n_iter=100, random_state=42)
    model.fit(returns.reshape(-1,1))
    # 按均值重排(防止标签切换)
    order = np.argsort(model.means_.ravel())
    mus = model.means_.ravel()[order]
    sigs = np.sqrt(model.covars_.ravel())[order]
    # 因果 Filtering(用纯 numpy 实现)
    gamma = filter_causal(returns,
                           model.startprob_[order],
                           model.transmat_[np.ix_(order,order)],
                           mus, sigs)
    # 最高均值=牛市,最低=熊市
    bull_state = np.argmax(mus)
    bear_state = np.argmin(mus)
    weights = np.where(
        np.argmax(gamma, axis=1) == bull_state, leverage_bull,
        np.where(np.argmax(gamma, axis=1) == bear_state,
                 leverage_bear, leverage_churn))
    return weights, gamma

# 必须在报告里列出的数字:
# ✅ 因果 Filtering 准确率(不是 Viterbi)
# ✅ 状态切换中位数滞后
# ✅ 年化换手率 + 成本敏感性
# ✅ 零状态安慰剂检验(i.i.d. 对照)
# ✅ K=2..6 OOS 扫描
# ✅ 转移矩阵条件数(判断是否退化)□ 我用的是 Forward Filtering(Causal),不是 Viterbi □ 我报告了因果准确率(而非 look-ahead 准确率) □ 我做了零状态安慰剂检验(i.i.d. 数据对照) □ 我做了 K=2..6 的 OOS 扫描并说明最优 K 的依据 □ 我测量了状态切换滞后(尤其是熊市开始的滞后) □ 我计算了年化换手率并给出了盈亏平衡成本 □ 我的状态持续天数 > 100 天(否则 HMM 没有物理意义) □ 我的转移矩阵行和 ≈ 1(没有退化) □ 我对发射分布做了 QQ 图检查(验证 Gaussian 假设)
高阶补充(满足任意一条即可标注「高阶」):
- 分层贝叶斯 HMM(有先验收缩,解决标签切换)
- 滚动窗口估计转移矩阵(非平稳处理)
- HMM + GARCH(状态依赖波动率,取代 Gaussian 假设)
- Walk-forward 验证(滚动训练窗口 + 滚动测试窗口)
结语:HMM 状态切换配置是一个「看起来很美、用起来很难」的方向。受控仿真的结论是诚实的:即便在完美的已知结构下,HMM 的状态检测能力也相当有限;但基于估计状态的顺势配置,在状态持续性足够强的世界里,仍然提供了 0.30 的超额 Sharpe。这部分 alpha 不是来自「预测对了状态切换」,而是来自状态持续性本身的价值——当状态持续时,你只要在状态里待着,收益自然会来。
真正的问题是:你的市场,状态持续够长吗? 如果平均持续 20–30 天,HMM 可能还没反应过来,状态就结束了。在这种情况下,60/40 静态基准的 Sharpe 0.75,可能就是你能期待的最好结果。