再平衡溢价与波动率收割:那顿「免费午餐」到底是谁付的钱
教科书说再平衡能白赚「分散化收益」,公式 0.5(w'σ² − w'Σw) 在 4 资产 30% 波动零相关下算出 3.38pp/年。但这个数字对标的根本不是买入持有——受控模拟 400 条路径显示,对标成分股几何均值确实拿到 3.37pp(与理论完美吻合),对标买入持有却只剩 0.86pp,中位数 1.32pp,标准差 1.95pp,5% 分位 −3.19pp,四分之一路径为负。三个杀手逐一量化:资产预期收益差异 ±4% 时溢价归零、±15% 时 −8.20pp 且 120 条路径无一为正;相关系数 0.9 时只剩 0.02pp;每日再平衡在 25bp 成本下转负 −0.19pp,而每年再平衡还有 0.78pp——频率越高越怕成本。最实用的结论来自阈值检验:±10% 阈值一年只调 0.9 次却拿到 0.87pp,高于月度日历的 0.76pp,也高于 ±1% 阈值的 0.50pp(一年调 61 次)。再平衡溢价不是免费午餐,是一份做空动量的头寸(中阶)
问题:一顿被反复宣传的「免费午餐」#
资产配置领域流传着一个非常诱人的说法:定期把组合调回目标权重,能凭空多赚一块收益。它有正式名字叫「分散化收益」(diversification return)或「再平衡溢价」,还有个漂亮的公式:
代入一组常见参数——4 个资产、每个年化波动 30%、两两不相关、等权配置——算出来是 3.38 个百分点每年。白捡三个多点,还不用预测任何东西,只需要机械地卖出涨得多的、买入跌得多的。
听上去太好了。所以本文只做一件事:把这 3.38pp 拆开,看它到底是不是真的,以及是从谁的口袋里出来的。
先说结论:公式没错,但它对标的基准不是你以为的那个。而当你换成真正关心的基准(买入持有)之后,3.38pp 会缩水到 0.86pp,并且有四分之一的概率是负的。
先把机制说清楚:钱从哪来#
再平衡赚钱的机制其实很朴素。假设两个资产,各投一半:
- 第一年 A 涨 50%、B 跌 50%。年末权重变成 A 占 75%、B 占 25%。
- 再平衡:卖掉 A 的一部分,买入 B,调回 50/50。
- 第二年 A 跌回原位、B 涨回原位。
因为你在 B 便宜的时候多买了,B 涨回来时你手上的 B 更多,最终净值高于什么都不做。本质是低买高卖,但不需要预测——波动本身提供了低买高卖的机会。 这就是「波动率收割」这个名字的由来。
反过来说,这也立刻暴露了它的软肋:如果 A 涨了之后继续涨,再平衡就是在不断卖出赢家、买入输家。再平衡溢价的另一面,是一份结构性做空动量的头寸。 这句话是理解后面所有数字的钥匙。
受控模拟:先复现,再质疑#
用几何布朗运动生成 4 个资产、30 年日频数据,参数完全对称(都是 6% 漂移、30% 波动、两两零相关),这样任何差异都只能来自再平衡本身,不会来自资产强弱:
TD = 252

def gen_paths(n_assets, years, mu, sigma, rho, rng, dt=1.0/TD):
    n = int(years * TD)
    mu = np.full(n_assets, mu) if np.isscalar(mu) else np.asarray(mu)
    sigma = np.full(n_assets, sigma) if np.isscalar(sigma) else np.asarray(sigma)
    C = np.full((n_assets, n_assets), rho)
    np.fill_diagonal(C, 1.0)
    Z = rng.standard_normal((n, n_assets)) @ np.linalg.cholesky(C).T
    # 算术漂移 mu 对应的对数漂移是 mu - sigma^2/2
return (mu - 0.5*sigma**2)*dt + sigma*np.sqrt(dt)*Z两个组合引擎,区别只在要不要调回目标权重:
def buy_and_hold(simple_r, w0):
    """不再平衡:权重随涨跌自由漂移"""
    units = np.array(w0, dtype=float)
    eq = [1.0]
    for t in range(len(simple_r)):
        units = units * (1.0 + simple_r[t])
        eq.append(units.sum())
    return np.array(eq)

def rebalanced(simple_r, w0, period, cost_bps=0.0, band=None):
    """period: 每 period 个交易日调仓;band: 改用偏离阈值触发"""
    w0 = np.array(w0, dtype=float)
    units = w0.copy()
    eq = [1.0]
    n_rebal = 0
    for t in range(len(simple_r)):
        units = units * (1.0 + simple_r[t])
        v = units.sum()
        w = units / v
        do = (np.max(np.abs(w - w0)) > band) if band is not None \
             else ((t + 1) % period == 0)
        if do:
            traded = np.abs(w0 * v - units).sum()
            v -= traded * cost_bps / 1e4          # 双边成本按成交额计
            units = w0 * v
            n_rebal += 1
        eq.append(v)
return np.array(eq), n_rebal跑一条 30 年路径,月度再平衡、零成本:
| CAGR | 年化波动 | 最大回撤 | |
|---|---|---|---|
| 买入持有 | 4.46% | 20.8% | −55.5% |
| 月度再平衡 | 4.50% | 15.1% | −43.8% |
溢价只有 0.04 个百分点。 说好的 3.38pp 呢?
但注意另外两列:波动率从 20.8% 降到 15.1%,最大回撤从 −55.5% 收窄到 −43.8%。再平衡真正稳定交付的从来不是收益,是风险控制。
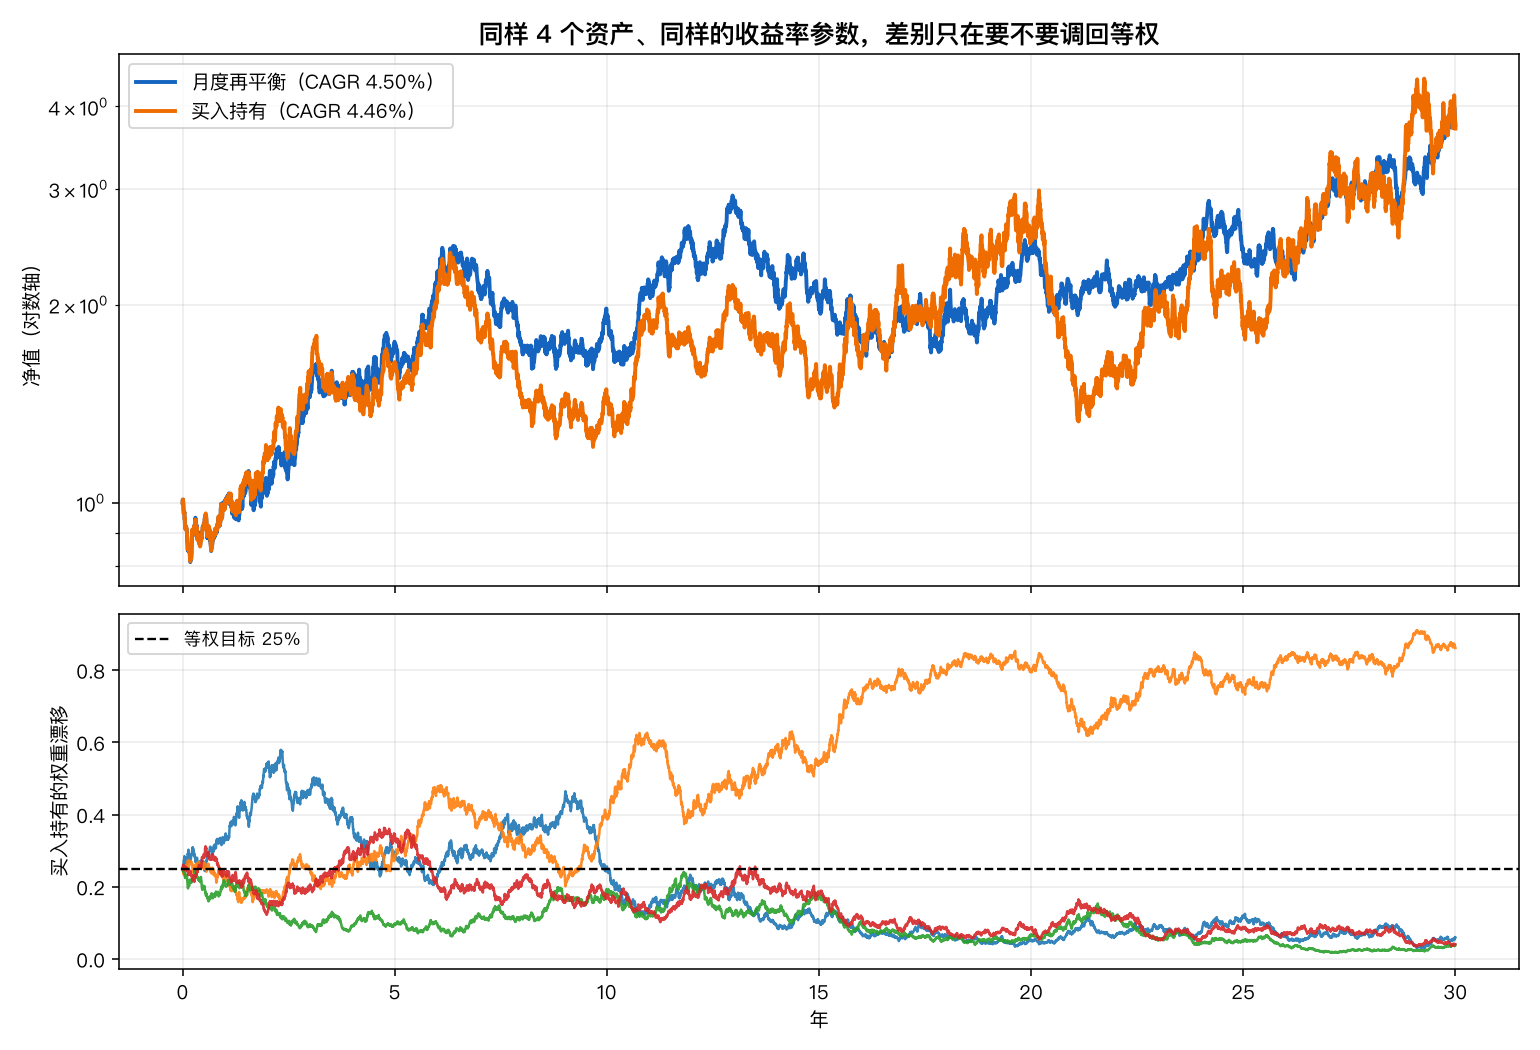
下半张图解释了为什么:买入持有的权重会一路漂移,30 年后某个资产可能占到组合的一大半——你以为在持有一个 4 资产分散组合,实际上早就变成了单押。
3.38pp 去哪了:公式对标的不是买入持有#
这是本文最关键的一点,也是这个「免费午餐」传说被误传最多的地方。
那个漂亮公式度量的是「再平衡组合的几何收益」减去「各成分股几何收益的加权平均」,而不是减去「买入持有组合的几何收益」。这两个基准完全不同。
在同一批模拟里同时算这两个差值:
| 对标基准 | 溢价 |
|---|---|
| 成分股几何收益的平均(教科书口径) | 3.37pp |
| 买入持有组合(你实际关心的) | 0.86pp |
| 理论公式预测 | 3.38pp |
3.37 vs 理论 3.38——公式完全正确。它没骗人,只是它回答的问题是「再平衡组合 vs 单个资产的平均表现」。
而买入持有组合本身已经享受了分散化的好处(它也是个组合,不是单个资产),所以它早就把那 3.38pp 里的大部分吃掉了。再平衡相对它的增量,只剩 0.86pp。
引用这个公式的时候如果不说清楚基准,等于什么都没说。 很多「再平衡每年多赚 3%」的宣传,就是把对标成分股平均的数字,说成了对标买入持有的数字。
那 0.86pp 靠得住吗:400 条路径#
单条路径的 0.04pp 可能只是运气差。跑 400 条独立路径看分布:
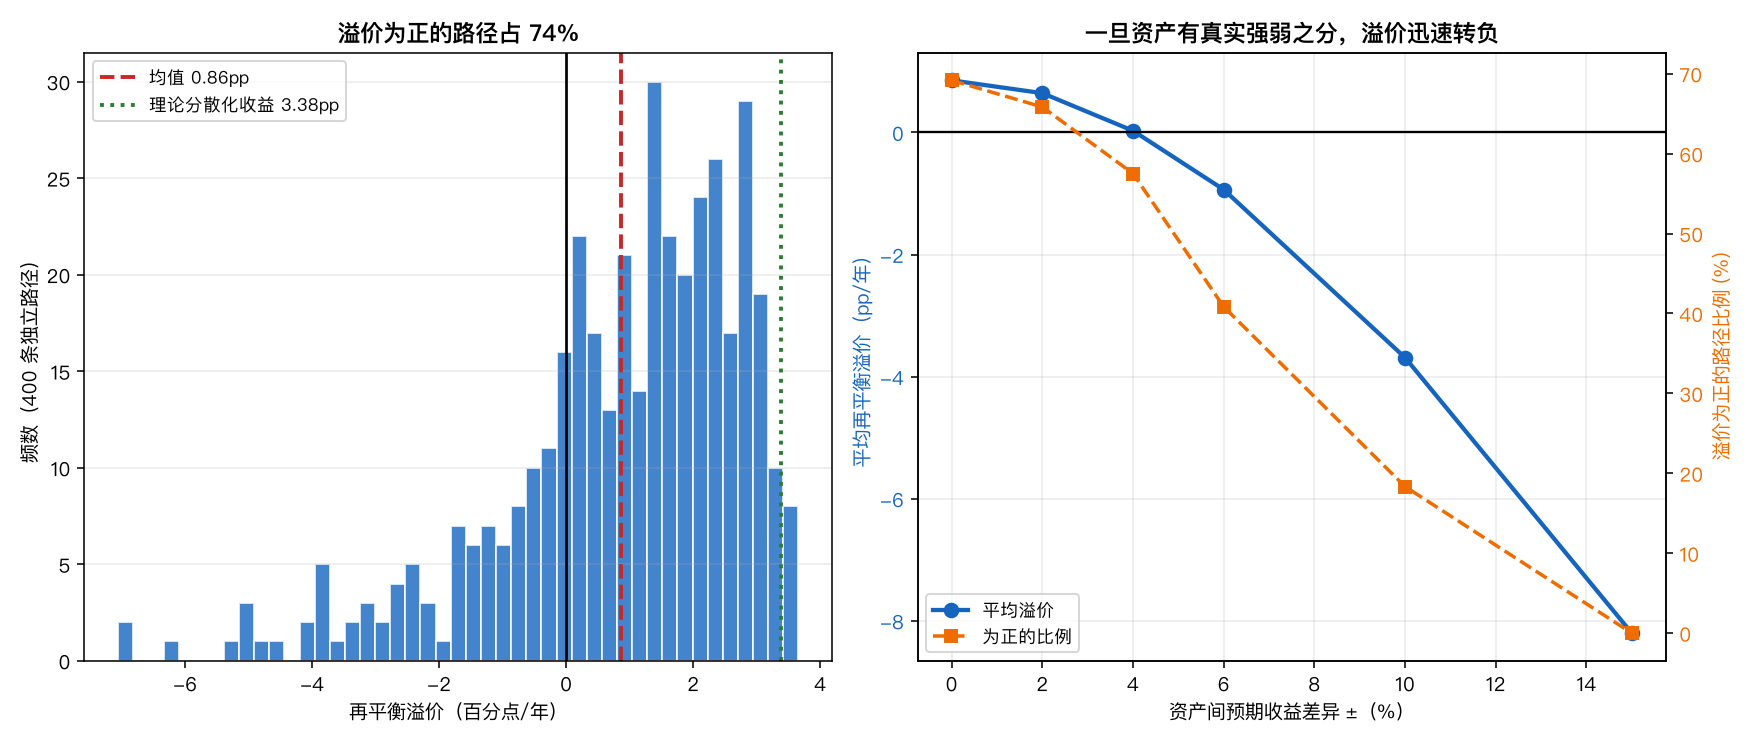
| 统计量 | 值 |
|---|---|
| 平均溢价 | 0.86pp |
| 中位数 | 1.32pp |
| 标准差 | 1.95pp |
| 为正的比例 | 74.5% |
| 5% 分位 | −3.19pp |
| 95% 分位 | +3.15pp |
平均确实为正,中位数还更高一点(分布左偏)。但标准差 1.95pp 是均值 0.86pp 的两倍多,四分之一的路径溢价为负,最差 5% 的情况要亏 3.19pp/年——三十年下来这不是小数目。
在最理想的实验室条件下(资产完全对称、零成本、零相关),再平衡溢价仍然有四分之一的概率不出现。 说它是「免费午餐」显然过了;更准确的说法是「一个期望为正、方差不小的赌注」。
而且别忘了,上面这些还是最理想的设定。下面把三个现实条件逐个加回去。
杀手一:资产之间有真实强弱#
前面的模拟里 4 个资产预期收益完全相同。现实中不可能——股票和债券、成长和价值、美股和新兴市场,长期预期收益差异巨大。
保持其他条件不变,让 4 个资产的预期收益在 之间均匀分布:
| 收益差异 | 平均溢价 | 为正的比例 |
|---|---|---|
| ±0% | +0.85pp | 69.2% |
| ±2% | +0.64pp | 65.8% |
| ±4% | +0.03pp | 57.5% |
| ±6% | −0.94pp | 40.8% |
| ±10% | −3.69pp | 18.3% |
| ±15% | −8.20pp | 0.0% |
资产间预期收益差异达到 ±4% 时,溢价就归零了。 ±15% 时不仅平均亏 8.20pp,而且 120 条路径里没有一条为正。
原因回到前面那句话:再平衡是结构性做空动量。当资产有真实的长期强弱之分时,「卖出涨得好的、买入跌得多的」就变成了系统性地从赢家换到输家。±4% 的收益差异在跨资产类别配置里是常态而非例外——这意味着现实中的多资产组合,再平衡溢价大概率在零附近甚至为负。
这也解释了一个常见困惑:为什么长期股债再平衡组合的收益,往往跑不赢单纯持有股票?因为你在过去几十年里持续地把股票的涨幅换成了债券。你换来的是波动和回撤的下降——那才是股债再平衡真正买到的东西。
杀手二:相关性#
分散化收益的公式里, 项随相关性上升而变大,溢价随之缩小。模拟验证:
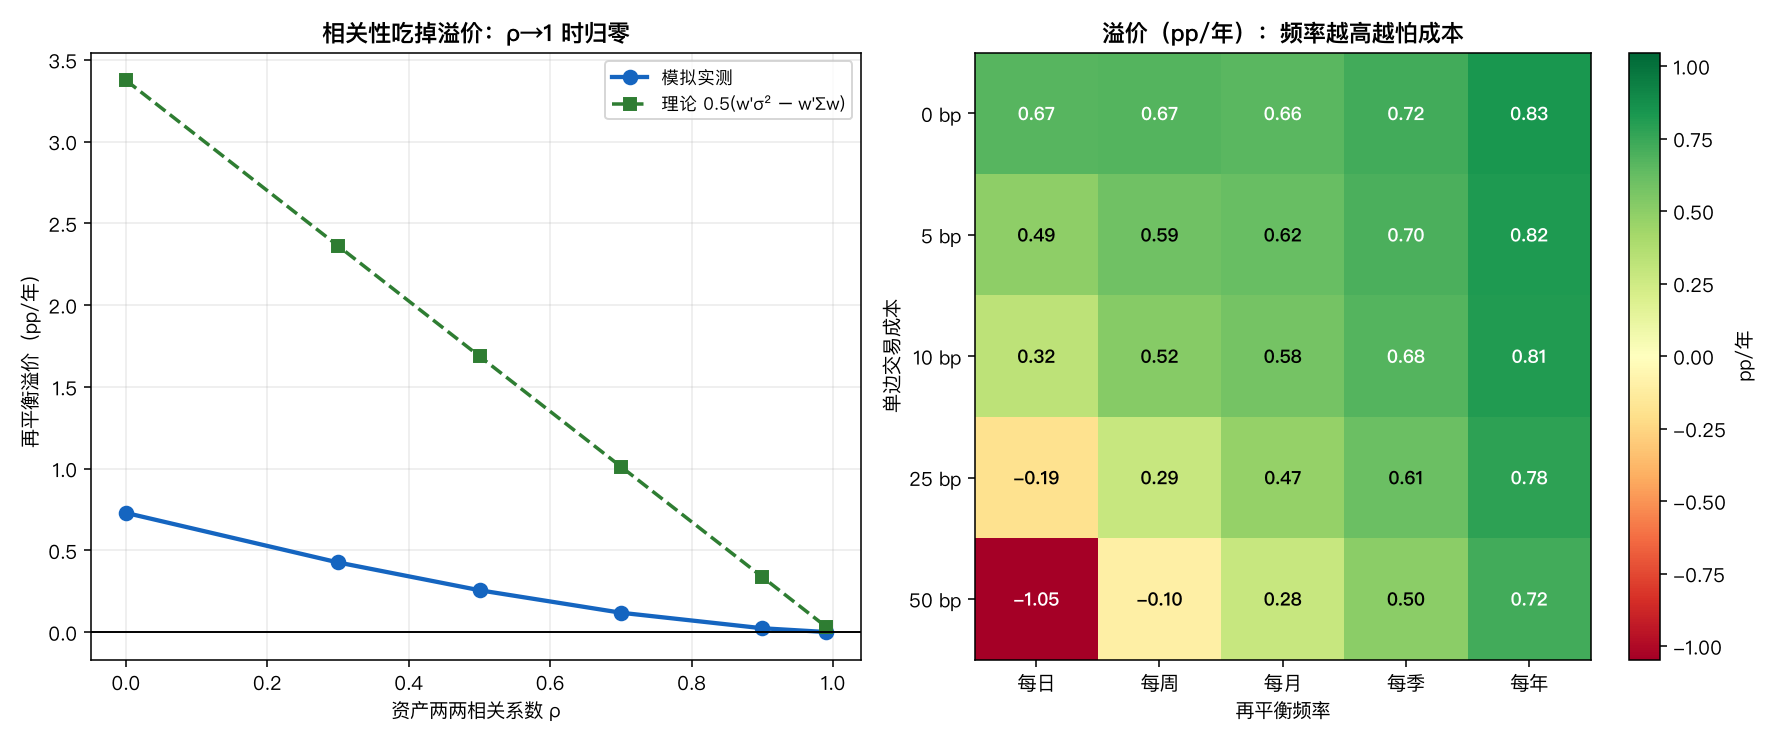
| 相关系数 ρ | 实测溢价(对标买入持有) | 理论 DR(对标成分平均) |
|---|---|---|
| 0.0 | 0.73pp | 3.38pp |
| 0.3 | 0.43pp | 2.36pp |
| 0.5 | 0.26pp | 1.69pp |
| 0.7 | 0.12pp | 1.01pp |
| 0.9 | 0.02pp | 0.34pp |
| 0.99 | 0.00pp | 0.03pp |
两条曲线都单调递减到零,形状一致(再次印证公式的结构是对的),但量级始终差着一个基准。
实践含义很残酷:危机时刻正是相关性冲向 1 的时刻。你最需要分散化的时候,恰恰是分散化收益消失的时候。这和Copula 尾部依赖风险描述的是同一个现象的两面。
杀手三:交易成本,以及频率的最优解#
再平衡要交易,交易要花钱。把频率和单边成本做成网格(数值为对标买入持有的溢价,pp/年):
| 每日 | 每周 | 每月 | 每季 | 每年 | |
|---|---|---|---|---|---|
| 0 bp | 0.67 | 0.67 | 0.66 | 0.72 | 0.83 |
| 5 bp | 0.49 | 0.59 | 0.62 | 0.70 | 0.82 |
| 10 bp | 0.32 | 0.52 | 0.58 | 0.68 | 0.81 |
| 25 bp | −0.19 | 0.29 | 0.47 | 0.61 | 0.78 |
| 50 bp | −1.05 | −0.10 | 0.28 | 0.50 | 0.72 |
两个发现:
第一,零成本那一行几乎是平的(0.66~0.83)。再平衡得更勤并不能收割更多波动——这可能是最反直觉的一点。很多人以为每日再平衡能抓住更多低买高卖的机会,但日频波动大多是噪声,来回抵消,年频再平衡反而略高。
第二,频率越高,对成本越敏感。 每日再平衡在 25bp 成本下就转负(−0.19pp),50bp 时亏 1.05pp;而每年再平衡在 50bp 下仍有 0.72pp。因为换手率随频率线性上升,收益却不上升——这是一个纯粹的负和权衡。
结论直白:没有任何理由做高频再平衡。
更好的做法:阈值触发#
日历再平衡有个明显的浪费:到日子了不管权重偏没偏都要调。阈值再平衡只在偏离超过阈值时才动手。在 25bp 成本下对比:
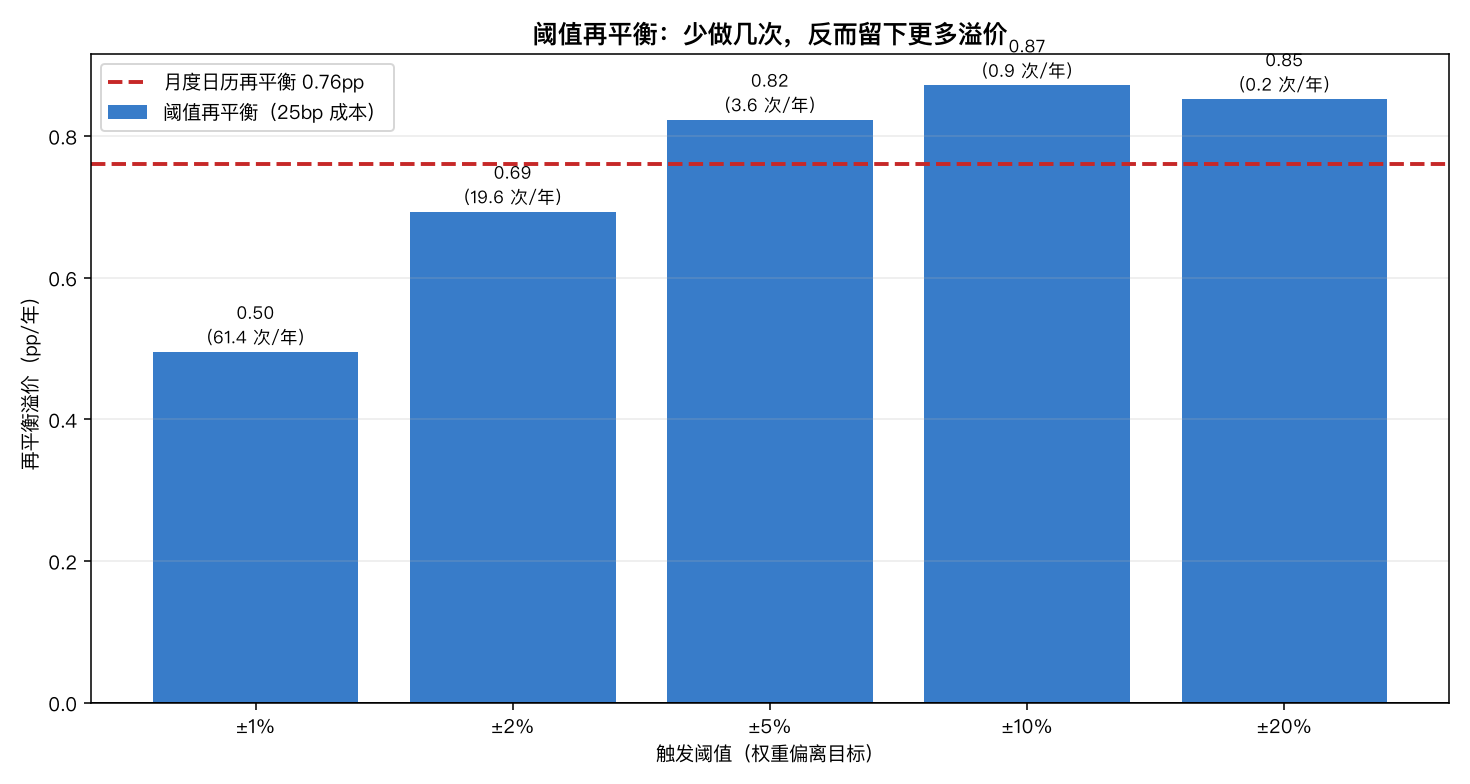
| 触发阈值 | 溢价 | 调仓次数/年 |
|---|---|---|
| ±1% | 0.50pp | 61.4 |
| ±2% | 0.69pp | 19.6 |
| ±5% | 0.82pp | 3.6 |
| ±10% | 0.87pp | 0.9 |
| ±20% | 0.85pp | 0.2 |
| 月度日历(对照) | 0.76pp | 12 |
±10% 阈值一年只调 0.9 次,却拿到 0.87pp,比月度日历的 0.76pp 更高。 用不到十分之一的交易次数,换来更好的结果。
而 ±1% 阈值一年调 61 次,溢价只剩 0.50pp——过度勤奋直接吃掉三分之一以上的溢价。曲线在 ±10% 附近见顶后走平,说明阈值太宽也会开始损失(权重漂移太远,风控意义丧失)。
这个结论和换手率约束下的组合优化里的「无交易区间」思想是一致的:最优策略不是持续贴近目标,而是允许一个合理的漂移带。
诚实边界#
第一,全部结论基于几何布朗运动模拟,而 GBM 没有动量也没有均值回归。 这是最重要的一条限制。GBM 的收益是独立同分布的,这恰好是再平衡的中性环境。真实市场有中期动量(会伤害再平衡)也有长期均值回归(会帮助再平衡),两者的净效应取决于你的再平衡周期和市场的自相关结构——本文的模拟完全没有覆盖这一层。要判断某个具体组合该不该再平衡,必须用该组合的真实历史数据重跑。
第二,忽略了税收。 应税账户里,再平衡卖出盈利头寸会立刻产生资本利得税,这个成本远高于本文用的 25bp 交易成本量级,而且是不可逆的现金流出。再平衡的税制与换手率摩擦专门讨论了这个问题,结论是税收可以完全吃掉溢价——本文的成本模型只算了交易佣金和冲击,在应税账户里应该把上面所有数字再打一次折。
第三,假设了权重目标本身是对的。 全文都在讨论「怎么调回目标权重」,但没有讨论「目标权重该是多少」。如果等权本身就不是好配置,再平衡只是让你更稳定地待在一个次优点上。目标权重的选择对长期结果的影响,比再平衡频率大一个数量级。
第四,30 年 × 400 条路径仍然是有限样本。 5% 分位 −3.19pp 这个数字本身也有估计误差;更长的历史或更极端的市场环境(如单一资产长期崩溃)可能产生超出模拟范围的结果。
归宿#
再平衡溢价是真的,但它不是免费午餐,也远没有教科书公式看上去那么大。
三个数字值得记住:理论公式的 3.38pp 对标的是成分股平均,换成买入持有只剩 0.86pp;四分之一的路径为负;资产间预期收益差异超过 ±4% 就归零。
真正稳健的收获在别处——本文单条路径上,波动率从 20.8% 降到 15.1%,最大回撤从 −55.5% 收窄到 −43.8%。这两个数字比那 0.86pp 可靠得多,也重要得多。 把再平衡当成风控工具,它是称职的;当成收益来源,它会让你失望。
至于怎么做:用 ±5% 到 ±10% 的阈值触发,别用高频日历。一年调不到一次,效果好过每月调一次,交易成本还只有零头。
最后回到那句钥匙——再平衡是一份结构性做空动量的头寸。如果你相信手上的资产之间存在持续的强弱差异,那么再平衡不是在帮你,是在收你的过路费。想清楚这一点,比记住任何公式都有用。