Microprice 微观价格:用挂单量加权修正中间价的方向偏差
中间价被锁死在 tick 网格上,价差以内的信息它一点都看不见。受控模拟 6 万个盘口快照(隐藏有效价格已知)量化:追踪真实有效价格,中间价 RMSE 0.288 分,挂单量加权中间价 0.142 分(改善 50.8%),非参数校准后的微观价格 0.106 分(改善 63.0%)。信号方向命中率下一个快照 85.2%,但衰减极快——h=10 掉到 59.9%,h=100 只剩 52.4%,几乎回到抛硬币。价差越宽越有用:1 tick 时改善 50.7%,8 tick 时 53.6%。五项对抗式检验全过:去掉信息机制的安慰剂盘口改善转为 −2.32%、相关系数 0.007 干净归零;买卖方向标反 RMSE 恶化 58.15%;样本内 63.08% 与样本外 63.04% 几乎无差(大样本下不过拟合),但 200 个样本配 40 个分箱时校准表直接退化成中间价。最容易被误读的是命中率 85% 这个数字——它预测的是价差内部的抖动,不是能覆盖成本的方向性行情(中阶)
问题:中间价是个被 tick 网格锁死的粗糙估计#
盘口上买一 10.00、卖一 10.01,中间价 10.005。这个数字看起来天经地义,但它有个致命的性质:只要买一卖一不变,无论盘口挂单量怎么变化,中间价永远是 10.005。
现在看两个盘口:
| 买一价 | 买一量 | 卖一价 | 卖一量 | 中间价 | |
|---|---|---|---|---|---|
| 盘口 A | 10.00 | 5000 手 | 10.01 | 100 手 | 10.005 |
| 盘口 B | 10.00 | 100 手 | 10.01 | 5000 手 | 10.005 |
两个盘口的中间价一模一样。但任何做过盘口的人都知道,这是完全相反的两种局面:盘口 A 买方堆了 5000 手、卖方只剩 100 手,下一笔主动买单就能吃穿卖一,价格几乎必然向上跳;盘口 B 反过来。
中间价把这个信息全扔了。它的取值被锁在 tick 网格的半格上,而真实的「有效价格」——那个如果市场连续可分、你能立刻无成本成交的公允价——在价差内部连续游走。价差 1 分钱的时候,中间价的误差最大就是半分钱;听着不多,但对做市商来说,半分钱就是全部利润。
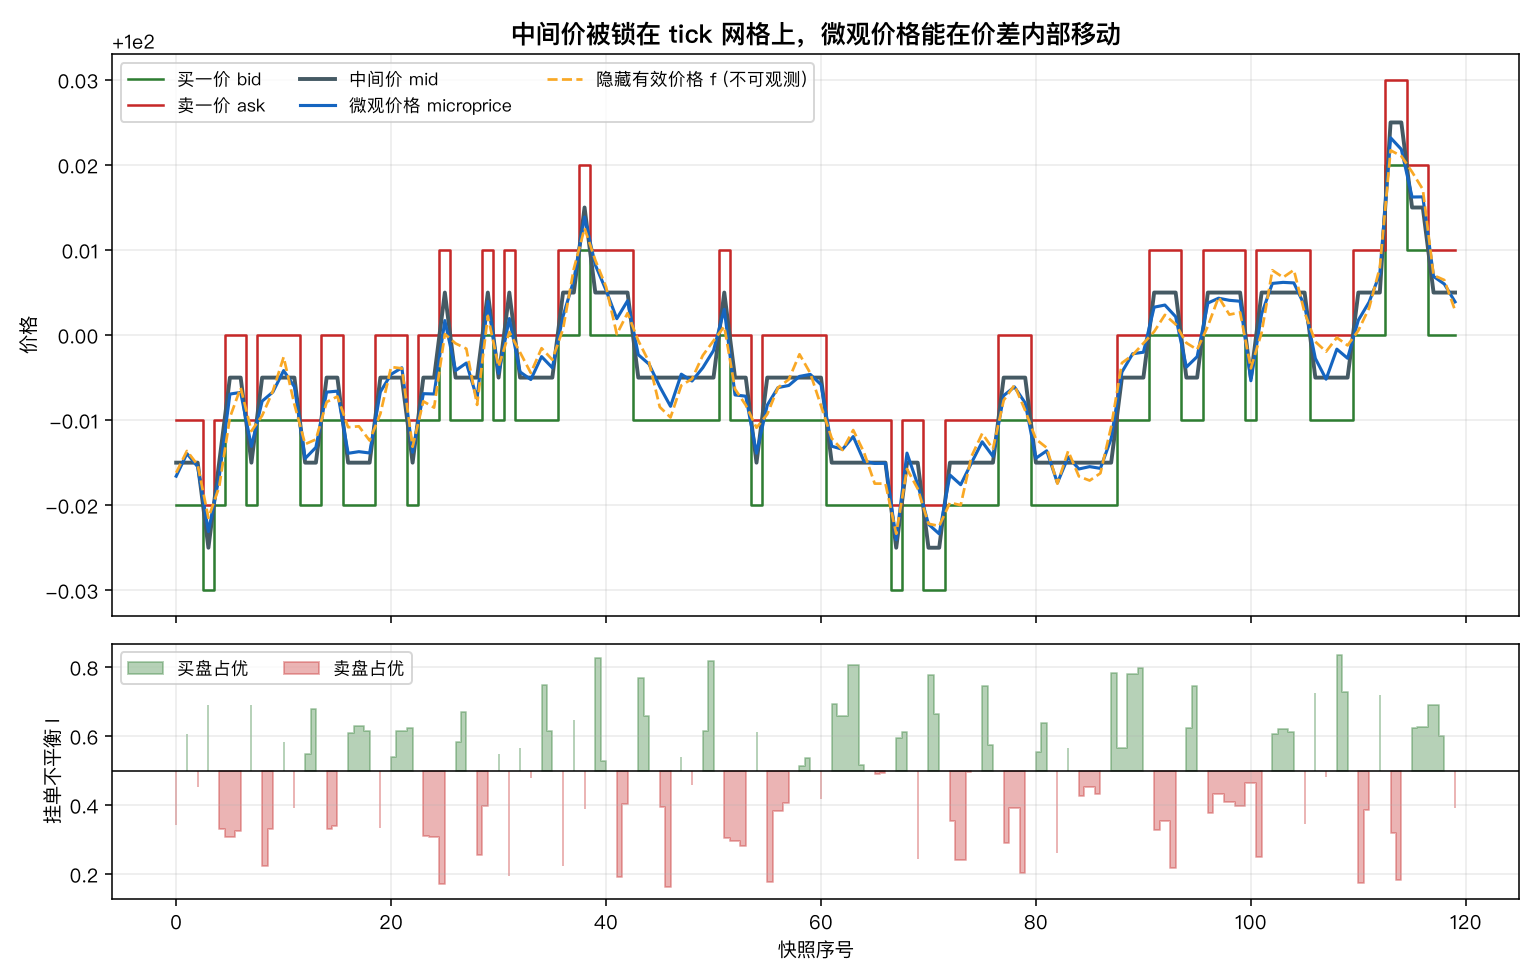
上图是本文模拟的一段盘口。橙色虚线是隐藏的真实有效价格(现实中不可观测,模拟里我们知道),深灰色阶梯是中间价——它被 tick 网格锁死,只能跳格;蓝色线是微观价格,它能在价差内部平滑移动,明显更贴近橙线。下半部分是挂单不平衡:绿色代表买盘占优,红色代表卖盘占优。
微观价格:最朴素的那版#
最直接的修正叫加权中间价(weighted mid),也常被直接称为 microprice:
注意这个交叉加权:买一量 乘的是卖一价 。第一次看总觉得反了,但方向是对的——买盘挂单堆得越厚,说明买方支撑越强、卖一越容易被吃穿,有效价格就越靠近卖一价。
import numpy as np

def weighted_mid(bid, ask, bid_size, ask_size):
    """加权中间价:买盘越厚,价格越靠近卖一"""
    return (ask * bid_size + bid * ask_size) / (bid_size + ask_size)

def imbalance(bid_size, ask_size):
    """挂单不平衡,取值 [0, 1],>0.5 表示买盘占优"""
    return bid_size / (bid_size + ask_size)

# 前面表格里的两个盘口
print(weighted_mid(10.00, 10.01, 5000, 100))   # 10.00980  -> 贴近卖一
print(weighted_mid(10.00, 10.01, 100, 5000)) # 10.00020 -> 贴近买一同样的中间价 10.005,微观价格给出 10.0098 和 10.0002,跨度接近一整个价差。这就是被中间价扔掉的那部分信息。
写成不平衡的形式更容易看清结构:令 ,则
其中 是价差。所以微观价格就是中间价加上一个「不平衡 × 价差」的线性修正项,修正幅度天然被限制在半个价差以内。
它到底有多准:用已知答案的模拟来验#
真实市场里没人知道「真实有效价格」是多少,所以无法直接算误差。解决办法是做受控模拟:我自己造一个隐藏的有效价格 让它随机游走,再按一个明确的机制生成盘口——有效价格越靠近卖一,卖一队列越容易被吃掉、挂单量越小。这是真实市场里不平衡携带信息的核心机制。
TICK = 0.01

def simulate_lob(n, rng, info=True, sigma=0.004, spread_ticks=1):
    """隐藏有效价格 f 随机游走;盘口在 tick 网格上把它夹住。
    info=True 时挂单量携带 f 在价差内的位置信息;False 为安慰剂对照。"""
    f = 100.0
    out = []
    for _ in range(n):
        f += rng.normal(0, sigma)
        bid = np.floor(f / TICK) * TICK
        ask = bid + spread_ticks * TICK
        theta = np.clip((f - bid) / (ask - bid), 0, 1)   # f 在价差内的相对位置
        if info:
            # f 越靠近卖一(theta→1),卖一队列越薄
            ask_size = 200.0 * (1.15 - theta) + rng.gamma(2.0, 25.0)
            bid_size = 200.0 * (0.15 + theta) + rng.gamma(2.0, 25.0)
        else:
            ask_size = 130.0 + rng.gamma(2.0, 25.0)
            bid_size = 130.0 + rng.gamma(2.0, 25.0)
        out.append((bid, ask, max(bid_size, 1), max(ask_size, 1), f))
return map(np.array, zip(*out))6 万个快照、1 tick 价差,用后一半样本做样本外评估,比较三种估计对隐藏 的追踪误差:
| 估计量 | RMSE(分) | 相对中间价改善 |
|---|---|---|
| 中间价 mid | 0.288 | — |
| 加权中间价 weighted mid | 0.142 | 50.8% |
| 校准后的微观价格 | 0.106 | 63.0% |
加权中间价把追踪误差直接砍掉一半,而且这一半是白捡的:不需要估任何参数,两个价格两个挂单量,一行算术。
校准曲线:线性修正其实不够好#
加权中间价隐含假设「偏移量随不平衡线性变化」。真的是这样吗?把样本按不平衡分成 25 组,每组算实际偏移 的均值,画出来:
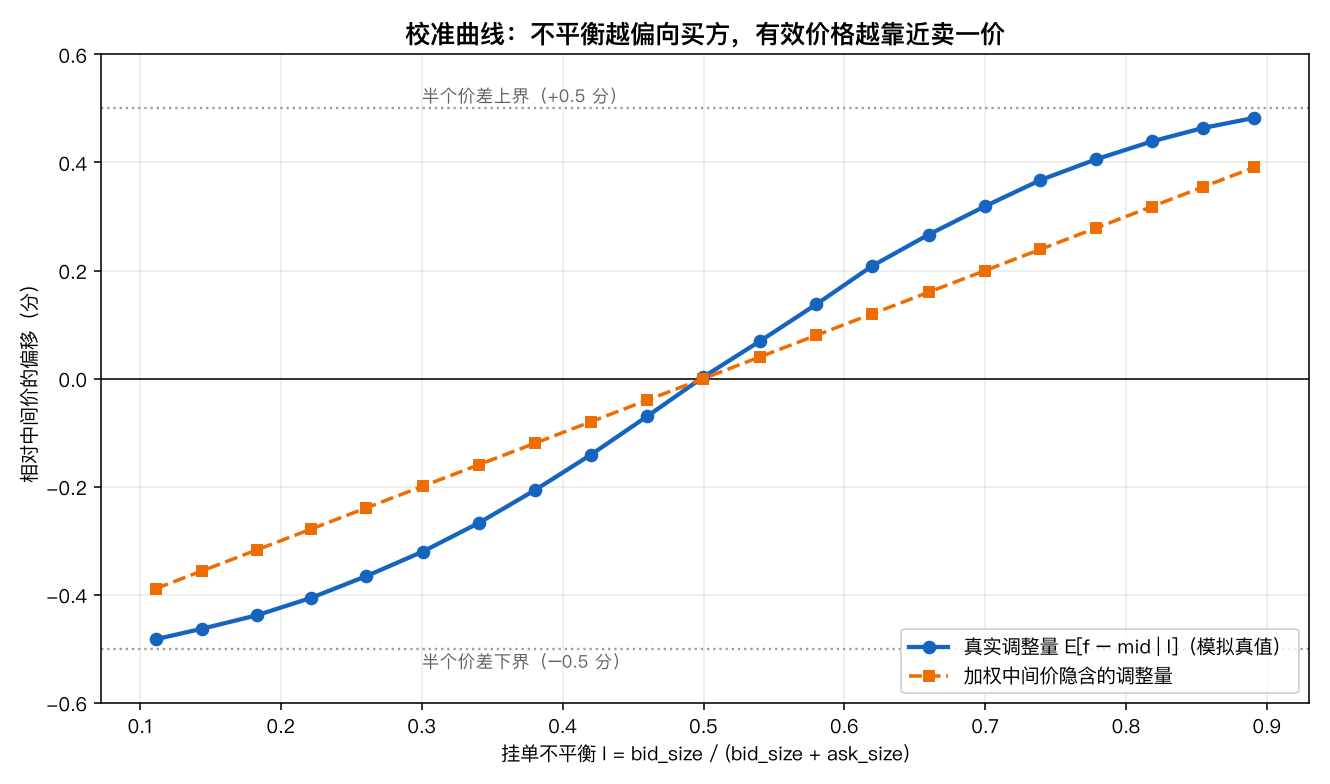
蓝线是真实调整量,橙色虚线是加权中间价隐含的调整量。两者方向一致(这证明加权公式的符号是对的),但蓝线更陡:真实校准斜率 0.0139,加权中间价只有 0.0100。也就是说,朴素加权在极端不平衡时修正不足——不平衡到 0.9 的时候,实际有效价格比加权中间价预测的还要更靠近卖一。
修法很自然:不假设任何函数形式,直接把这条经验曲线查表用(这是 Stoikov 微观价格思路的简化版)。关键是必须因果——用前半段样本估校准表,后半段样本应用:
def fit_adjustment(I_train, resid_train, nbins=40, min_count=20):
    """估计 E[f - mid | I] 的分箱查找表。
    样本不足的箱用相邻箱插值;若所有箱都不足,退化为全零(即等于中间价)。"""
    edges = np.linspace(0, 1, nbins + 1)
    idx = np.clip(np.digitize(I_train, edges) - 1, 0, nbins - 1)
    tbl = np.full(nbins, np.nan)
    for b in range(nbins):
        m = idx == b
        if m.sum() >= min_count:
            tbl[b] = resid_train[m].mean()
    ok = ~np.isnan(tbl)
    xs = 0.5 * (edges[:-1] + edges[1:])
    if ok.sum() == 0:
        return edges, np.zeros(nbins)          # 退化:等同中间价
    if ok.sum() == 1:
        return edges, np.full(nbins, tbl[ok][0])
    return edges, np.interp(xs, xs[ok], tbl[ok])

def apply_adjustment(I_test, edges, tbl):
    idx = np.clip(np.digitize(I_test, edges) - 1, 0, len(tbl) - 1)
    return tbl[idx]

# 因果用法:前半段估表,后半段应用
edges, tbl = fit_adjustment(I[:split], (f - mid)[:split])
micro_adjusted = mid[split:] + apply_adjustment(I[split:], edges, tbl)那句 if ok.sum() == 0: return np.zeros(nbins) 不是防御性废话——后面的过拟合检验会证明它是真的会被触发的分支。
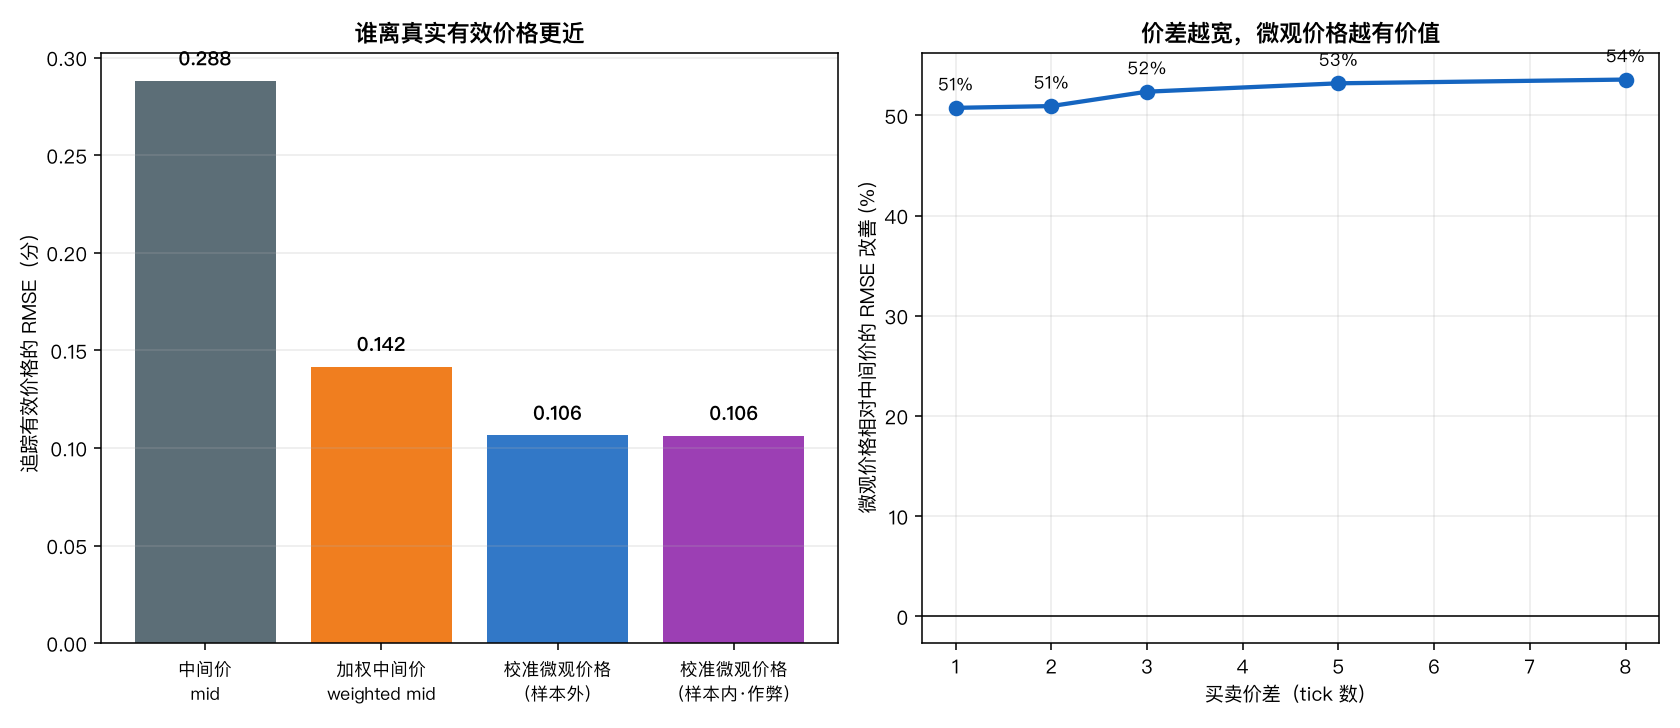
左图是四种估计的 RMSE。右图更有实践意义:价差越宽,微观价格越值钱。1 tick 价差时改善 50.7%,8 tick 时 53.6%。道理很直白——中间价的误差上界是半个价差,价差越宽,中间价可能错得越离谱,修正的空间也就越大。所以微观价格对流动性差、价差宽的品种更有用,而不是相反。
五项对抗式检验#
好看的数字必须先被怀疑。以下每一项都是「如果微观价格是假的,这里应该露馅」。
检验一:安慰剂盘口——抽掉信息机制#
把模拟里挂单量与有效价格位置的关联切断(info=False),挂单量变成纯噪声。如果微观价格的优势是真的来自信息,这里必须归零:
| 有信息盘口 | 安慰剂盘口 | |
|---|---|---|
| RMSE 改善 | +50.8% | −2.32% |
| 与下一步中间价变动相关 | 0.460 | 0.0069 |
改善由 +50.8% 变成 −2.32%(略微变差,因为加了纯噪声),相关系数从 0.460 塌到 0.0069。干净归零。微观价格没有魔法,它只是把盘口里本来就有的信息读出来;盘口里没有信息,它就什么都读不出来。
检验二:买卖方向标反#
前面说过交叉加权「第一眼觉得反了」。那就真的把它写反,看会怎样:
wmid_flip = (ask * ask_size + bid * bid_size) / (bid_size + ask_size) # 错误加权RMSE 改善变成 −58.15%——比中间价差了近六成。这个强烈的负号有两重意义:一是确认了正确方向确实是交叉加权,二是说明这个符号错误在真实项目里会造成灾难性后果,而且不会报错,只会安静地让你的估价系统性偏向错误一侧。任何接入新数据源时,第一件事就是用这个方法验证符号。
检验三:样本内 vs 样本外#
校准表是拟合出来的,会不会只是记住了噪声?
| 改善 | |
|---|---|
| 样本内(用测试段自己估表,作弊) | 63.08% |
| 样本外(前半段估表,后半段用) | 63.04% |
差异只有 0.04 个百分点。3 万个训练样本配 40 个分箱,平均每箱 750 个观测,过拟合空间基本为零。 这是个好消息,但它有个前提条件——样本量。
检验四:小样本下校准表会崩#
把训练样本量和分箱数做成网格,看样本外改善:
| 训练样本 | 10 箱 | 40 箱 | 200 箱 |
|---|---|---|---|
| 200 | 58.74% | 0.00% | 0.00% |
| 500 | 59.09% | 57.45% | 0.00% |
| 2,000 | 60.32% | 62.75% | 58.82% |
| 10,000 | 60.46% | 63.02% | 62.97% |
| 30,000 | 60.46% | 63.04% | 63.18% |
那些 0.00% 就是前面那个「退化分支」被触发了:分箱太细、每箱样本不够,校准表整个退化成中间价。这不是崩溃,是设计好的安全失败——宁可退回中间价,也不要用 3 个样本估出来的均值去做修正。
真正的教训在于:分箱数必须随样本量走。200 个样本用 10 箱还能拿到 58.74%,用 40 箱就直接失效。经验法则是每箱至少 100 个观测;盘口数据看着量大,但如果你按品种、按时段分别校准,单元格里的样本会迅速变稀。
检验五:预测跨度——85% 命中率是怎么回事#
微观价格相对中间价的偏移,能预测未来中间价往哪走吗?
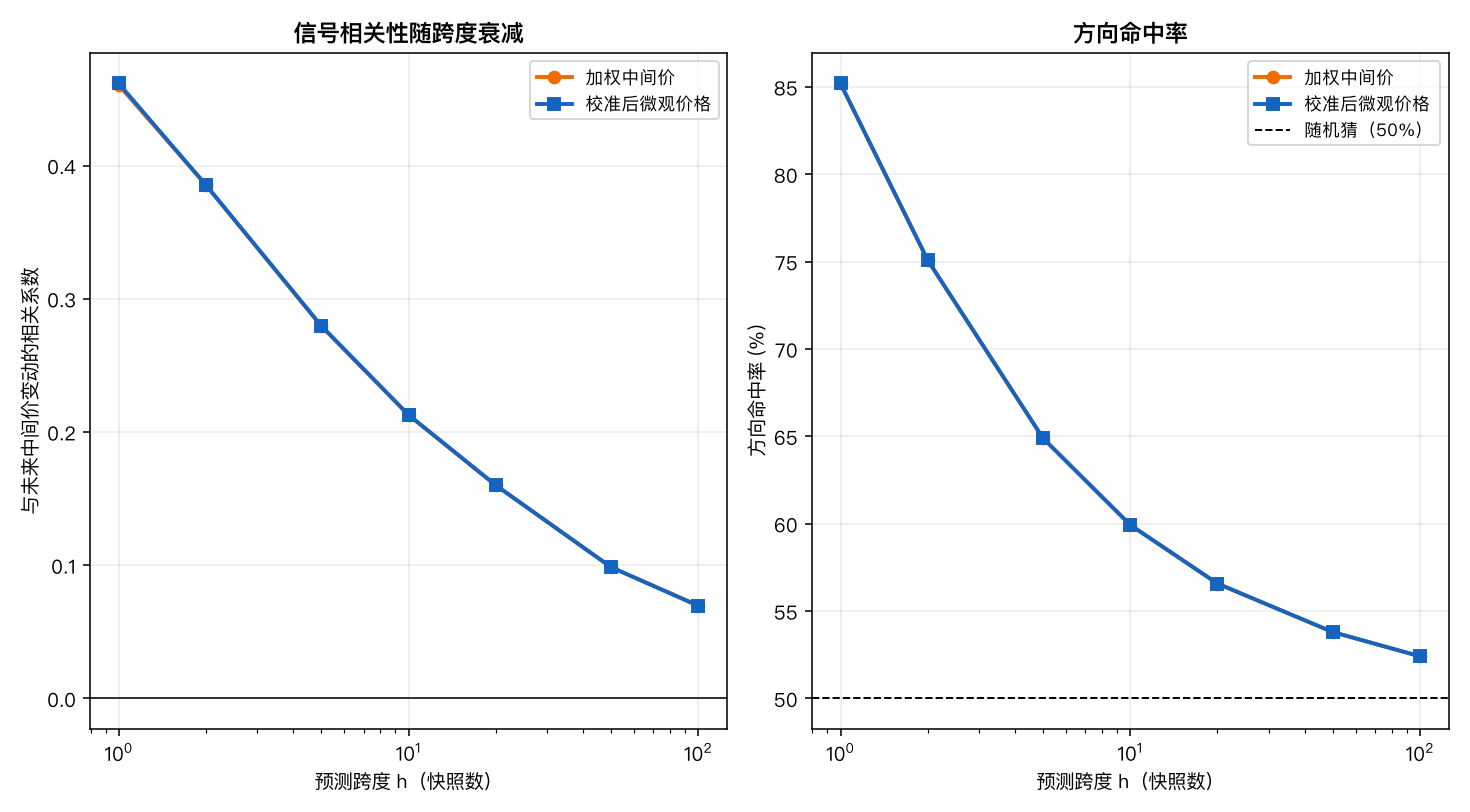
| 跨度 h(快照) | 相关系数 | 方向命中率 |
|---|---|---|
| 1 | 0.460 | 85.2% |
| 2 | 0.385 | 75.1% |
| 5 | 0.279 | 64.9% |
| 10 | 0.213 | 59.9% |
| 20 | 0.160 | 56.6% |
| 50 | 0.099 | 53.8% |
| 100 | 0.070 | 52.4% |
85.2% 的下一步命中率是本文最容易被误读的数字,必须说清楚:它预测的是「中间价在价差内部的下一次微小抖动」,不是「价格会不会走出一段能覆盖成本的行情」。信号半衰期极短——10 个快照后就只剩 59.9%,100 个快照后 52.4%,基本是抛硬币。
而且校准版和朴素加权版在方向预测上完全打平(h=1 时都是 85.2%)。原因是方向只取决于偏移的符号,而两者符号总是一致;校准只改变幅度。所以:要估价(做市报价、组合估值、成交质量分析)用校准版;只要方向,朴素加权就够了。
实践中它用来做什么#
做市报价的锚。 做市商围绕微观价格而非中间价报价,能减少被逆向选择的概率。盘口显示买方占优时,微观价格上移,你的报价跟着上移,避免卖一被人白吃。
成交质量评估。 评价一笔成交好坏,基准用微观价格比中间价公允。用中间价当基准,在盘口失衡时会系统性高估或低估滑点——这一点和实现价差分解的度量口径问题是同一类陷阱。
估值与风控。 持仓按中间价估值,在盘口极度失衡时会偏离可实现价格;对流动性差的品种尤其明显。这也是右图那条「价差越宽收益越大」曲线的实际含义。
下单时机的微调。 微观价格显著偏向卖一时,主动买单可能面临上跳,值得等一等;但记住上面那张衰减表——这个优势只在极短跨度内有效,别拿它当日内择时信号用。
诚实边界#
第一,模拟的信息机制是我设定的,不是从真实数据里发现的。 本文所有数字来自受控模拟,好处是「真实有效价格」已知、可以算真误差;代价是那个「有效价格越靠近卖一、卖一队列越薄」的机制是我写进去的。真实市场里这个关系的强度、稳定性、是否随品种和时段变化,都需要用实盘盘口数据重新校准。这些数字应该读作「机制成立时能拿到多少」,不是「你的品种上一定能拿到多少」。
第二,只用了买一卖一,忽略了盘口深度。 真实盘口有 5 档、10 档,深层挂单同样携带信息,而且第一档最容易被撤单和冰山单操纵。只看第一档的微观价格,在存在大量冰山单与隐藏流动性的市场里会被系统性欺骗——显示的 100 手背后可能是 5000 手。
第三,没有建模挂单的时间维度。 同样是 5000 手买盘,刚挂上去的和已经挂了十分钟的,信息含量完全不同;限价单排队位置那篇讨论的队列动态在这里被整个忽略了。真正的高频估价模型会用挂单年龄、撤单率、成交流不平衡等一整组特征,微观价格只是其中最简单的一个。
第四,命中率不等于可交易。 再强调一次:85.2% 的下一步方向命中率,对应的价格幅度是价差的一个零头。扣掉手续费和冲击成本后,这个「优势」在绝大多数情况下不足以支撑一个独立策略。它的价值在于改善你已经要做的事(报价、估值、择时微调),而不是成为一个新的事。
归宿#
微观价格是市场微观结构工具箱里性价比最高的那个:一行算术,追踪误差砍半,不需要估参数、不需要训练、不需要额外数据。如果你的系统现在还在用中间价做任何与价格相关的判断,换成加权中间价几乎是免费的升级。
想再进一步就上校准表,样本外还能再多拿 12 个百分点,但记住两条:每箱至少 100 个观测(否则安全退化成中间价),校准必须因果(用历史估表、用当下应用)。
最后是那条最重要的分界线:微观价格改善的是估价精度,不是预测能力。85% 那个数字很诱人,但它衰减得比你建仓的速度还快。把它当成一把更准的尺子,而不是一台印钞机。