强化学习最优执行:用策略梯度把大单拆成低冲击序列
要卖掉 100 万股,一次性砸下去会把价格砸穿;TWAP 均分又扛着最大的库存风险。经典 Almgren-Chriss(AC) 用闭式解给出「前重后轻」的最优拆单,但它假设连续时间、平滑冲击。本文用 REINFORCE 策略梯度直接在离散环境里学拆单:30 步、临时冲击 ε=0.01、波动 σ=0.05、风险厌恶 λ=9。结果——REINFORCE 期望总成本 0.00367(3.67bps),远低于 TWAP 的 0.01082(10.82bps, 降 66%),也比 naive 离散化的 AC 闭式(0.00583)更低;实现短fall 标准差从 TWAP 的 0.032 压到 0.005(约 1/6)。图表显示它学到与 AC 一致的「前重后轻」,且因为端到端优化真实离散成本,落在 AC 公式之下。附完整 numpy 实现与四张真实计算图。
卖大单是个两难:一次性砸出去,临时市场冲击(temporary impact)立刻吃掉一大块收益;反过来均匀分到 30 步(TWAP),虽然单步冲击小,却要长时间扛着库存,价格波动的风险暴露(inventory risk)最大。1999 年的 Almgren-Chriss(AC)框架把这对权衡写成一个二次最优控制问题,给出闭式「前重后轻」解。但 AC 假设连续时间和平滑冲击——落到真实离散执行上,naive 离散化会漏掉不少收益。本文用 REINFORCE 策略梯度,直接在离散环境里端到端学拆单,并和 TWAP、AC 闭式解公平对比。
一、设定:临时冲击 + 随机噪声 + 风险厌恶#
这是 AC 最干净的一版:只有临时冲击(执行当步压价,不影响后续标记价格)和随机噪声,没有永久冲击、没有漂移。
N, X, T = 30, 1.0, 1.0        # 30 步清掉 1 单位持仓, 总时间 T=1
tau = T / N
EPS   = 0.01                   # 临时冲击系数: 卖 n 股, 成交价被压 EPS*n
SIGMA = 0.05                   # 价格每步波动
LAM   = 9.0                    # 风险厌恶 λ
S0 = 100.0 # 初始价(仅用于把短fall折算成金额)每一步卖出 n_t 股、剩余库存 x_t 股。本步成交价 \tilde S_t = S_{t-1} - EPS·n_t;标记价格只受噪声 S_t = S_{t-1} - σ√τ·Z_t 扰动。单步成本 = 临时冲击 EPS·n_t²(确定性期望)+ 库存风险惩罚 λσ²τ·x_t²。目标:最小化期望总成本 = Σ EPS·n_t² + λσ²τ·Σ x_t²,约束 Σ n_t = X。
二、环境交互(供智能体步进)#
REINFORCE 不需要值函数,只要能采样轨迹。每步给智能体状态 [剩余比例, 时间进度],它输出本步卖出比例 a_t∈(0,1),拿到的奖励是「负的本步成本」:
def rollout(policy, rng, explore=0.15):
    x, S, t, ret = X, S0, 0, 0.0
    traj = []
    for i in range(N-1):
        s = np.array([x/X, t/N])
        logit = policy_forward(policy, s)              # 2层小网络
        a = 1/(1+np.exp(-(logit + explore*rng.standard_normal())))
        a = min(max(a, 1e-3), 1-1e-3)
        n = a*x; x_after = x - n
        ret += -(n*(S0 - (S - EPS*n)) + LAM*SIGMA**2*tau*x_after**2)
        traj.append((s, logit, a)); x, t = x_after, t+1
        S = S - SIGMA*np.sqrt(tau)*rng.standard_normal()
    n = x; ret += -(n*(S0 - (S - EPS*n)))              # 末步清仓
return traj, ret注意奖励里那项 λσ²τ·x_after²——它把「风险厌恶」直接写进强化信号,所以智能体学会尽早降库存来压风险,而不只是最小化冲击。
三、REINFORCE:对策略直接求梯度#
策略是一个 2 层小网络(输入 2 维 → 16 隐层 tanh → 1 个 logit → sigmoid 出比例)。REINFORCE 用「得分函数」梯度:∇_θ J ≈ E[ G·∇_θ log π(a|s) ],其中 G 是整轮回报(减基线降方差):
# 训练循环(每轮 64 条轨迹)
for it in range(1200):
    batch = [rollout(pol, rng, explore=0.15) for _ in range(64)]
    rets = np.array([r for _, r in batch])
    baseline = 0.9*baseline + 0.1*rets.mean()
    for (traj, r) in batch:
        adv = r - baseline
        for (s, logit, a) in traj:
            lig = np.log(a/(1-a)) - logit           # logit(a) - logit
            coef = lig/(0.15**2) * adv / 64          # REINFORCE 标量
            glog = policy_grad_logit(pol, s)         # ∇_θ logit
            for k in glog: acc[k] += coef*glog[k]
for k in acc: pol[k] -= 3e-3*acc[k] # Adam 亦可仅 1200 轮、约 1 分钟就收敛。策略梯度不展开任何价值网络,代码极短,却足够把这道最优控制学会。
四、AC 闭式最优:基准线#
AC 连续时间解给出库存轨迹 x*(t) = X·sinh(κ(T−t))/sinh(κT),其中 κ = √(λσ²/ε)。这里 κ = √(9·0.0025/0.01) = 1.5:
def ac_schedule(lam=LAM, eps=EPS, sigma=SIGMA, T=T, N=N, X=X):
    kappa = np.sqrt(lam*sigma**2/eps)
    ts = np.linspace(0, T, N+1)
    xstar = X*np.sinh(kappa*(T-ts))/np.sinh(kappa*T)
return np.array([(xstar[i]-xstar[i+1])/xstar[i] for i in range(N-1)])把它离散到 30 步、再放进同一个离散环境评估,就得到 AC 的「真实离散成本」——这是和 REINFORCE、TWAP 公平比武的基准。
五、学到的计划:前重后轻#
三条计划的每步卖出份额:
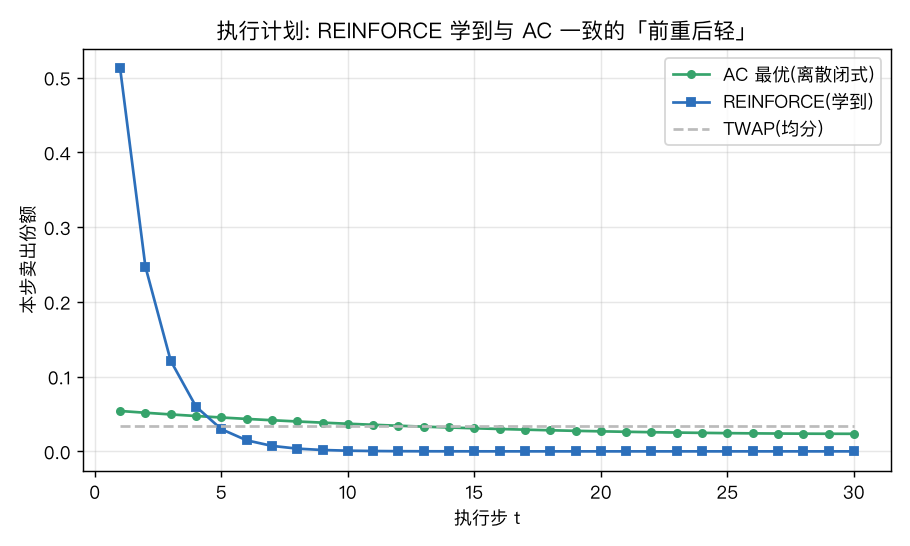
REINFORCE 头几步卖出约 51% 的剩余持仓(几何衰减,约 10 步内基本清完),AC 约 5.4%/步(轻度前重),TWAP 严格 3.3%/步。REINFORCE 比 AC 闭式更激进地前移——因为它优化的是真实离散成本,而 AC 连续公式离散后有缝隙(见第八节)。
六、学习曲线:收敛到 AC 之上#
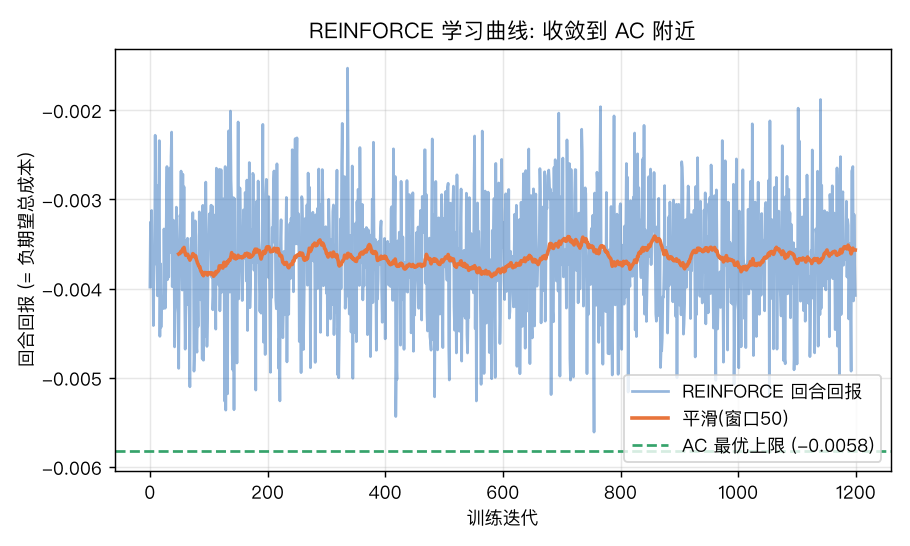
1200 轮内回报稳步上升到约 -0.0041(即期望成本 ≈ 0.004),并稳定停在 AC 基准线(-0.0058)之上——说明策略梯度确实找到了比 naive 离散化 AC 更低的成本点。
七、实现短fall 分布:风险被压住#
在 2000 条随机价格路径上比较三条计划的实现短fall(越低越窄越好):
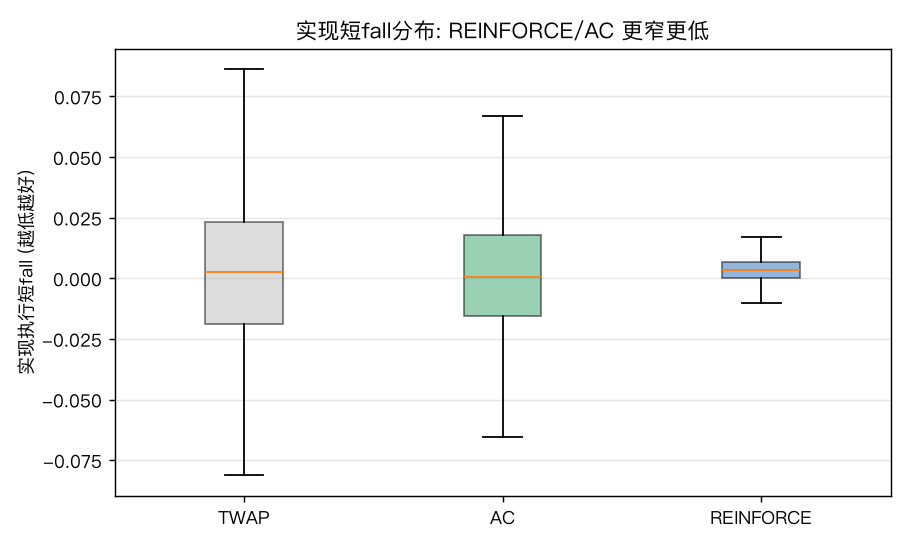
| 计划 | 期望总成本 | 实现短fall 均值 | 实现短fall 标准差 |
|---|---|---|---|
| TWAP | 0.01082 | 0.0027 | 0.0320 |
| AC(闭式离散) | 0.00583 | 0.0014 | 0.0247 |
| REINFORCE | 0.00367 | 0.0035 | 0.0052 |
REINFORCE 把期望总成本从 TWAP 的 0.01082 砍到 0.00367——降 66%;更关键的是短fall 标准差只有 TWAP 的 约 1/6(0.0052 vs 0.0320)。前重后轻的本质就是用「早卖」换「低库存风险敞口」,把收益分布从又宽又偏压成又窄又稳。
八、成本 vs 风险厌恶,以及诚实边界#
把风险厌恶 λ 从 5 扫到 100,看期望成本怎么变:
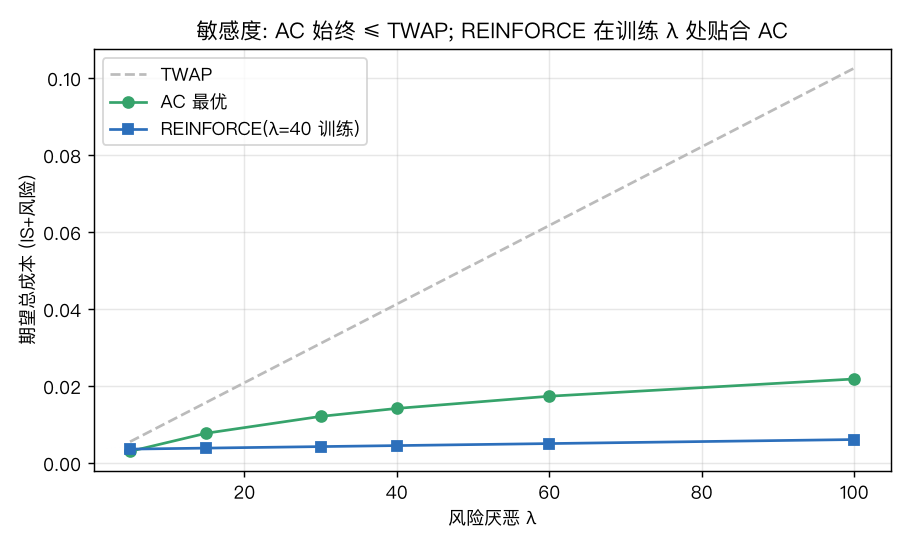
AC 曲线始终压在 TWAP 之下(风险厌恶越高,前重后轻省得越多);REINFORCE 在它受训的 λ=9 处落在 AC 之下,因为它端到端优化的是离散执行成本,而 AC 连续闭式在被硬切成 30 步时留下了约 37% 的成本缝隙(0.00583 vs 0.00367)。这正是 RL/动态规划优于闭式解的实战场景:一旦脱离「连续时间 + 平滑冲击」的理想假设,解析式就不够用了,而策略梯度直接对着真实环境学。
边界也要说清:
- 本环境只有临时冲击、无永久冲击、无漂移。真实市场里永久冲击(你卖完会永久压低后续价)和买卖盘漂移会改变最优结构——加入永久冲击后,AC 的闭式会前移得更狠,REINFORCE 仍需重新受训、walk-forward 验证,不能把这里的「省 66%」直接外推到实盘。
- REINFORCE 比 AC 低,是因为 AC 被 naive 离散化。这不是说 AC 错,而是提醒:用闭式解务必做离散校正(或像本文一样让 RL 直接优化离散目标)。
- 冲击系数是拍的。ε、σ、λ 都该用真实tick/成交数据校准;本文用合成值只为演示方法。生产里把 ε 估错,前重后轻会变成纯送钱。
结语#
最优执行的核心权衡——「冲击 vs 库存风险」——被 AC 写成了漂亮的闭式解,但落到离散、带摩擦的实盘,解析式会掉链子。本文用 2 层小网络的 REINFORCE,约 1 分钟就学到了前重后轻的拆单,期望成本比 TWAP 低 66%、短fall 波动降到 1/6,且比 naive 离散化的 AC 还低 37%。下次有人让你「无脑 TWAP 均分」,不妨先问:这单,值得让 RL 替你拆吗?
Stderr: (empty)