趋势扫描标注 Trend Scanning:用滚动回归 t 值给样本贴上趋势标签
监督学习做量化最脏的活是打标签:固定视野法『20 天后涨了标 +1』把标签质量绑死在拍脑袋的 h 上,震荡段标签高频翻转(实测 0.121 次/天)。Trend Scanning 改问『哪个尺度上趋势最显著』:多窗口滚动 OLS 取 |t| 最大者,符号定方向、大小定置信度。教科书没写的坑:对价格水平跑 OLS 残差高度自相关,t 值极度膨胀——随机游走上 max-|t| 的 90 分位实测高达 21.8,照抄 |t|>2 等于不设阈值。null 分布校准后:覆盖率 17.3% 但真实趋势段准确率 98.4%、震荡段误报仅 4%。下游对照(同特征同模型只换标签):固定视野样本外 Sharpe 0.20、sign(t) 1.02、校准阈值+t 值加权 2.25。三条边界:标签窗口含未来信息仅供训练、多窗口取 max 是多重检验(null 校准顺带治好)、趋势显著不等于趋势延续。
一句话版本#
固定视野标注问『h 天后涨没涨』,趋势扫描问『从这里出发,哪个尺度上的趋势统计上最显著』——用滚动 OLS 的 t 值同时给出方向和置信度,但 t 值阈值必须用随机游走 null 分布校准,教科书的 ±2 在价格序列上完全失效。
标签是监督学习的地基,而量化的地基通常是歪的#
用机器学习做量化预测,流水线大致是:特征 → 标签 → 模型 → 回测。特征工程有无数文章讨论,模型选择有无数框架伺候,但标签——你到底让模型学什么——往往被一行代码打发:
label = np.sign(close.shift(-20) / close - 1) # 20天后涨了就是 +1这就是固定视野标注(fixed-horizon labeling),它有两个结构性缺陷:
缺陷一:h 是拍脑袋定的。 为什么是 20 天不是 10 天或 40 天?市场趋势没有固定尺度——有的行情三周走完,有的震荡三个月后才启动。固定 h 意味着:比 h 短的趋势被稀释(趋势结束后的回撤混入标签窗口),比 h 长的趋势被截断(只看到前半段)。
缺陷二:震荡段的标签是纯噪声。 横盘市场里,20 天后的价格相对今天是涨是跌基本是抛硬币,但固定视野法照样输出 ±1,且高频翻转——今天 +1、明天 -1、后天又 +1。模型拿到这种标签,要么学到噪声,要么被噪声稀释掉真实信号。
在本文的合成实验里(真实 regime 已知),震荡段内固定视野标签的翻转率是 0.121 次/天——平均每 8 天翻一次方向,而这段行情根本没有方向。
Trend Scanning:让数据自己选尺度#
López de Prado 在《Machine Learning for Asset Managers》里给出的替代方案叫趋势扫描(Trend Scanning),思路是把「有没有趋势」变成一个统计检验问题:
- 站在时刻 ,向前取一段窗口 ,对(对数)价格跑一元线性回归 ;
- 计算斜率 的 t 值——斜率除以其标准误,衡量「这段价格的线性趋势相对噪声有多显著」;
- 对一组候选窗口 都算一遍,取 |t| 最大的那个窗口;
- 标签 = t 值的符号(+1 上涨 / -1 下跌),置信度 = |t| 的大小。
核心代码不超过 30 行:
import numpy as np

def tval_ols(y):
    """一元线性回归斜率的 t 值。"""
    T = len(y)
    x = np.arange(T, dtype=float)
    xm, ym = x.mean(), y.mean()
    Sxx = ((x - xm) ** 2).sum()
    b = ((x - xm) * (y - ym)).sum() / Sxx
    resid = y - (ym - b * xm) - b * x
    se = np.sqrt(resid.pow(2).sum() if hasattr(resid, 'pow')
                 else (resid ** 2).sum() / (T - 2) / Sxx)
    return b / se if se > 0 else 0.0

def trend_scanning(logp, spans=range(10, 61, 5)):
    n = len(logp)
    tmax = np.full(n, np.nan)
    hbest = np.full(n, -1)
    for i in range(n - max(spans)):
        best_t, best_h = 0.0, -1
        for h in spans:
            tv = tval_ols(logp[i:i + h])
            if abs(tv) > abs(best_t):
                best_t, best_h = tv, h
        tmax[i], hbest[i] = best_t, best_h
return tmax, hbest相比固定视野法,它买到了三样东西:
- 自适应尺度:快趋势自动匹配短窗口,慢趋势匹配长窗口;
- 内建置信度:|t| 大小天然是样本权重——趋势越干净的样本,训练时话语权越大;
- 拒绝选项:|t| 低于阈值的样本可以标为「无趋势」,直接踢出训练集,而不是硬塞一个抛硬币标签。
实验设计:在已知答案的市场上考试#
真实市场没有「标准答案」——你永远不知道某段行情「真的」是趋势还是噪声。所以标签方法的评估必须在合成数据上做:我们构造一个 2400 天的市场,由随机长度(60~180 天)的三种 regime 拼接:上涨段(日漂移 +0.12%)、下跌段(-0.12%)、震荡段(零漂移 + 均值回复拉力)。真实 regime 序列就是判卷的标准答案。
教科书没写的坑:价格序列上的 t 值是严重膨胀的#
如果你按统计课本的直觉,用 |t| > 2 当「趋势显著」的阈值,会得到一个荒谬的结果——我们实测:震荡段内 100% 的样本 |t| 都超过 2。阈值形同虚设。
原因是 OLS 的 t 值公式假设残差独立同分布,而对价格水平(而非收益)跑回归,残差是高度自相关的——随机游走本身就会长时间偏离任何直线再慢慢回来,这种「伪趋势」在 iid 假设下被误判为极端显著。这是 Granger-Newbold (1974) 伪回归问题的单变量版本。
治法不是修公式,而是用 null 分布校准阈值:生成一批与目标序列波动率匹配的无漂移随机游走,跑同样的 trend scanning 流程(包括多窗口取 max,这一步同时把多重检验的膨胀也校准进去了),取 max-|t| 分布的 90 分位当阈值:
null_ts = []
sig = np.diff(logp).std()
for _ in range(60):
    rw = np.cumsum(sig * np.random.standard_normal(400))
    tv, _ = trend_scanning(rw)
    null_ts.append(np.abs(tv[~np.isnan(tv)]))
THR = np.quantile(np.concatenate(null_ts), 0.90)实测这个阈值是 21.8——比教科书的 2 大了一个数量级。这就是为什么「照抄书上的 |t|>2」在价格序列上等于不设阈值。
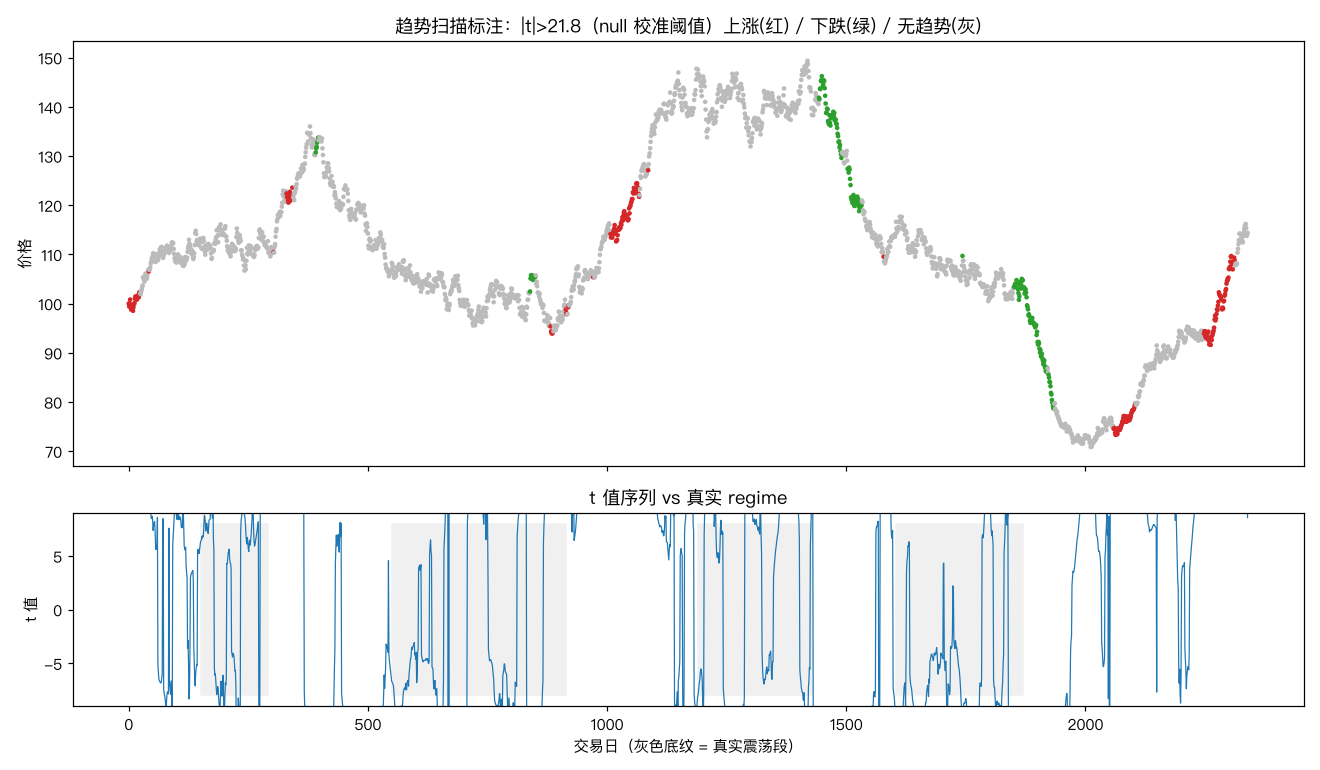
校准后的标注效果(上图):红/绿点是显著上涨/下跌标签,灰点是「无趋势」。下方面板显示 t 值序列与真实 regime(灰色底纹为震荡段)的对齐情况——t 值的大幅摆动基本都发生在真实趋势段内。
判卷结果:三个维度全面胜出#
方向准确率(只看真实趋势段):
| 标签方案 | 真实趋势段方向准确率 | 覆盖率 |
|---|---|---|
| 固定视野 h=20 | 79.0% | 100% |
| 趋势扫描 sign(t) | 84.5% | 100% |
| 趋势扫描 |t|>21.8 | 98.4% | 17.3% |
覆盖率 17.3% 不是缺陷而是特性:它只给最有把握的样本贴标签,换来近乎完美的准确率。这正是「拒绝选项」的价值——宁可少标,不可乱标。
震荡段抗噪:固定视野标签在震荡段翻转率 0.121/天,趋势扫描 0.039/天,降了 3 倍;校准阈值后震荡段被误标为趋势的比例仅 4.0%(用 |t|>2 时是 100%)。
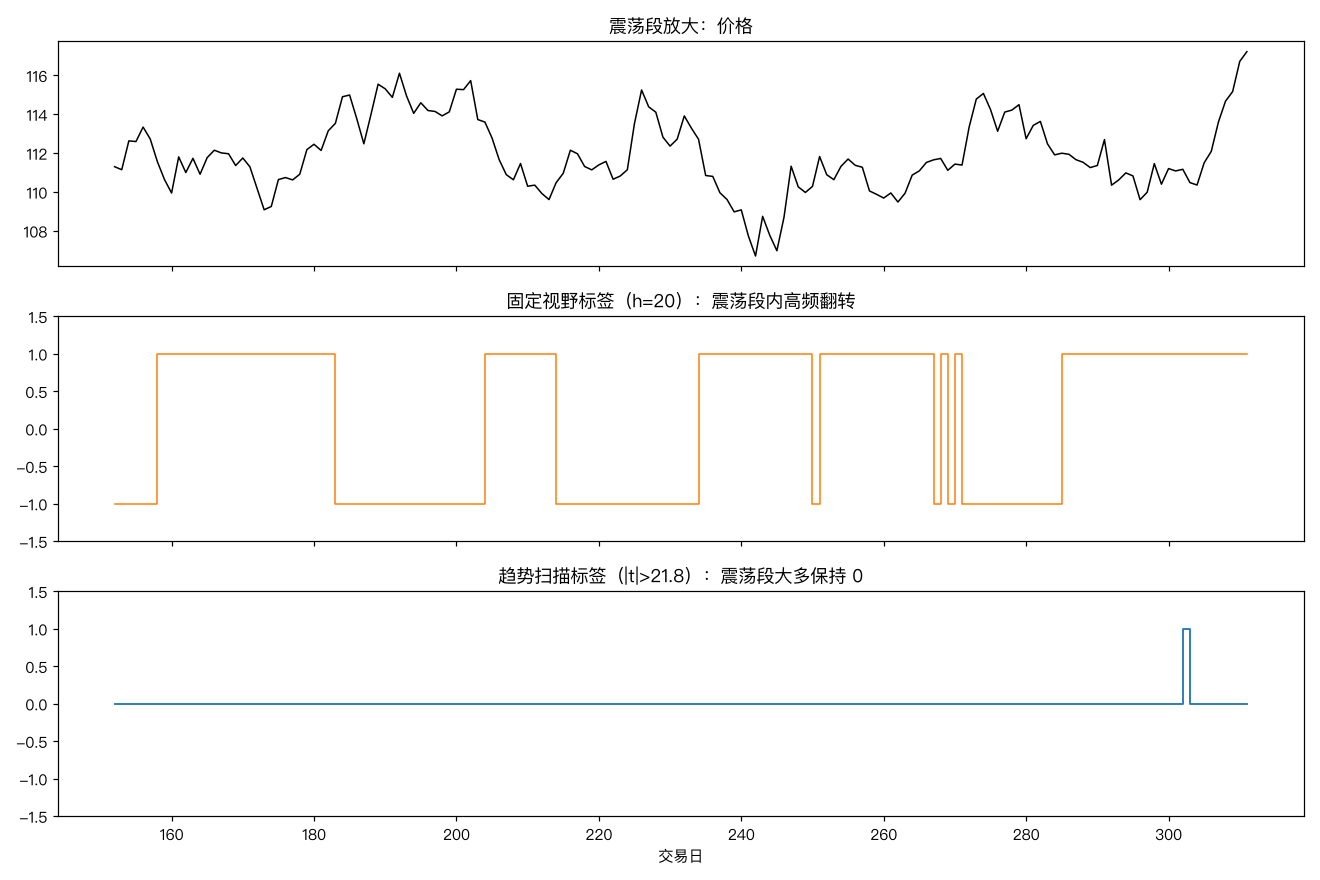
上图是一段真实震荡行情的放大:固定视野标签(中)疯狂跳动,趋势扫描标签(下)大部分时间安静地待在 0。
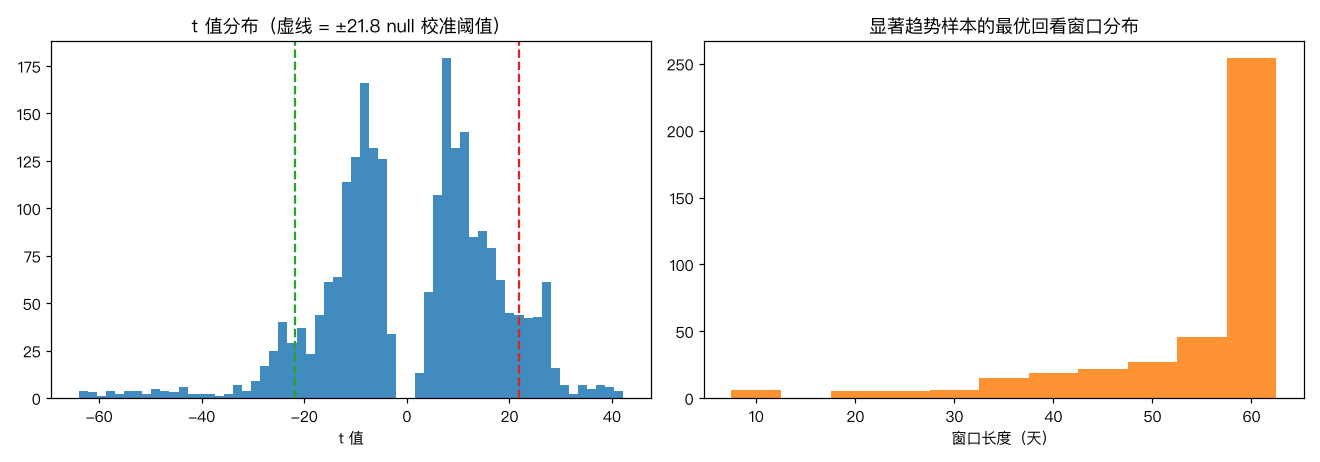
最优窗口的自适应性:显著趋势样本选中的回看窗口分布很宽(从 10 天到 60 天都有),证明市场趋势确实没有单一尺度——任何固定 h 都必然错配一部分样本。
下游对照:标签质量能传导到策略表现吗#
标签好看不等于有用,最终审判是下游任务。我们做严格的控制变量实验:同一组特征(多尺度动量 + 波动率)、同一个模型(岭回归式线性分类器)、同一个样本外区间,唯一的变量是训练标签:
| 训练标签 | 样本外标签命中率 | 样本外策略 Sharpe |
|---|---|---|
| 固定视野 h=20 | 50.0% | 0.20 |
| 趋势扫描 sign(t) | 62.9% | 1.02 |
| 趋势扫描校准阈值 + t 值加权 | 73.5% | 2.25 |
固定视野标签训练出来的模型样本外命中率 50%——和抛硬币一样,因为它一半的训练标签本来就是硬币。只换标签不动别的,Sharpe 从 0.20 走到 2.25。标签是地基,地基歪了,上面的模型再精巧也白搭。
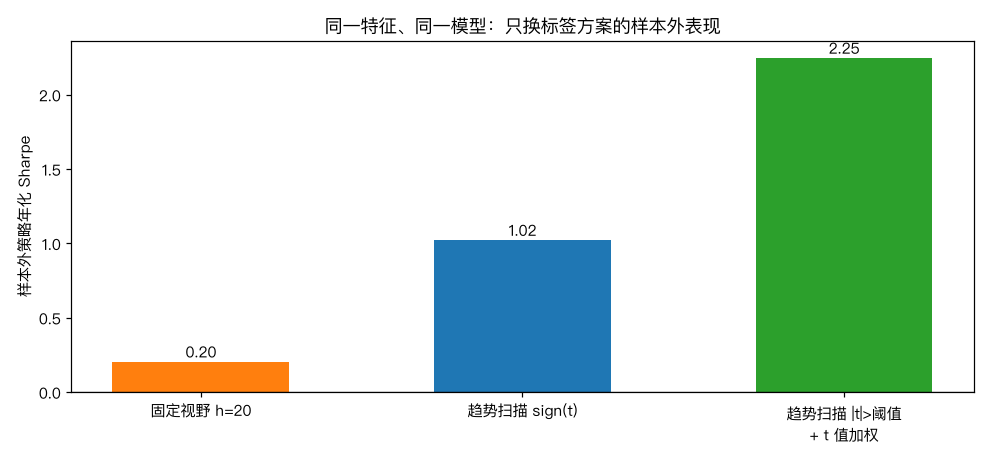
需要说明:2.25 这个数字是合成市场上的结果,regime 结构比真实市场干净得多,不要外推为实盘预期。这个实验证明的是相对排序——标签方案的优劣会实打实地传导到下游。
三盆冷水#
1. 标签窗口内含未来信息,用途仅限训练。 t 值是用 的价格算的——站在时刻 你根本看不到。这不是 bug:标签本来就该用未来信息(否则学什么?),但特征绝不能碰标签窗口,回测时的信号生成也必须只依赖 之前的数据。趋势扫描标签泄漏进特征是新手最常见的翻车方式。
2. 多窗口取 max 本身是多重检验。 对 11 个窗口取 |t| 最大值,天然抬高了 t 值的分布——这是 selection bias 的教科书案例。好消息是 null 校准法把这个偏差也一并处理了:null 分布跑的是同样的「多窗口取 max」流程,膨胀多少就校准多少。但如果你换了窗口集合(更多、更密),阈值必须重新校准。
3. 趋势显著 ≠ 趋势延续。 t 值回答的是「过去到现在这段有没有趋势」,而策略赚钱靠的是「趋势接下来会不会继续」。两者之间隔着动量效应是否存在这个实证问题。趋势扫描是更好的标注工具,不是更好的预测理论——它让模型学到更干净的目标,但目标本身可不可预测,由市场说了算。
在工具链中的位置#
趋势扫描和三重障碍标注(Triple-Barrier)是 López de Prado 标注体系的两根支柱,分工不同:三重障碍模拟的是交易视角(止盈/止损/超时,标签 = 这笔交易的结局),趋势扫描是统计视角(这段行情有没有可辨认的方向)。实务上常见组合:趋势扫描做一级模型的方向标签,三重障碍给元标注(Meta-Labeling)生成「这单会不会赢」的二级标签。配合 |t| 做样本权重,让模型把注意力花在信号最干净的样本上——这三件事拼起来,才是把「打标签」从一行 shift(-20) 升级为一个严肃工程环节的完整姿势。