方差风险溢价收割:卖波动为什么长期赚钱又偶尔归零
「隐含波动长期高于已实现波动,所以卖波动是正期望」——这句话是对的,但它推不出「卖波动能赚钱」。决定性对照是把 VRP 精确设为 0:中位 CAGR 依然是 +1.35%、57.7% 的月份仍在赚钱、63.2% 的单月胜率一分不少。换句话说,你在实盘和业绩报告里看到的绝大部分「卖波动的钱」,在一个溢价精确为零的世界里照样会出现——它来自 E[RV]/median[RV]=1.2172 这个纯分布事实,不是溢价。30 年 × 2 万条路径受控模拟:中位 CAGR +14.46% 而均值 CAGR −12.69%,24.10% 的路径归零;月度偏度 −12.89、峰度 244.96,最差单月精确 −100%。均值口径盈亏平衡 VRP=31.39% 而基准只有 15%(安全边际 −52.2%)。跳跃强度过零点 0.2100 次/年而基准 0.48——站在生死线正确的一侧,但这恰恰是最不可估计的参数。五种仓位口径 Sharpe 极差 0.584,归零概率却差 96.4 倍;赔付封顶把归零从 24.10% 压到 0.25%。前 5 年赚钱的路径有 21.20% 到 30 年翻负、20.69% 直接归零。剔除最差 1% 的月份后 Sharpe 从 0.869 跳到 2.419。12 宇宙 CV=0.0068
核心结论:「隐含波动长期高于已实现波动」是真的,但它不是卖波动赚钱的原因。 把方差风险溢价(VRP)精确设为 0 —— 也就是让保险公平定价、卖方在期望上一分钱不赚 —— 这个策略的中位路径依然是赚钱的:30 年中位 CAGR +1.35%,57.7% 的路径最终为正,单月胜率 63.2%。
而基准情景(VRP=15%)的中位 CAGR 是 +14.46%。两者的差距当然存在,但关键在于:在一个溢价精确为零的世界里,你依然会看到一条向上的净值曲线、一个大于 50% 的胜率、以及一份看起来很像 alpha 的业绩报告。
这意味着一件很不舒服的事:「我卖波动赚到钱了」这个观察,几乎不构成「存在方差风险溢价」的证据。
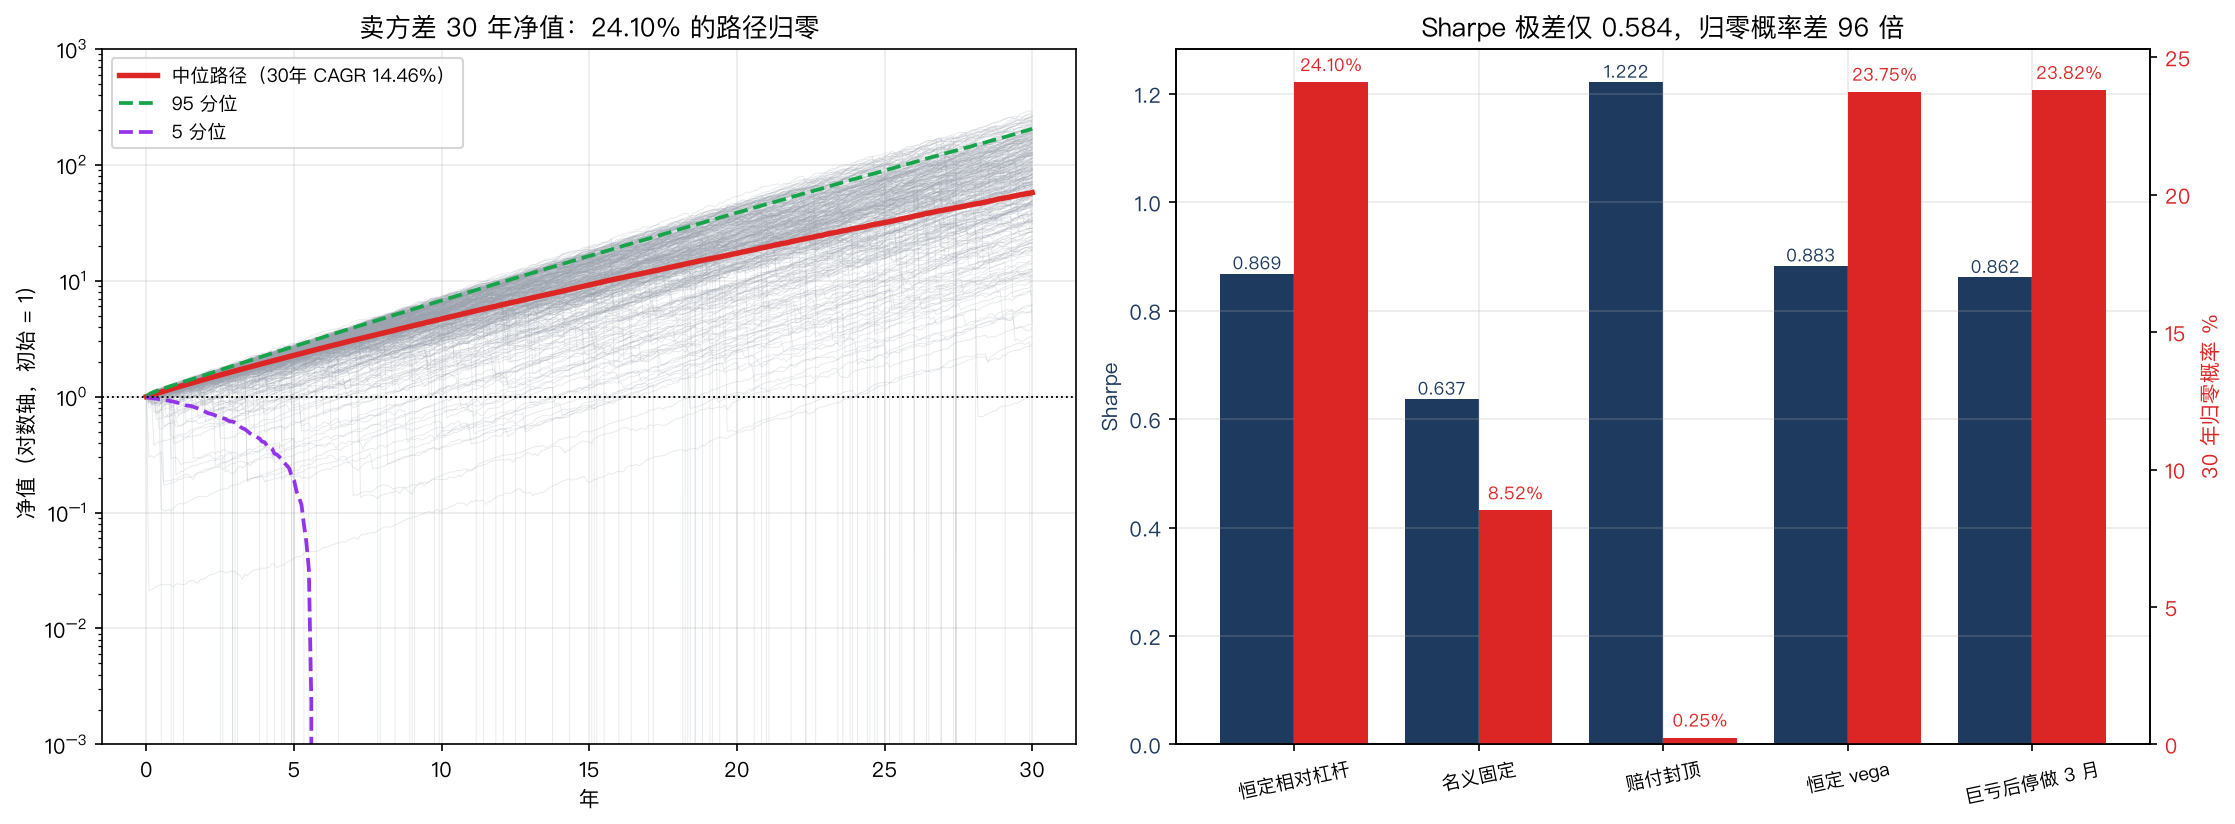
而同一个引擎里,均值口径的 CAGR 是 −12.69%。中位 +14.46%、均值 −12.69% —— 这不是矛盾,这是这门生意的全部内容。
一、先把这门生意的结构说清楚#
方差风险溢价收割,实务上有很多张皮:卖跨式、卖宽跨式、做空 VIX 期货、卖方差互换、备兑开仓、雪球产品的对冲端。剥掉包装,结构都是同一个:
期初收一笔固定的钱(执行方差 K),期末赔出一个随机的数(已实现方差 RV),赚 K − RV。
本文用最干净的形式来建模——月度方差互换,避免 delta 对冲误差、gamma 路径依赖这些与主题无关的噪音污染归因。
本文的基准设定(全部是真值,由构造给定,不是估计出来的):
| 参数 | 值 | 说明 |
|---|---|---|
| 无条件期望已实现方差 | 0.0324 | 对应 18% 年化波动 |
| 对数方差 AR(1) 系数 φ | 0.75 | 月度波动聚集 |
| 对数方差无条件标准差 | 0.45 | 波动的波动 |
| 跳跃强度 λ | 0.04 次/月(0.48 次/年) | 波动率突然跳升 |
| 跳跃幅度 | ~Exp(1.4),均值乘数 3.5 | 对数方差的向上跳 |
| 方差风险溢价 VRP | 15% | K = 公允方差 × 1.15 |
| 方差名义 / 资本 | 25x | 行业常见量级 |
| 模拟规模 | 30 年 × 20000 条路径 | 月度频率 |
引擎自洽性先过一遍。执行价与已实现方差的期望差,应精确等于 VRP × E[RV]:
- 实测 E[K − RV] = 0.00484243
- 解析 0.15 × 0.0324 = 0.00486
- 相对误差 3.61e-03
E[RV] 实测 0.03242992 对构造值 0.0324,误差 2.99e-05。引擎没有加性偏差。
二、决定性对照:把溢价精确设为零#
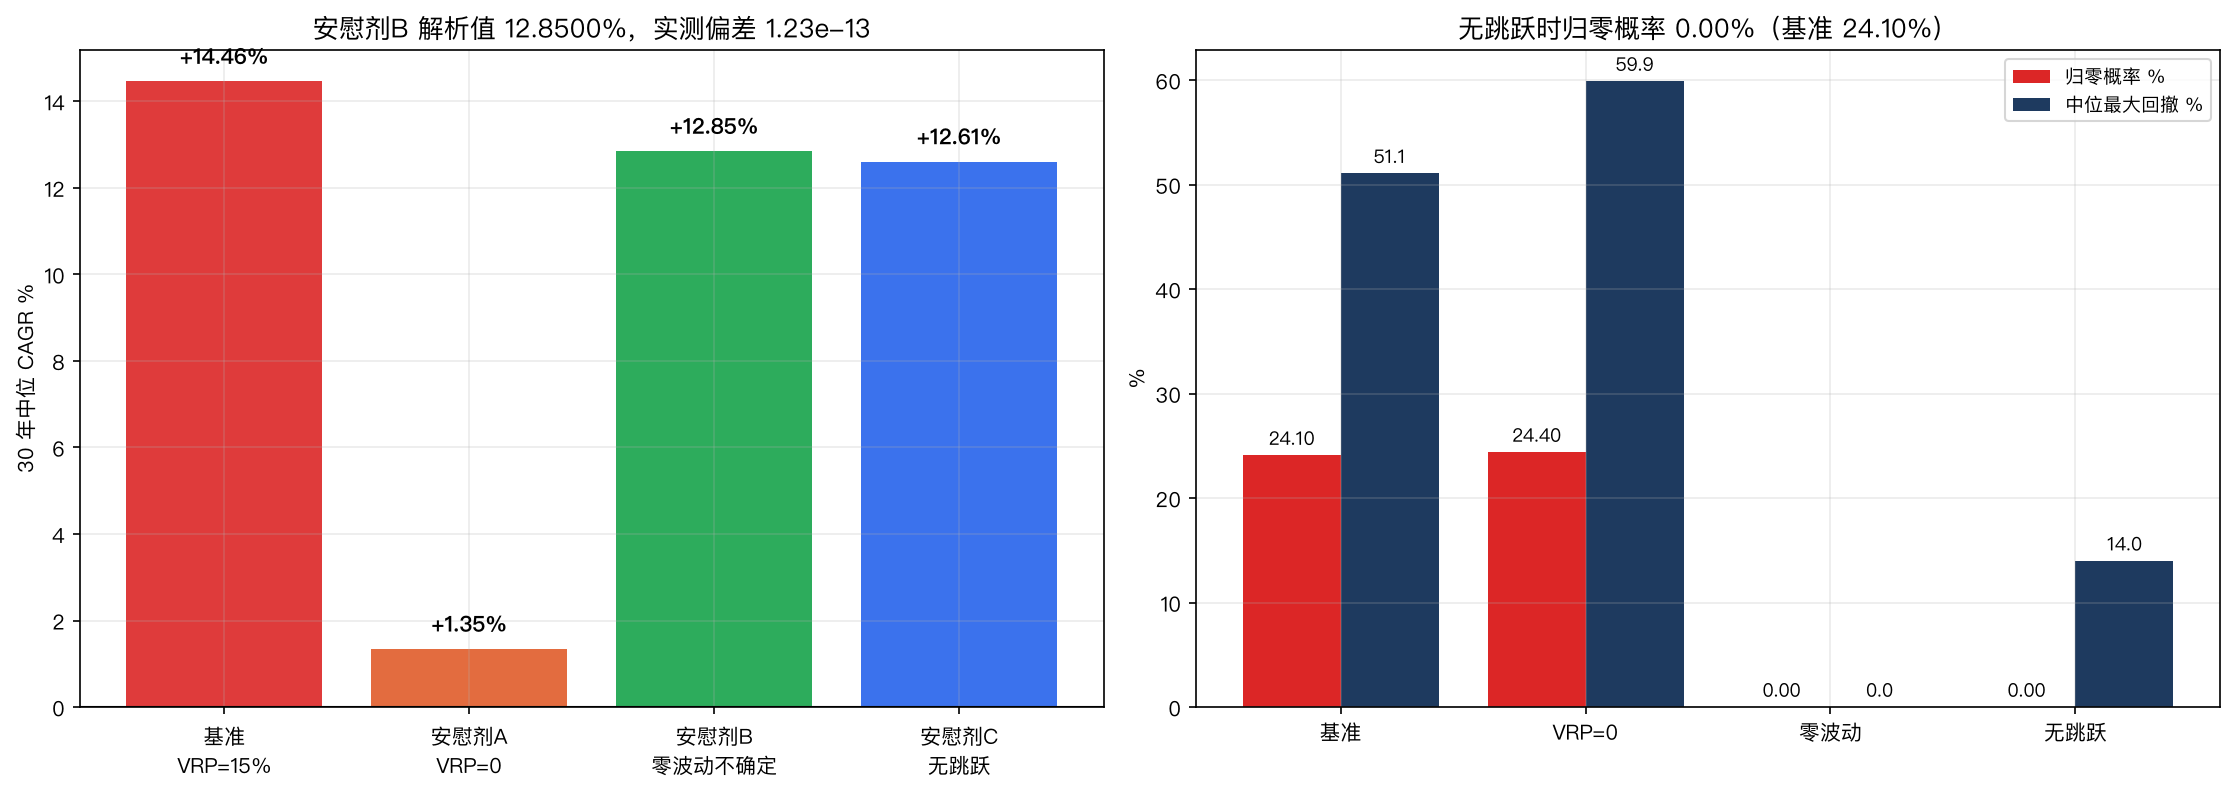
这是全文最重要的一张表。安慰剂 A:VRP = 0,保险公平定价,卖方的期望利润精确为零(实测 E[K−RV] = −1.92e-05,就是蒙特卡洛噪音)。
| 指标 | 基准 VRP=15% | 安慰剂 VRP=0 |
|---|---|---|
| 30 年中位 CAGR | +14.46% | +1.35% |
| 最终为正的路径占比 | 75.25% | 58.24% |
| 单月胜率 | 76.98% | 63.17% |
| 30 年归零概率 | 24.10% | 24.40% |
| 均值 CAGR | −12.69% | −22.90% |
看右边这一列。期望利润精确为零,但中位数是正的、多数路径赚钱、六成以上的月份收正收益。
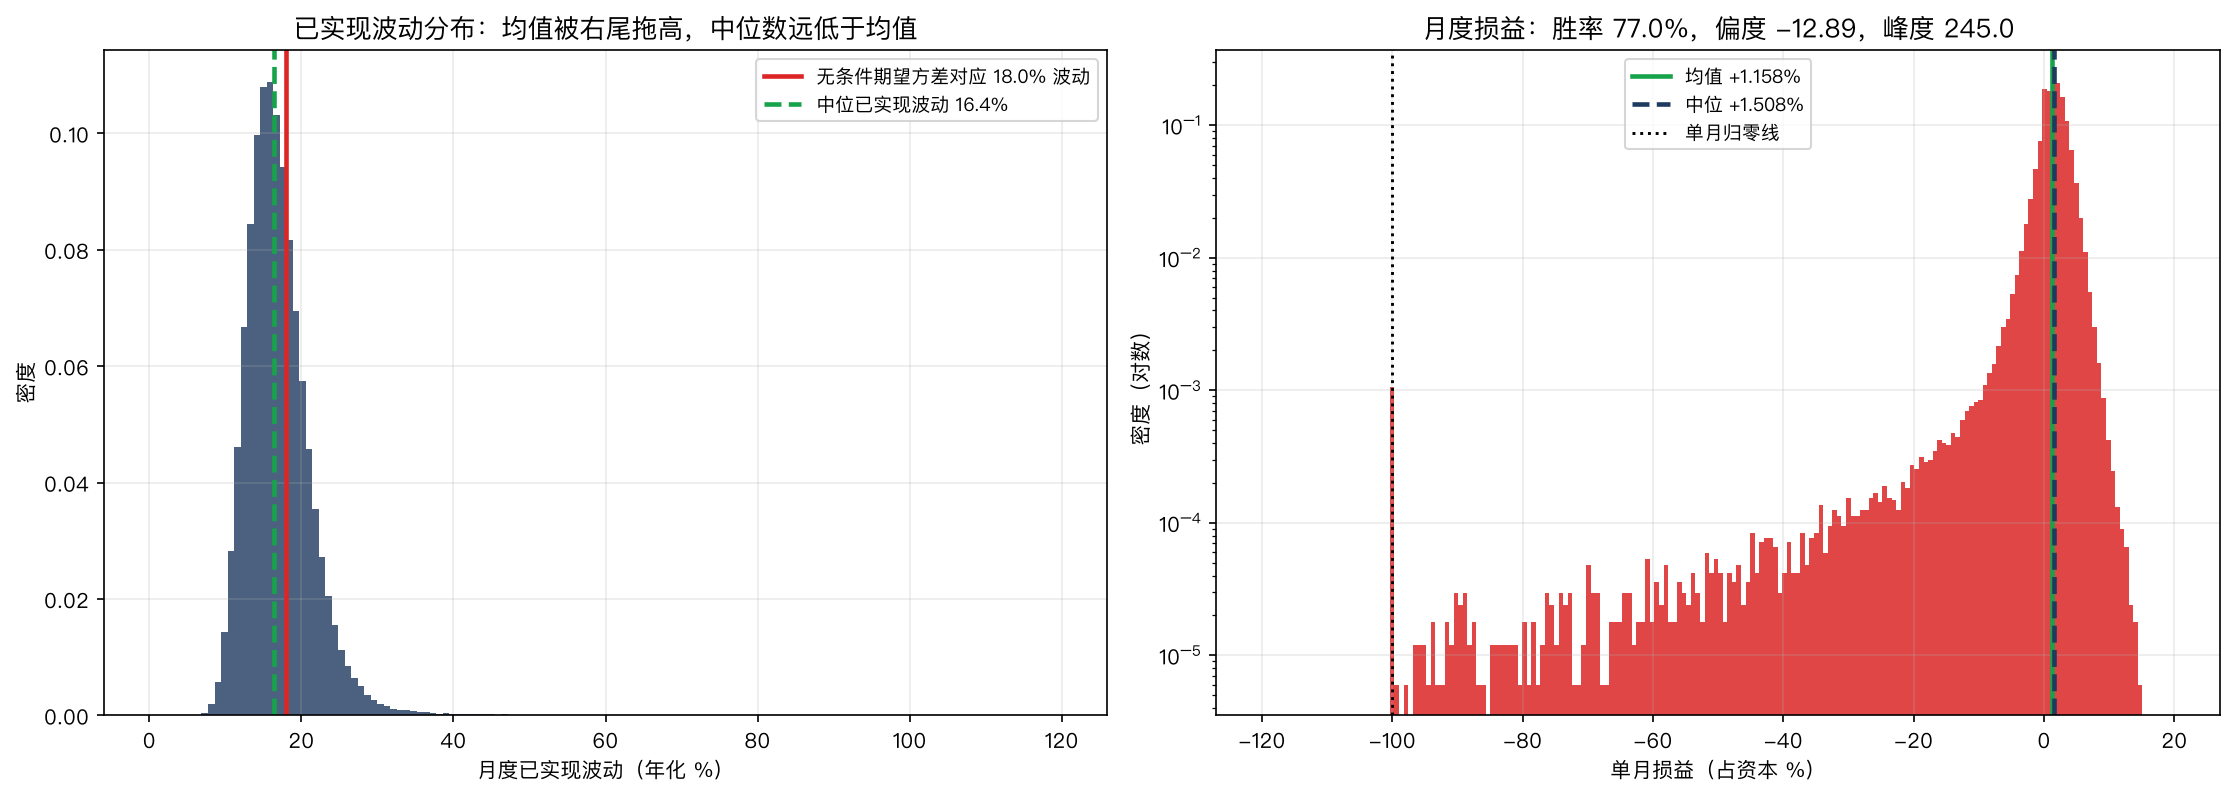
原因不神秘,是一个纯粹的分布事实:已实现方差的均值远高于中位数。
- E[RV] = 0.0324
- median[RV] = 0.026618
- 比值 = 1.2172
公平定价的执行价 K 必须等于均值(这是精算公平的定义),而你每个月面对的那个 RV,典型值是中位数。于是在一个溢价为零的世界里,典型月份的损益是:
25 × (0.0324 − 0.026618) / 12 = +1.20% / 月
这笔钱不是溢价,是右偏分布的几何必然。 它会在绝大多数月份里稳定出现,然后在少数月份里被一次性全部收回——这正是均值为零的含义。
所以,那句在券商路演材料里出现率极高的话——「过去 N 年隐含波动平均比已实现波动高 X 个点,所以这是一个结构性的正期望策略」——它的证据和结论之间是断开的。观察到「大部分月份赚钱」,与「存在风险溢价」,在数据上几乎无法区分。
三、另外两条安慰剂:锁死机制#
安慰剂 B:零波动率不确定性。 把对数方差的波动设为 0、跳跃关掉,RV 每期精确等于公允值。此时损益是确定性的:
25 × 0.15 × 0.0324 / 12 = 1.0125% / 月 → 年化 12.8500%
- 实测中位 CAGR 12.849967%
- 解析 12.849967%
- 绝对偏差 1.23e-13
- 月度损益标准差 4.52e-11,归零概率 0.00%,中位最大回撤 0.00%
引擎在确定性极限下精确坍缩到解析解。
安慰剂 C:无跳跃。 保留全部波动聚集(φ=0.75)和全部对数正态波动率不确定性,只把跳跃拿掉:
| 指标 | 基准 | 无跳跃 |
|---|---|---|
| 中位 CAGR | +14.46% | +12.61% |
| 归零概率 | 24.10% | 0.00% |
| 净值跌破 10% 的概率 | 24.19% | 0.00% |
| 中位最大回撤 | 51.08% | 13.99% |
| 95 分位最大回撤 | 100.0% | 26.58% |
| 月度 Sharpe(年化) | 0.869 | 1.592 |
| 最差单月 | −100.0% | −39.47% |
| 月度偏度 | −12.89 | −0.75 |
这是一个非常干净的分离:中位收益几乎不变(12.61% vs 14.46%),而归零风险从 24.10% 精确塌到 0。
结论很硬:卖波动的收益来自波动率的分布形状,而它的死亡来自跳跃。这是两个可以完全分开的机制。 一个只用扩散型随机波动率模型(Heston 类)做风控的团队,会得到一个 Sharpe 1.59、最大回撤 26% 的策略画像——而真实世界里对应的是 24% 的归零概率。
四、中位数和均值指向相反的方向#
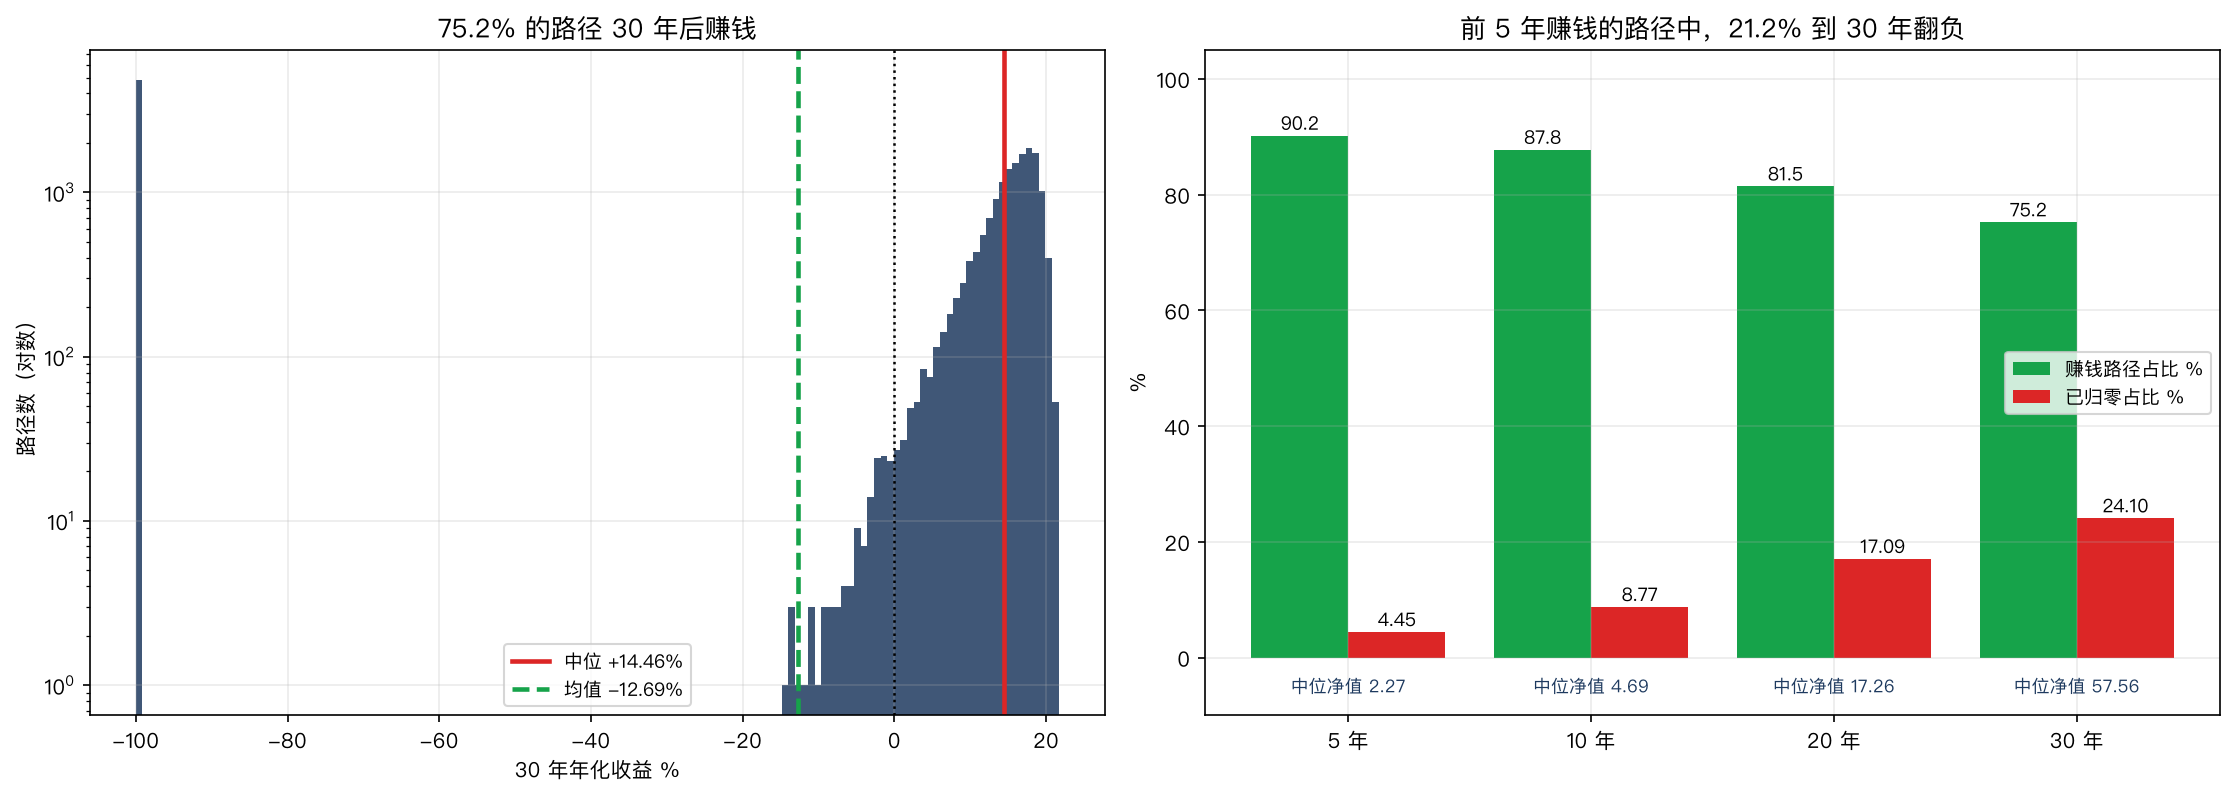
基准情景:中位 CAGR +14.46%,均值 CAGR −12.69%。
这不是数值问题。24.10% 的路径归零(CAGR = −100%),把均值拖到深度负值;而剩下 75.90% 的路径里,大部分表现得相当漂亮。这个策略的收益分布不是「有点偏」,是双峰的。
30 年终值的分位数:
| 分位 | 30 年 CAGR |
|---|---|
| 5 分位 | −100.00%(归零) |
| 中位 | +14.46% |
| 95 分位 | +19.40% |
注意 95 分位(+19.40%)和中位(+14.46%)挨得很近,而 5 分位直接是 −100%。上行被封顶(你最多赚到保费),下行没有底。 这是保险业务的标准形状,只是杠杆 25 倍之后它变得极端。
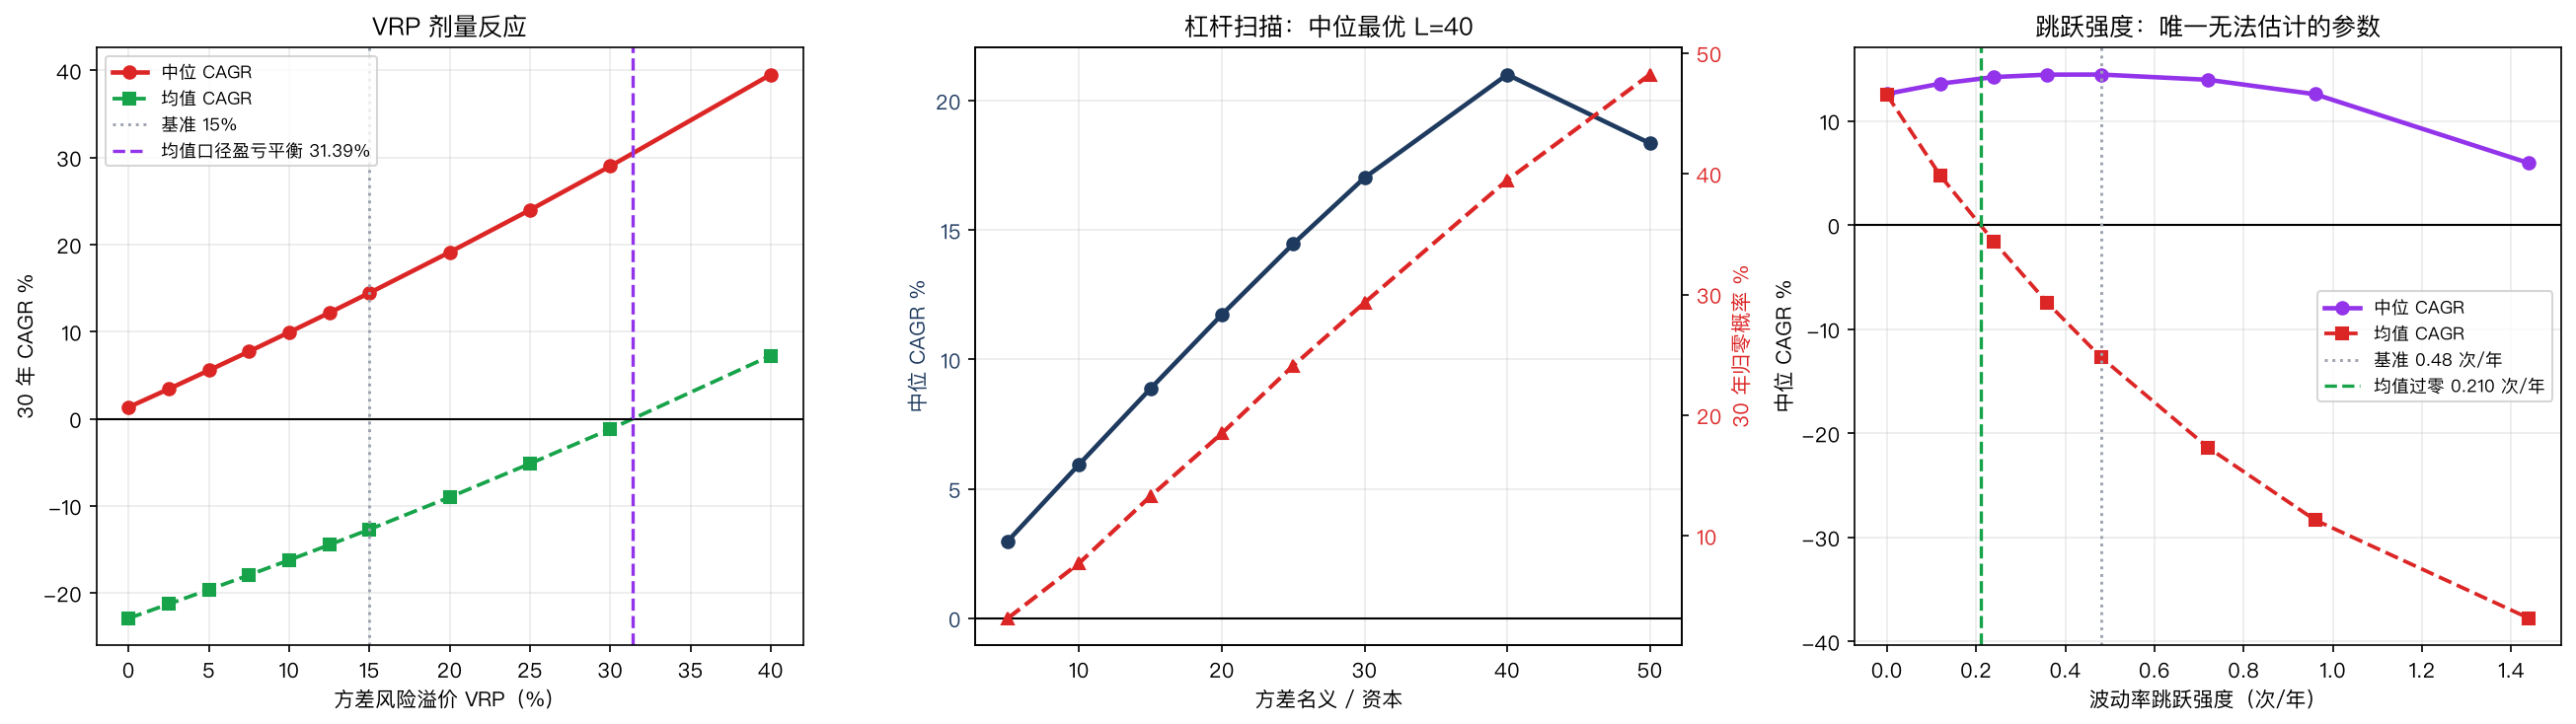
均值口径的盈亏平衡 VRP 是 31.39%,而基准 VRP 是 15%。安全边际 −52.2% —— 也就是说,按均值口径,这门生意在基准参数下是亏的,要让它在均值上打平,溢价必须比现在再翻一倍。
那到底该看哪个口径?取决于你是谁:
- 如果这是你自己全部的钱,你只能活在一条路径上,中位数(+14.46%)是更相关的数字,但你要接受 24.10% 的概率归零
- 如果这是一个基金产品,管理人赚的是所有路径上的管理费与业绩报酬,而投资人承担的是自己那一条路径,两者口径不同
- 如果这是一个资产负债表上的头寸,且亏损会传染到其他业务,那么均值口径(−12.69%)才是对的
同一个策略,同一份模拟,三个正确答案。这不是模棱两可,是这类损益结构的固有属性。
五、剂量反应:哪个参数决定生死#
VRP 扫描(其余参数不动):
| VRP | 中位 CAGR | 均值 CAGR | 归零概率 |
|---|---|---|---|
| 0% | +1.35% | −22.90% | 24.40% |
| 5% | +5.57% | −19.61% | 24.29% |
| 10% | +9.95% | −16.21% | 24.19% |
| 15%(基准) | +14.46% | −12.69% | 24.10% |
| 25% | +23.99% | −5.14% | 23.82% |
| 40% | +39.54% | +7.26% | 23.46% |
注意最右边一列:VRP 从 0 拉到 40%,归零概率只从 24.40% 降到 23.46%。 溢价决定你赚多少,几乎完全不决定你会不会死。这两件事在这个策略里是解耦的——而实务中「因为溢价高所以现在做更安全」是一个非常常见的推理。
跳跃强度扫描才是决定生死的那一个:
| 跳跃强度 | 中位 CAGR | 均值 CAGR | 归零概率 |
|---|---|---|---|
| 0 次/年 | +12.61% | +12.52% | 0.00% |
| 0.12 次/年 | +13.59% | +4.75% | 7.49% |
| 0.24 次/年 | +14.22% | −1.58% | 13.56% |
| 0.48(基准) | +14.46% | −12.69% | 24.10% |
| 0.96 次/年 | +12.58% | −28.32% | 38.70% |
| 1.44 次/年 | +5.95% | −37.77% | 47.44% |
均值口径的过零点在 0.2100 次/年,而基准是 0.48 次/年。 你站在盈亏线错误的一侧,而且错得不少(超出 129%)。
归零概率对跳跃强度的斜率是 0.3013 /(次/年),高度线性。
这里有一个方法论上的麻烦:「未来 30 年平均每年会发生几次波动率跳升」恰恰是所有参数里最不可估计的那一个。 中位 CAGR 对它极不敏感(0 到 0.48 次/年之间,中位数在 12.6%~14.5% 之间几乎持平),而均值 CAGR 和归零概率对它极其敏感。你最容易观测到的指标,对这个最关键的参数最不敏感。
杠杆扫描出现一个典型的非单调:
| 名义/资本 | 中位 CAGR | 均值 CAGR | 归零概率 | 中位最大回撤 |
|---|---|---|---|---|
| 5x | +2.98% | −0.61% | 3.17% | 10.5% |
| 15x | +8.87% | −5.87% | 13.29% | 31.0% |
| 25x(基准) | +14.46% | −12.69% | 24.10% | 51.1% |
| 40x | +21.01% | −23.85% | 39.48% | 79.6% |
| 50x | +18.35% | −30.76% | 48.23% | 96.6% |
中位 CAGR 在 40x 见顶后回落——不是因为 50x 更安全,而是因为归零的路径太多,把中位数本身拖下来了。如果用「中位收益最大化」来选杠杆,你会选到 40x,对应 39.48% 的归零概率。 这个口径本身就是陷阱。
六、仓位口径:Sharpe 分不出来,生死差 96 倍#
同一个策略、同一组随机数,只改仓位管理方式:
| 口径 | 中位 CAGR | Sharpe | 归零概率 | 95 分位回撤 |
|---|---|---|---|---|
| 恒定相对杠杆 | +14.46% | 0.869 | 24.10% | 100.0% |
| 名义固定(不随净值缩放) | +5.83% | 0.637 | 8.52% | 100.0% |
| 赔付封顶(上限型) | +15.87% | 1.222 | 0.25% | 72.7% |
| 恒定 vega | +14.20% | 0.883 | 23.75% | 100.0% |
| 巨亏后停做 3 个月 | +14.15% | 0.862 | 23.82% | 100.0% |
Sharpe 极差只有 0.584,而归零概率相差 96.4 倍。
其中四种口径的 Sharpe 挤在 0.637~0.883 这个区间里——在任何一份月度或季度业绩报告里,这四个数字是无法区分的。但它们对应的 30 年归零概率是 0.25% 到 24.10%。
最值得注意的是赔付封顶:把单次赔付限制在执行方差的 6.25 倍(相当于 2.5 倍波动),归零概率从 24.10% 塌到 0.25%,而中位 CAGR 反而更高(+15.87% vs +14.46%)——因为活下来的路径能继续复利。
这是全文少有的、几乎没有代价的改进。它在实务中对应的就是买一个更虚值的保护腿,把裸卖变成价差。代价是尾部那部分保费收不到了,而那部分保费恰恰是定价最贵、最不划算的一段。
「巨亏后停做 3 个月」这个直觉上很有吸引力的规则,效果基本为零(归零 23.82% vs 24.10%)——因为杀死你的那一次跳跃是在单月内完成的,等你反应过来,钱已经没了。 这是一个诚实的负面结果。
七、时间不会帮你验证,只会帮你误判#
前 5 年赚钱的路径,占全样本 90.21%。听起来这个策略非常稳。
但在这 90.21% 里面:
- 21.20% 到第 30 年变成亏损
- 20.69% 到第 30 年直接归零
也就是说,「前 5 年赚钱」这个事实,几乎不携带任何关于长期结果的信息。 前 10 年赚钱的路径(占 87.78%)里,仍有 17.26% 到 30 年翻负。
5 年滚动窗口的统计更能说明业绩报告长什么样:
| 指标 | 5 年滚动窗口 |
|---|---|
| 正收益窗口占比 | 90.16% |
| 中位年化 | +17.86% |
| 25 分位 | +12.83% |
| 5 分位 | −30.98% |
| 窗口内归零占比 | 4.51% |
九成的五年期看起来都很好,中位数接近 18%。 这就是为什么这类策略能持续募到钱——它在绝大多数可观测窗口里,确实提供了漂亮的数字。
首次跌破 50% 净值的概率是 29.09%,中位发生在第 133 个月(约 11 年)。你有足够长的时间建立信心,然后才轮到你付账。
八、样本量红线:Sharpe 这个指标在这里几乎没有意义#
月度损益的分布特征:
| 统计量 | 值 |
|---|---|
| 均值 | +1.158% |
| 标准差 | 4.617% |
| 偏度 | −12.89 |
| 峰度 | 244.96 |
| 胜率 | 76.98% |
| 最差单月 | −100.0% |
| 1 分位 | −9.14% |
| 中位 | +1.51% |
年化 Sharpe = 0.869。但是:
剔除最差 1% 的月份后,Sharpe = 2.419。
一个 Sharpe 2.4 的策略和一个 Sharpe 0.87 的策略,差别就是那 1% 的月份。而在 5 年(60 个月)的样本里,你有相当大的概率一次都没遇到。
把 30 年(360 个月)的样本做 bootstrap,估出来的 Sharpe 分布:
| 分位 | 30 年样本估出的 Sharpe |
|---|---|
| 5 分位 | 0.352 |
| 50 分位 | 1.081 |
| 95 分位 | 2.246 |
用 30 年的数据,你估出的 Sharpe 可能是 0.35,也可能是 2.25。 这不是估计精度问题,是这个分布本身导致的——峰度 245 的分布,样本 Sharpe 是极不稳定的统计量。
用天真的公式算所需样本量:(2σ/μ)² = 63.6 个月 ≈ 5.30 年。这个数字是错的,而且错得很危险。它假设独立同分布且分布不太病态;在偏度 −12.89、峰度 245 的情况下,它系统性低估了所需样本量。任何在这类损益上直接套用 t 检验的做法,都会得到一个过于乐观的结论。
九、代码实现#
核心引擎(完整脚本含全部扫描与安慰剂,此处为主循环):
import numpy as np

TD_M = 12
PHI, SIG_X = 0.75, 0.45
LAM, JRATE = 0.04, 1.4
TARGET_RV = 0.18 ** 2

JMEAN   = JRATE / (JRATE - 1.0)              # E[e^J] = 3.5
JFACTOR = (1 - LAM) + LAM * JMEAN
# 反解 mu_x,使 E[RV] 精确等于目标值
MU_X = np.log(TARGET_RV / JFACTOR) - SIG_X ** 2 / 2

def simulate(n_paths=20000, n_months=360, vrp=0.15, lev=25.0,
             lam=LAM, sig_x=SIG_X, phi=PHI, mode="constant",
             cap_mult=6.25, seed=20260807):
    rng = np.random.default_rng(seed)
    s_innov = sig_x * np.sqrt(1 - phi ** 2)
    jmean   = JRATE / (JRATE - 1.0) if lam > 0 else 1.0
    jfactor = (1 - lam) + lam * jmean
    mu_x    = np.log(TARGET_RV / jfactor) - sig_x ** 2 / 2

    x = mu_x + sig_x * rng.standard_normal(n_paths)   # 从无条件分布起步
    equity = np.ones(n_paths)
    alive  = np.ones(n_paths, dtype=bool)

    for m in range(n_months):
        # 公允执行方差:以 t-1 状态为条件的真实期望(解析,非估计)
        fair   = np.exp(mu_x + phi * (x - mu_x) + s_innov ** 2 / 2) * jfactor
        strike = fair * (1 + vrp)

        # 状态推进
        x = mu_x + phi * (x - mu_x) + s_innov * rng.standard_normal(n_paths)
        jump = (rng.random(n_paths) < lam) * rng.exponential(1 / JRATE, n_paths)
        rv = np.exp(x + jump)

        rv_eff = np.minimum(rv, strike * cap_mult) if mode == "capped" else rv
        notional = (lev * (TARGET_RV / fair) if mode == "voltarget"
                    else np.full(n_paths, lev))

        pnl_raw = notional * (strike - rv_eff) / TD_M
        # 关键:亏损不可能超过全部资本,超出部分是违约缺口
        pnl = np.maximum(pnl_raw, -1.0)
        pnl = np.where(alive, pnl, 0.0)

        equity = equity * (1 + pnl)
        wiped  = equity <= 1e-12
        equity = np.where(wiped, 0.0, equity)
        alive  = alive & ~wiped

    yrs = n_months / 12
    cagr = np.where(equity > 0, equity ** (1 / yrs) - 1, -1.0)
return equity, cagr有三个实现细节直接决定结论对不对:
1. 损益必须在 −100% 处截断。 第一版没做这个截断,得到的月度偏度是 −453、峰度 214166、Sharpe 0.011、最差单月 −80588%。这些数字全是垃圾——它们描述的是一个「净值可以变成负数并继续参与复利」的世界。截断之后,偏度 −12.89、峰度 245、Sharpe 0.869。任何带杠杆的爆仓类模拟,都必须显式处理有限责任边界。
2. 执行价必须用条件期望,不能用无条件期望。 波动聚集意味着高波动之后大概率还是高波动,做市商会把这一点定进价格。如果用无条件均值当执行价,你会凭空造出一个「低波动时期卖得贵、高波动时期卖得便宜」的伪 alpha。
3. 初始状态必须从无条件分布抽。 如果所有路径都从 x = mu_x 起步,前若干期的方差会系统性偏低,制造一段虚假的平稳期。
十、这套东西真正的适用边界#
先说什么时候它确实成立:
做市商 / 券商自营 —— 他们的方差空头是客户需求的副产品(结构化产品对冲、备兑开仓委托),不是主动押注;他们有真实的、非对称的信息优势;最重要的是,他们的仓位口径天然接近「赔付封顶」——归零概率 0.25% 的那一行。
真正拿到高溢价的时点 —— 均值口径的盈亏平衡在 VRP=31.39%。历史上确实存在 VRP 冲到这个水平之上的时段(危机后的几个月),但那恰恰是所有人都在减仓、你的风控也不让你加仓的时候。
再说什么时候它不成立:
用中位数或 Sharpe 做决策的任何场景。 五种仓位口径里,Sharpe 极差 0.584、归零概率差 96.4 倍。中位 CAGR 最优的杠杆(40x)对应 39.48% 的归零概率。这两个指标在这类损益上,系统性地指向错误的方向。
「先小仓位试三年,跑通了再加」这个看似稳健的路径。 前 5 年赚钱的概率是 90.21%,而这 90.21% 里有 20.69% 最终归零。三年跑通不是证据,是这个策略的默认状态。 更糟的是,试跑成功会让你加杠杆,而加杠杆几乎不改变中位收益、线性放大归零概率。
任何把「卖波动」和「收租」类比的表述。 收租的下行是租客不付钱(损失有界),卖波动的下行是 25 倍杠杆下的方差跳升(损失可以精确等于全部本金)。这两个损益结构没有任何共同点。
12 个独立宇宙(不同随机种子)的中位 CAGR:CV = 0.0068,结论对随机数选择不敏感。
最后回到开头那个对照。VRP=0 的世界里,这个策略的中位路径依然赚钱。 所以下次看到一条向上的卖波动净值曲线时,值得问的不是「它赚了多少」,而是:如果溢价是零,这条曲线会长得不一样吗?
在这个模型里,答案是:不会有本质区别,除非你等够 30 年,并且刚好活到了付账那天。