可转债双低策略:价格与溢价率的二维打分实战
「双低」是可转债圈最流行的口诀:价格低 + 溢价率低,加起来排序,取分数最小的 20 只。但把它拆成两个维度分别测量,结论并不站在口诀这边。8 年 512 只债、含下修/强赎/违约/炒作的合成市场里,双维分组的行间跨度(价格维度)3.23 个百分点,列间跨度(溢价率维度)2.03 个百分点——溢价率看起来贡献了六成多。可组合层面完全是另一回事:单低价 Sharpe 0.51、单低溢价率 -0.28,把两者合成的排名等权双低 0.66。看似双低赢了,但换 10 个独立随机市场重测,双低减单低价的 Sharpe 差均值 -0.110(t=-1.56),只在 4/10 个市场胜出——基准种子上的胜出是抽样噪音,不是策略优势。溢价率维度真正在做的事是控尾部:回撤从 -30.9% 收窄到 -25.3%,10 种子平均改善 2.16 个百分点(t=1.44)。诊断热力图给出机制:低价区未来半年违约率 3.04%,是高价区的 30 倍,而高价高溢价区的投机溢价成分高达 10.59%——两个维度过滤的是两种完全不同的风险,把它们加成一个标量必然丢信息。还有两个隐蔽 bug:强赎退出仍按含溢价市价结算虚增年化 276bp,事前剔除未来会违约的债虚增 472bp,两者都不会让任何 sanity check 报警
可转债圈流传最广的口诀是「双低」:价格低 + 转股溢价率低,两个数加起来排序,买分数最小的一批。逻辑听起来很完美——价格低意味着债底保护厚,跌不下去;溢价率低意味着贴着转股价值走,正股涨它就跟着涨。下有保底,上不封顶。
这个说法有一个从来没被认真检验过的隐含假设:两个维度都在贡献超额收益,而且方向一致。
用一个 8 年、512 只债、包含下修博弈 / 强赎 / 违约 / 小盘炒作的合成转债市场跑完之后,结论是:价格维度确实在贡献收益,溢价率维度贡献的是别的东西——不是收益,是尾部控制。而且这个区分不做出来,你会得出完全错误的参数选择。
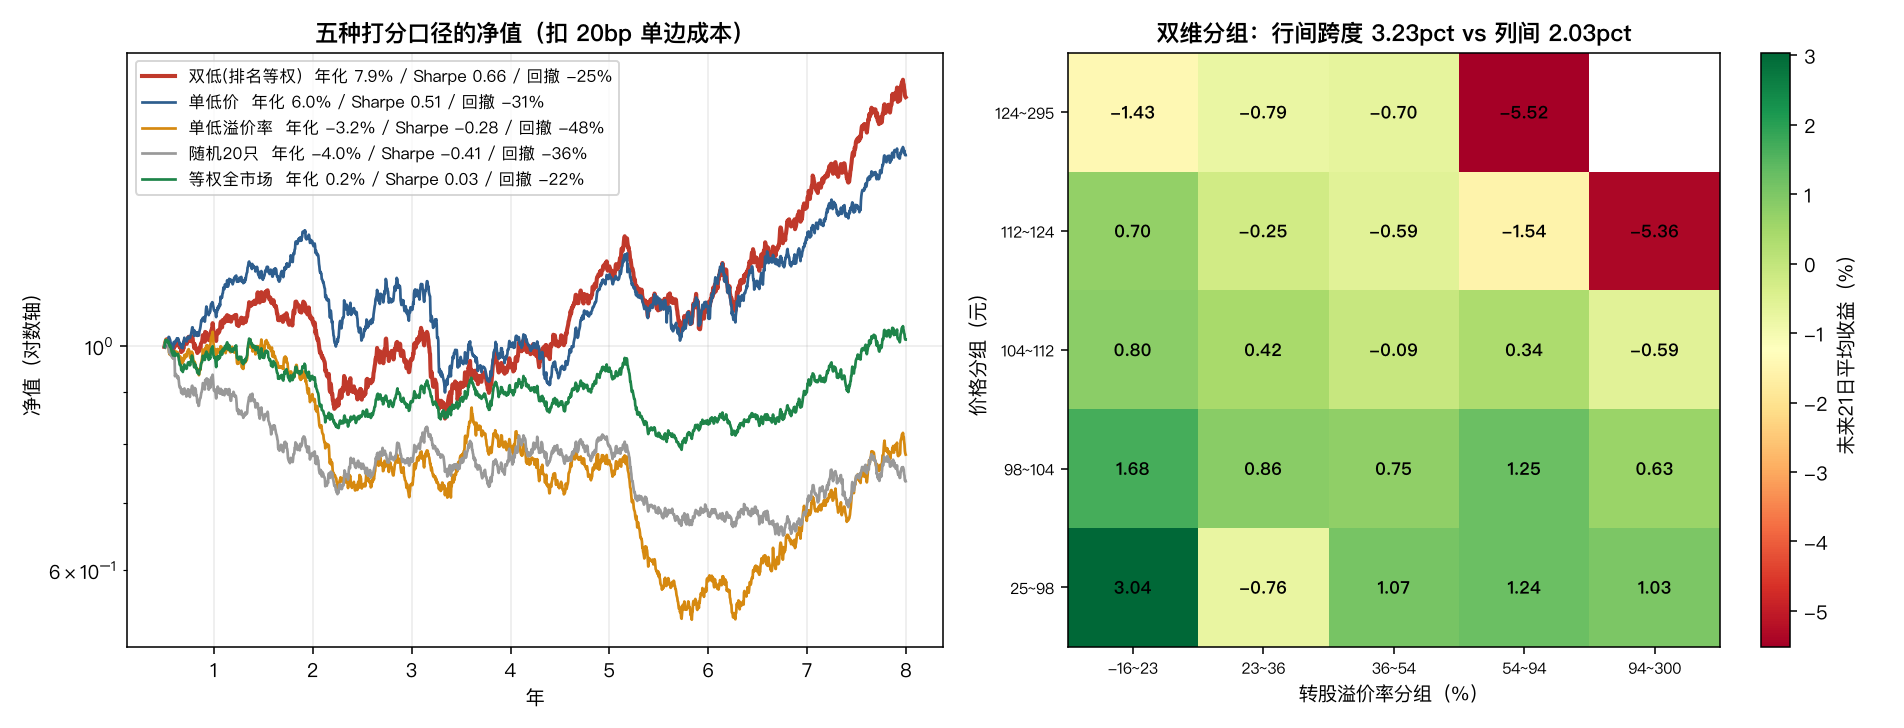
左图是五种打分口径的净值。右图是把所有观测按价格五分组(行)× 溢价率五分组(列)铺开,每格填未来 21 日平均收益。先看右图的边缘均值:最低价一行平均 +1.12%,最高价一行 -2.11%,跨度 3.23 个百分点;最低溢价一列 +0.96%,最高溢价一列 -1.07%,跨度 2.03 个百分点。
看到这里很容易下一个结论:两个维度都有效,溢价率的效力大约是价格的六成。这个结论是错的,错在哪需要往下走两步才看得出来。
一、先把市场造对:三个条款缺一个,结论就会翻#
可转债不是普通信用债。它身上挂着三个会彻底改变收益分布的条款,模拟里少写一个,回测就会跑出完全不同的答案。
强赎:转股价值连续 15/30 日 ≥130 元,发行人可以按面值强制赎回。这对持有人意味着溢价瞬间归零——你只能拿到转股价值,之前市价里那部分溢价直接蒸发。
下修:转股价值连续 20/30 日 ≤70 元,董事会可以提议下调转股价。这是低价债的隐藏看涨期权。
违约:本文把回收价设为 28 元。
CALL_CV, CALL_NEED, CALL_WIN = 130.0, 15, 30   # 强赎:连续 15/30 日转股价值 ≥130
DOWN_CV, DOWN_NEED, DOWN_WIN = 70.0, 20, 30    # 下修:连续 20/30 日 ≤70
RECOVERY = 28.0                                 # 违约回收价

# 状态机用环形缓冲,避免每天回看 30 天切片
s_hi[:, t % CALL_WIN] = cv >= CALL_CV
s_lo[:, t % DOWN_WIN] = cv <= DOWN_CV
call_hit = (s_hi.sum(axis=1) >= CALL_NEED) & (s_age > 130)8 年跑下来:强赎 199 次、到期 132 次、违约 31 次,累计违约率 6.05%。
定价用「纯债价值 + 转股期权」:
def theo_price(cv, sig, ttm, cs):
    floor = FACE * np.exp(-(RF + cs) * ttm)          # 按信用利差贴现的债底
return floor + bs_call(cv, FACE, sig, ttm, RF), floor这里有一个会毁掉整个回测的一致性陷阱#
第一版我把信用利差 CS 和违约强度 H0 当成两个独立参数分别拍脑袋设定。利差设 1.4%~7.2%(照抄真实评级利差),违约强度设成让累计违约率约 2%(照抄 A 股转债真实历史)。
两个数字单独看都对。合起来就是灾难:利差隐含的违约概率远高于我实际模拟出来的违约。低价债于是变成「高贴现率 + 几乎不违约」的免费午餐,回测跑出年化 32.9%、Sharpe 2.03。
这个 bug 的可怕之处在于它不报错、不产生 NaN、净值曲线漂亮得不像话——你只会觉得「双低策略果然强」。
修法是让利差从物理违约强度导出,而不是独立设定:
LAM0 = np.array([0.0006, 0.0018, 0.0045, 0.0110, 0.0260])   # 物理违约强度
LGD = (FACE - RECOVERY) / FACE       # 违约损失率 ≈ 0.73
CREDIT_RP = 1.0                      # 信用风险溢价倍数 = 1 → 信用被公平定价
CS = LAM0 * LGD * CREDIT_RP          # 利差不再是自由参数
H0 = LAM0CREDIT_RP = 1.0 是故意的。只有让信用风险被公平定价,后面的扫描才能干净地回答「违约风险如何侵蚀两个维度」,而不是混进「拿信用溢价赚钱」这个第三方效应。我试过 1.7,扫描曲线会随违约率上升而上翘——那量的是信用溢价,不是选债能力,很容易被误读成「双低在高违约环境更有效」。
而且利差和实际危险率必须共用同一个违约距离缩放,否则一致性会在正股下跌时再次断裂:
def dd_scale(dist):
    return np.clip((0.62 / np.maximum(dist, 0.03)) ** 1.9, 0.25, 25.0)

def cs_dynamic(cs0, dist):
    return cs0 * dd_scale(dist)     # 定价用它

hz = credit_mult * H0[s_ri] / TD * dd_scale(dist) # 实际违约也用它二、投机溢价:溢价率维度的信号从哪来#
如果转债价格严格等于 BS 理论价,溢价率就只是价内程度的机械函数,不含任何独立信息——按它排序等于按 moneyness 排序,第二个维度完全冗余。
现实中溢价率有独立信息,因为 A 股小盘转债会被资金炒作:正股纹丝不动,转债自己涨 30%,溢价率飙到 100%+。这部分溢价既不来自债底也不来自期权,纯粹是情绪,且会均值回归。
# 触发强度只看「规模 + 基本面理论价」,绝不看当前市价
spec_hz = 0.0016 * np.clip((5.0 / s_size) ** 0.9, 0.25, 6.0) * \
    np.clip((112.0 / np.clip(pth, 70.0, 200.0)) ** 1.6, 0.3, 4.0)
s_spec = np.where(rng.random(N) < spec_hz,
s_spec + np.abs(rng.normal(0.16, 0.09, N)), s_spec * PHI_S)注释里那句「绝不看当前市价」是这段代码的全部要害。 如果触发概率依赖当前价格 p,那么「已经被炒高」就会自我预测「继续被炒高」,溢价率维度从均值回归信号退化成动量信号,二维打分的结论整个反过来。我第一版就是用 p 写的,跑出来溢价率维度几乎零效力,查了很久才定位到这一行。
投机溢价半衰期设 22 个交易日,比个券错价的 45 天快得多——炒作消退比估值修复快,这符合观察。
三、组合层面:溢价率维度的收益贡献是零#
把打分公式跑成实际组合(20 只等权、月度调仓、单边 20bp 成本):
| 打分口径 | 年化 | 波动 | Sharpe | 最大回撤 | 月均换手 |
|---|---|---|---|---|---|
| 双低(排名等权) | 7.89% | 11.51% | 0.66 | -25.3% | 0.281 |
| 单低价 | 6.00% | 11.39% | 0.51 | -30.9% | 0.223 |
| 双低(价格+100×溢价) | 5.59% | 11.82% | 0.46 | -27.1% | 0.248 |
| 单低溢价率 | -3.22% | 11.61% | -0.28 | -48.1% | 0.283 |
| 随机 20 只 | -4.00% | 9.96% | -0.41 | -35.9% | 0.864 |
| 等权全市场 | 0.22% | 7.96% | 0.03 | -22.4% | 0.041 |
两件事立刻跳出来。
第一,单低溢价率是负的,而且负得很稳定。 Sharpe -0.28,回撤 -48.1%,比随机选 20 只还差。这和右上角热力图的「低溢价列均值 +0.96%」直接矛盾——分组均值说它有效,组合回测说它有毒。
矛盾来自分组均值不等于可交易收益。低溢价率的债集中在高价区(贴着转股价值、涨了很多的债),这批债强赎概率极高:
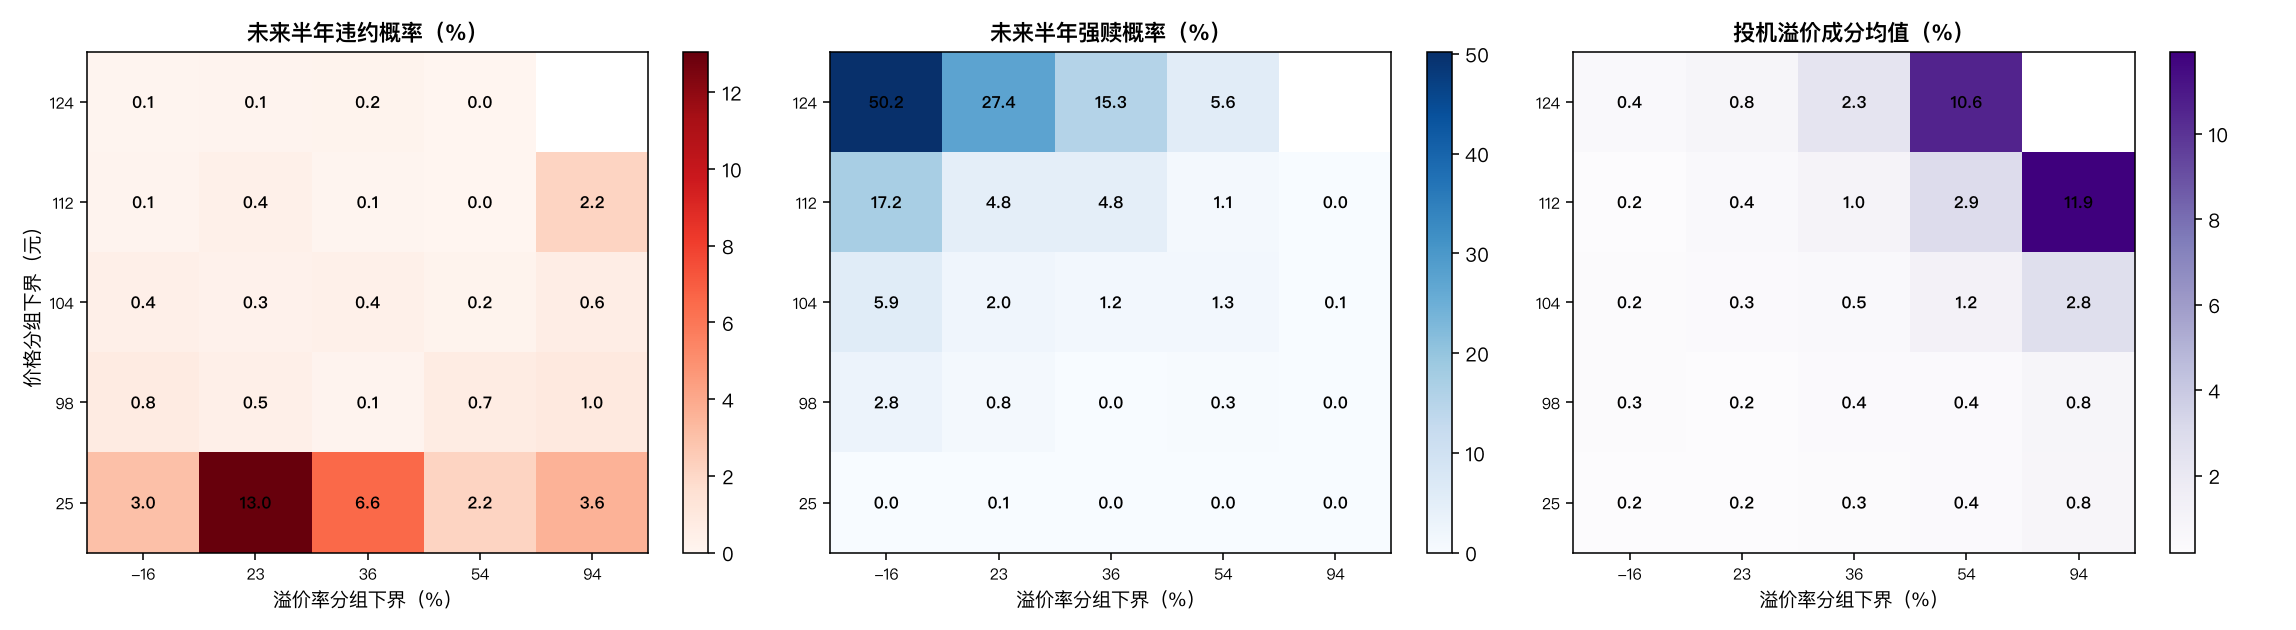
中间那张图,最高价 + 最低溢价那格,未来半年强赎概率 50.19%。纯按低溢价选债,等于系统性地专挑一半会在半年内被强赎的债——强赎那天溢价归零,你按转股价值离场。分组均值里这些债的收益被大量未被强赎的样本稀释了,组合里却是实打实每只都要吃一次。
第二,双低(排名等权)0.66 > 单低价 0.51,看起来溢价率维度确实加了分。
这个「看起来」正是本文最想拆的地方。
四、换 10 个市场重测:优势消失了#
单个随机种子上的 0.66 vs 0.51 到底是策略优势还是抽样噪音?把整个市场用 10 个独立随机种子重新生成,每个市场上都跑一遍三种打分:
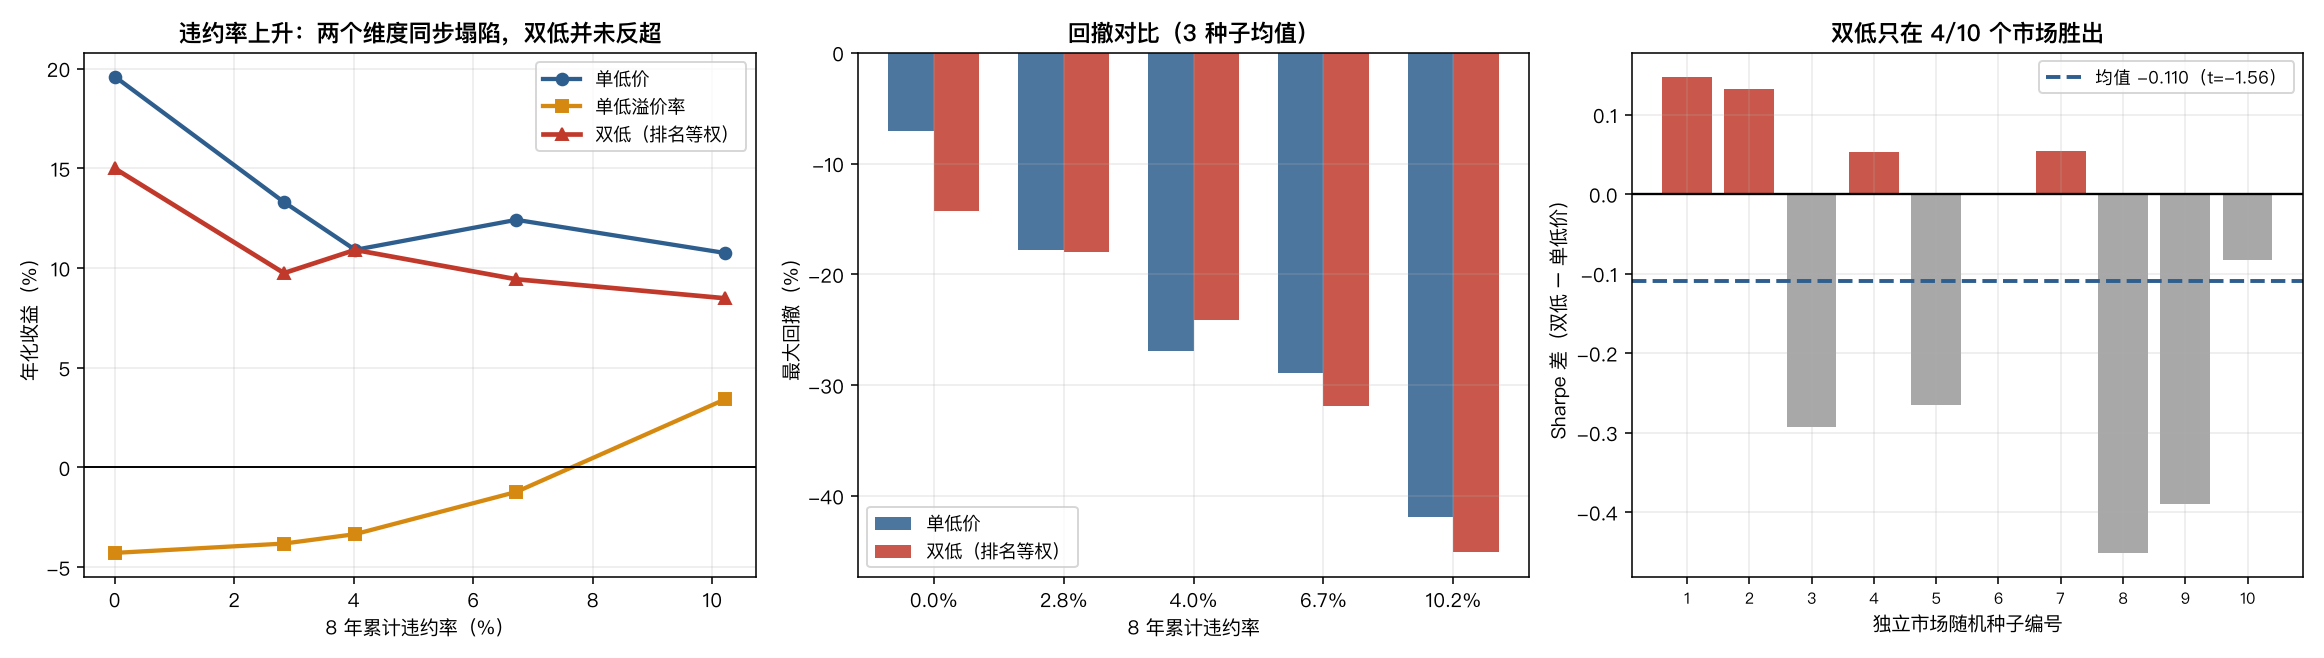
右图是关键。双低减单低价的 Sharpe 差:均值 -0.110,标准差 0.222,t = -1.56,只在 4/10 个市场里为正。
方向不但不显著,均值还是负的。基准种子(第 1 根柱子,+0.148)恰好是双低表现最好的几个市场之一。如果我只跑一个种子就交付,会得出「双低比单低价强 29%」的结论,而真相是溢价率维度对收益的边际贡献统计上不可区分于零,点估计甚至略为负。
三个维度的 10 种子平均 Sharpe:单低价 0.98、双低 0.87、单低溢价率 -0.41。
顺带说明为什么基准种子的绝对水平(0.51)远低于 10 种子均值(0.98):基准种子本身就是个偏难的市场。这也是单种子回测不可信的又一佐证——不只是策略间的比较会翻,绝对水平也能差一倍。
左图和中图是另一个角度:把违约强度从 0 扫到 4 倍(累计违约率 0% → 10.2%),三条线同步下行,双低在任何违约水平上都没有反超单低价。我原本预期「违约率高时溢价率维度作为信用过滤器会体现价值」——数据不支持这个预期,如实报告。
五、那溢价率维度到底在干什么#
它在控尾部。
10 个种子上,双低相对单低价的最大回撤平均改善 2.16 个百分点(t = 1.44),基准种子上从 -30.9% 收窄到 -25.3%。t 值同样不到 2,但方向一致性比收益那边好,而且有清晰的机制解释。
回到诊断热力图。左图是未来半年违约概率:最低价一行 3.04%,最高价一行约 0.1%,相差 30 倍。低价债的收益分布左尾极厚。右图是投机溢价成分:低价区平均 0.37%,高价区 3.55%,高价高溢价那格高达 10.59%。
于是两个维度在过滤两种完全不同的风险:
- 价格维度:低价 = 高违约风险 + 高下修期权。它是收益引擎,但左尾很厚。
- 溢价率维度:高溢价 = 投机泡沫 + 强赎前的溢价蒸发。它是风险过滤器,本身不产生收益。
把两个维度加成一个标量,本质上是拿一部分收益换一部分尾部。这笔交易在 Sharpe 上大致打平(-0.11,不显著),在回撤上略微有利(+2.16pct,不显著)。所以双低不是「更好的策略」,是「风险偏好不同的策略」。
六、量纲:为什么经典公式反而更差#
注意上表里两个双低差了不少:排名等权 0.66,价格 + 100×溢价率 只有 0.46。
经典公式 价格 + 100 × 溢价率 隐含一个从来没人明说的权重假设:1 元价格 = 1 个百分点溢价率。但在本文市场里,价格的五分位跨度是 25.2 → 295.5 元,溢价率是 -15.5% → 300%。两者分布形态完全不同,直接相加等于让分布更分散的那个维度主导排序。
扫一遍权重就看得很清楚:
公式 价格 + w×100×溢价率 | w=0 | w=0.25 | w=0.5 | w=1.0 | w=2.0 | w=5.0 |
|---|---|---|---|---|---|---|
| 年化 | 6.00% | 8.23% | 6.33% | 5.59% | 2.91% | 0.51% |
| Sharpe | 0.51 | 0.68 | 0.52 | 0.46 | 0.25 | 0.04 |
经典的 w=1 不是最优,w=0.25 才是。 溢价率权重越高越差,w=5 时 Sharpe 掉到 0.04。
排名式打分把两个维度都转成 0~1 百分位,量纲问题自动消失:
def mk_rank(w=0.5, m=None):
    P, Q = m["price"], m["prem"]
    def f(t, rs):
        ra = np.argsort(np.argsort(np.where(np.isfinite(P[t]), P[t], np.inf))) / N
        rb = np.argsort(np.argsort(np.where(np.isfinite(Q[t]), Q[t], np.inf))) / N
        return (1 - w) * ra + w * rb
return f排名口径下的权重扫描:溢价权重 0 → 0.51、0.25 → 0.57、0.5 → 0.66、0.75 → 0.32、1.0 → -0.28。等权是最优,且曲线在 0.5 附近平坦——比原始公式稳健得多,因为它不依赖两个变量的绝对分布。
不过要记住上一节的结论:这个 0.66 的优势换 10 个市场就消失了。排名法解决的是量纲问题,不是「溢价率维度无收益贡献」这个更根本的问题。
七、两个不会报警的 bug#
Bug 1:强赎退出仍按含溢价市价结算。 强赎的经济含义是溢价归零、按转股价值离场。如果图省事写成「按前一日市价卖出」:
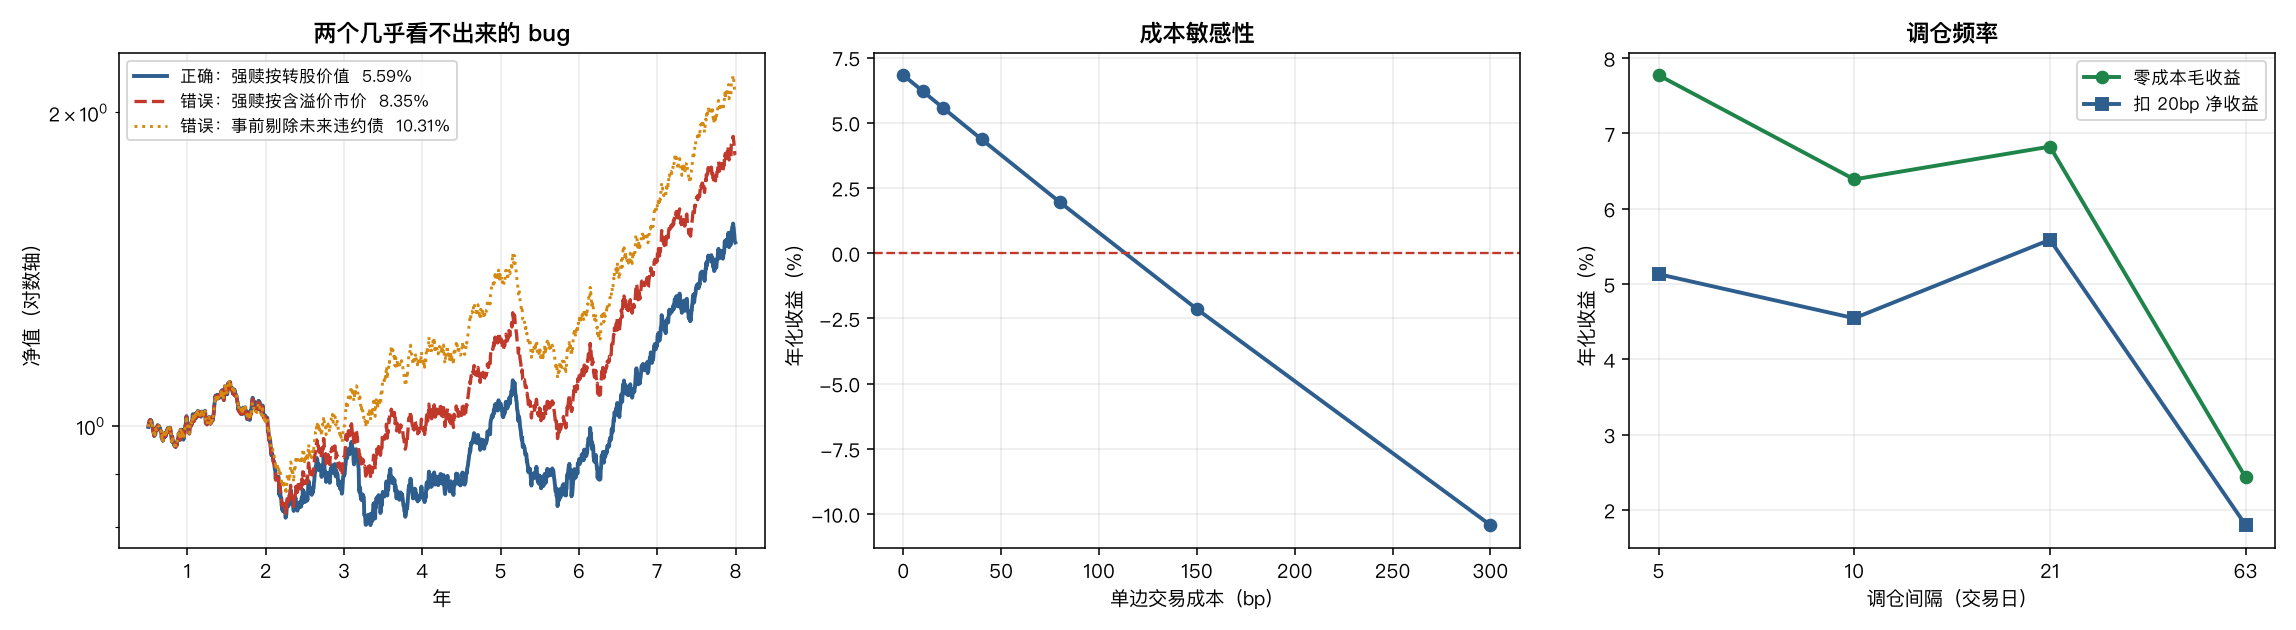
px = EN[t, j] if naive_exit else EV[t, j] # EN = 含溢价市价(错),EV = 转股价值(对)年化从 5.59% 虚增到 8.35%,多出 276bp。8 年 199 次强赎,每次白拿一点溢价,复利下来就是这个数。净值曲线形状几乎不变,Sharpe 从 0.46 到 0.70——没有任何 sanity check 会对此报警。
Bug 2:事前剔除会违约的债。 选债时用 exit_kind[t:t+260] == 2 排除未来一年内违约的标的,这是教科书级 look-ahead,但写出来毫无违和感——你只是在「过滤掉垃圾债」。年化虚增到 10.31%,多出 472bp。
这两个 bug 加起来能把 5.59% 变成 10% 以上,而且都不会让程序崩溃、不会产生异常值、不会让净值曲线看起来可疑。
八、成本与频率#
单边成本从 0 到 300bp:6.83% → 6.21%(10bp)→ 5.59%(20bp)→ 4.36%(40bp)→ 1.95%(80bp)→ -2.14%(150bp)→ -10.42%(300bp)。盈亏平衡在 120bp 附近。可转债 T+0、无印花税、佣金通常万分之几,20bp 已经是含冲击的保守估计,所以成本不是这个策略的主要约束。
调仓频率的账更有意思:
| 调仓间隔 | 5 日 | 10 日 | 21 日 | 63 日 |
|---|---|---|---|---|
| 毛年化 | 7.77% | 6.39% | 6.83% | 2.43% |
| 净年化 | 5.13% | 4.55% | 5.59% | 1.80% |
| 月均换手 | 0.124 | 0.176 | 0.248 | 0.403 |
注意换手率随调仓间隔拉长而上升(0.124 → 0.403),这和直觉相反。原因是月均换手按「每次调仓的单边换手 ÷ 间隔月数」摊算,间隔越长持仓漂移越远,单次换手越大。63 日调仓毛收益断崖式下跌(2.43%),说明信号衰减快于季度——投机溢价半衰期 22 天、个券错价 45 天,季度调仓时信号早就凉了。
九、收益归因#
对基准种子的双低组合做逐日分解(年化贡献):估值收敛 +7.91%、时间价值与债底 -2.75%、条款事件 -1.84%、正股 -0.06%。
条款事件里:违约 8 次 -2.54%、到期 29 次 +0.58%、强赎 9 次 +0.11%。
三点值得读:
估值收敛是唯一的收益来源。 低价 + 低溢价筛出的是相对理论价被低估的债,错价回归贡献全部正收益。这也意味着策略高度依赖「错价会收敛」这个假设——如果市场长期不修正,这块收益不存在。
正股贡献几乎为零(-0.06%)。 双低策略选的是深度价外的债,delta 很低,正股涨跌基本传导不过来。所以它不是一个「等正股上涨」的策略,把它当股票替代品是误解。
时间价值 -2.75% 是必然的持有成本。 期权时间价值随到期临近衰减,这是买入并持有可转债的固定支出,必须靠估值收敛覆盖掉。
十、这个研究没有回答的问题#
合成市场不是真实市场。 投机溢价的触发概率、下修意愿、违约强度全是我设定的。真实 A 股转债市场里,下修博弈涉及大股东持仓、股权稀释意愿等模型完全没有的因素;2021 年后的转债炒作烈度也远超本文设定。这里能信的是机制方向和 bug 清单,不是具体数字。
违约样本太少。 31 次违约、组合里实际吃到 8 次。信用维度的所有结论都建立在这 8 次上,统计上非常脆弱。真实历史更极端——A 股转债在搜特、蓝盾之前几乎零违约,这意味着任何在历史数据上回测的双低策略,都没有真正经历过信用风险定价。
未建模的现实约束。 低价转债的流动性可能极差,20 只等权在实盘会遇到买不进卖不出;强赎公告到实际赎回有窗口期,理性持有人会提前卖出而非等到最后;下修博弈的实际收益依赖能否提前预判,本文按外生概率处理。
收尾#
回到那个口诀。「双低」作为一个记忆装置是好的——它同时提醒你看债底和看弹性。但作为一个打分公式,它有三个问题:
- 两个维度的作用完全不同。价格是收益引擎(低价区违约率是高价区的 30 倍,风险溢价在那里),溢价率是风险过滤器(高价低溢价区强赎概率 50.19%)。把它们相加,等于用一个标量表达两种正交的风险。
- 溢价率维度的收益贡献不显著。10 个独立市场上 Sharpe 差 -0.110(t=-1.56),只在 4/10 个市场胜出。它买到的是回撤改善 2.16 个百分点(t=1.44),不是收益。
- 经典公式的量纲是错的。
价格 + 100×溢价率隐含 w=1,实测最优在 w=0.25;排名式打分能绕开量纲问题,但绕不开第 2 点。
至于方法论上的教训,只有一条:任何「A 组合比 B 单独用更好」的结论,在换过 10 个随机种子之前都不算数。本文的基准种子给出 +0.148 的差值,看起来干净利落;10 个种子的均值是 -0.110。差别不在代码,在有没有多跑九次。