分数 Kelly 仓位:为什么全 Kelly 是理论最优却是实战自杀
真值精确设为 μ=6%、σ=20%(f*=1.50x),20 年 × 2 万路径:全 Kelly 确实兑现数学承诺(中位 4.53% 对理论 4.5000%、偏差 0.0015),代价是中位回撤 70.67%、95.01% 的路径腰斩、2.19% 出局。半 Kelly 只放弃 25% 增长率,回撤砍到 42.68%。但真正的杀手是参数误差:用 10 年历史估 μ(SE=6.32%),全 Kelly 平均真实增长率是 −0.55%、半 Kelly +2.15%,需 50 年数据全 Kelly 才反超。零优势安慰剂实测 −0.2826/−1.1235/−4.4073% 对理论 −0.2812/−1.1250/−4.5000%,零波动偏差 7.57e-06。跳跃是连续公式盲区:期望补偿后的 −20%/年冲击下真最优仅 0.45x(高估 2.22 倍)、全 Kelly 翻负 −0.75%,而 t(4) 厚尾几乎无影响——胖尾不可怕,可怕的是跳。全 Kelly 逐路径跑赢半 Kelly 20 年只有 63.1%、80 年才 74.3%,且 43.31% 的路径连半 Kelly 中位数都够不到
Kelly 公式是量化圈少数几个「数学上被证明了最优」的东西:在已知优势和已知赔率下,按 f* = μ/σ² 的比例下注,能最大化长期财富的对数增长率。这个证明是对的,没有争议。
然后几乎所有实际用它的人都会告诉你:别按全 Kelly 下注,用一半,或者四分之一。
这看起来很分裂——明明是最优解,为什么所有从业者都主动往回退?
把真值精确设为 μ=6%、σ=20%(于是 f* = 0.06/0.04 = 1.50x 杠杆),跑 20 年 × 2 万条路径,答案分三层,而大多数人只知道第一层。
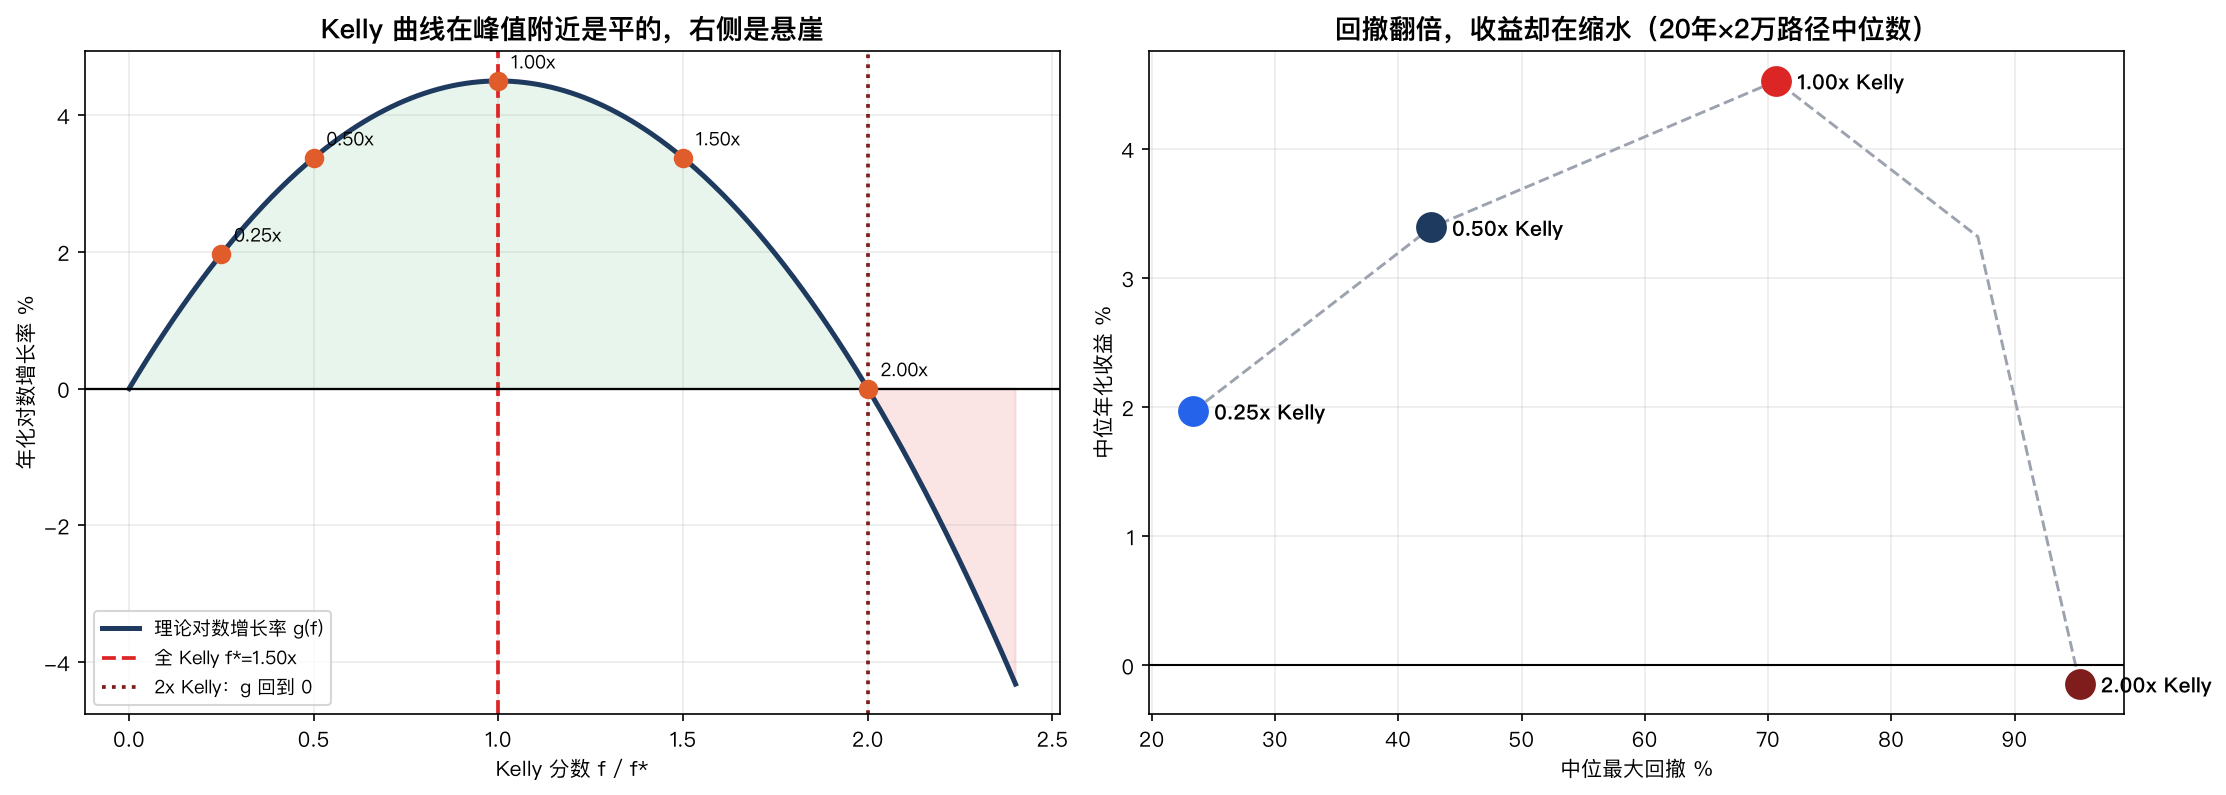
左图是那条著名的抛物线。注意它的形状:峰值附近极其平坦,右侧极其陡峭。从 0.5x 到 1.0x 只多赚 1.125 个百分点,而从 1.0x 到 1.5x 又原样吐回去——下注 1.5 倍 Kelly 的增长率,和下注 0.5 倍 Kelly 完全一样(都是 3.375%),但回撤是后者的两倍。
右图是代价:中位回撤从 0.25x 的 23.4% 一路走到 2.0x 的 95.3%,而中位收益在 1.0x 之后开始倒退。
一、第一层:全 Kelly 确实兑现了它的承诺#
先确认引擎是对的。理论对数增长率 g(f) = f·μ − ½f²σ²,仿真的中位年化收益应该逼近它(对数正态分布的中位数就是 exp(g·T))。
| Kelly 分数 | 实际杠杆 | 理论 g | 实测中位 CAGR | 中位最大回撤 | 腰斩概率 | 出局率 |
|---|---|---|---|---|---|---|
| 0.25x | 0.375x | 1.9687% | 1.9688% | 23.38% | 0.61% | 0.000% |
| 0.50x | 0.75x | 3.3750% | 3.3914% | 42.68% | 28.81% | 0.000% |
| 1.00x | 1.50x | 4.5000% | 4.5261% | 70.67% | 95.01% | 2.19% |
| 1.50x | 2.25x | 3.3750% | 3.3207% | 87.02% | 99.99% | 16.35% |
| 2.00x | 3.00x | 0.0000% | −0.1450% | 95.30% | 100.00% | 38.95% |
理论和实测的最大偏差是 0.0015,纯蒙特卡洛误差。全 Kelly 确实给出了最高的中位增长率,数学没有骗人。
但看后三列。全 Kelly 有 95.01% 的路径会经历腰斩,2.19% 的路径直接亏到只剩 10%(本文的出局定义)。
而 2.0x Kelly 那一行是理解整件事的关键:理论增长率精确等于 0。你承担了 3 倍杠杆、95.3% 的中位回撤、38.95% 的出局率,长期增长率是零。这不是「收益低一点」,是全部优势被波动拖累精确吃光。
这就是 Kelly 曲线右侧的悬崖。
二、第二层:分布长什么样,比中位数重要#
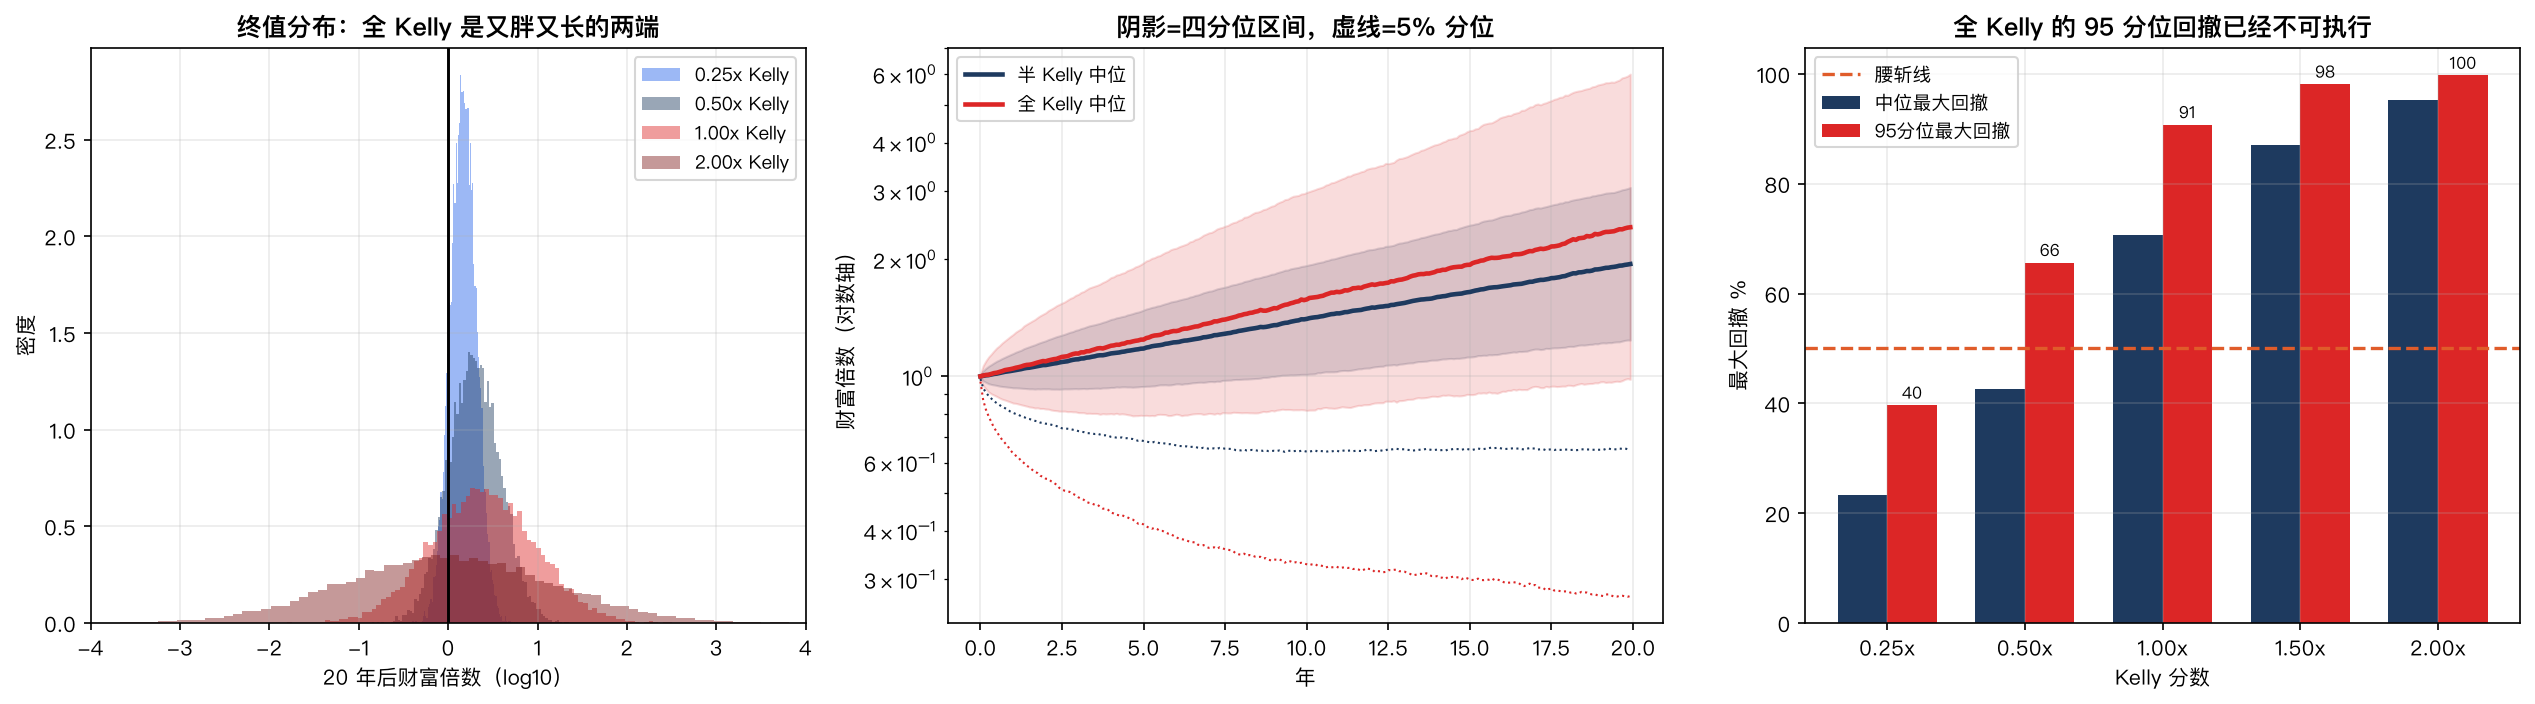
左图的终值分布(log10 轴)解释了为什么「中位增长率最高」是个有欺骗性的指标。
全 Kelly 20 年后:中位财富 2.42 倍,均值 6.02 倍。均值是中位数的 2.48 倍。
半 Kelly:中位 1.95 倍,均值 2.45 倍,比值只有 1.26。
这个差距说明全 Kelly 的收益高度集中在少数极端路径上。均值被右尾拉走了,而你只能活在一条路径上。
更直接的数字:全 Kelly 有 43.31% 的路径,20 年后连半 Kelly 的中位数(1.95 倍)都达不到。 你多冒了一倍的风险,接近一半的概率还不如老老实实用半仓的中间结果。
中图是分位数路径。全 Kelly 的中位线(红)确实一直在半 Kelly(深蓝)上方,但看那条 5% 分位虚线——全 Kelly 的下 5% 分位在 20 年里长期趴在 1.0 以下,也就是说每 20 个平行世界里就有 1 个,你辛苦 20 年还是亏的(实际亏损概率 25.41%)。
右图是回撤的 95 分位:全 Kelly 90.76%,1.5x Kelly 98.15%,2.0x Kelly 99.74%。
这里要说一句实话:90% 的回撤在数学上是可恢复的,在现实中不是。 没有任何机构投资人会在你回撤 90% 时还留在基金里,没有任何个人能在账户剩 10% 时保持策略纪律。Kelly 公式假设你可以无限期地按比例下注,而现实中回撤会通过赎回、追加保证金、和你自己的心理,把「按比例」这个前提摧毁掉。
半 Kelly 保留 75% 的理论增长率(3.375% / 4.5%),四分之一 Kelly 保留 43.75%。用四分之一的增长率换掉一半的回撤,对绝大多数真实约束下的资金来说是划算的。
三、第三层:真正的杀手是你根本不知道 μ#
前两层是教科书内容。这一层才是全 Kelly 在实战中真正致命的原因。
上面所有计算都假设你精确知道 μ=6%。现实中你只能估计它,而均值的估计误差大得惊人:标准误 = σ/√T。
σ=20% 时:
- 用 1 年数据估计 → SE = 20.0%(比 μ 本身大三倍)
- 用 10 年数据估计 → SE = 6.32%(仍然比 μ 大)
- 用 50 年数据估计 → SE = 2.83%
你需要 44 年数据,才能让 μ 的标准误降到 μ 本身的一半。
而 Kelly 公式对 μ 是线性放大的:f* = μ/σ²。μ 估高一倍,杠杆就开高一倍,而增长率是 f 的二次函数——错误被平方放大。
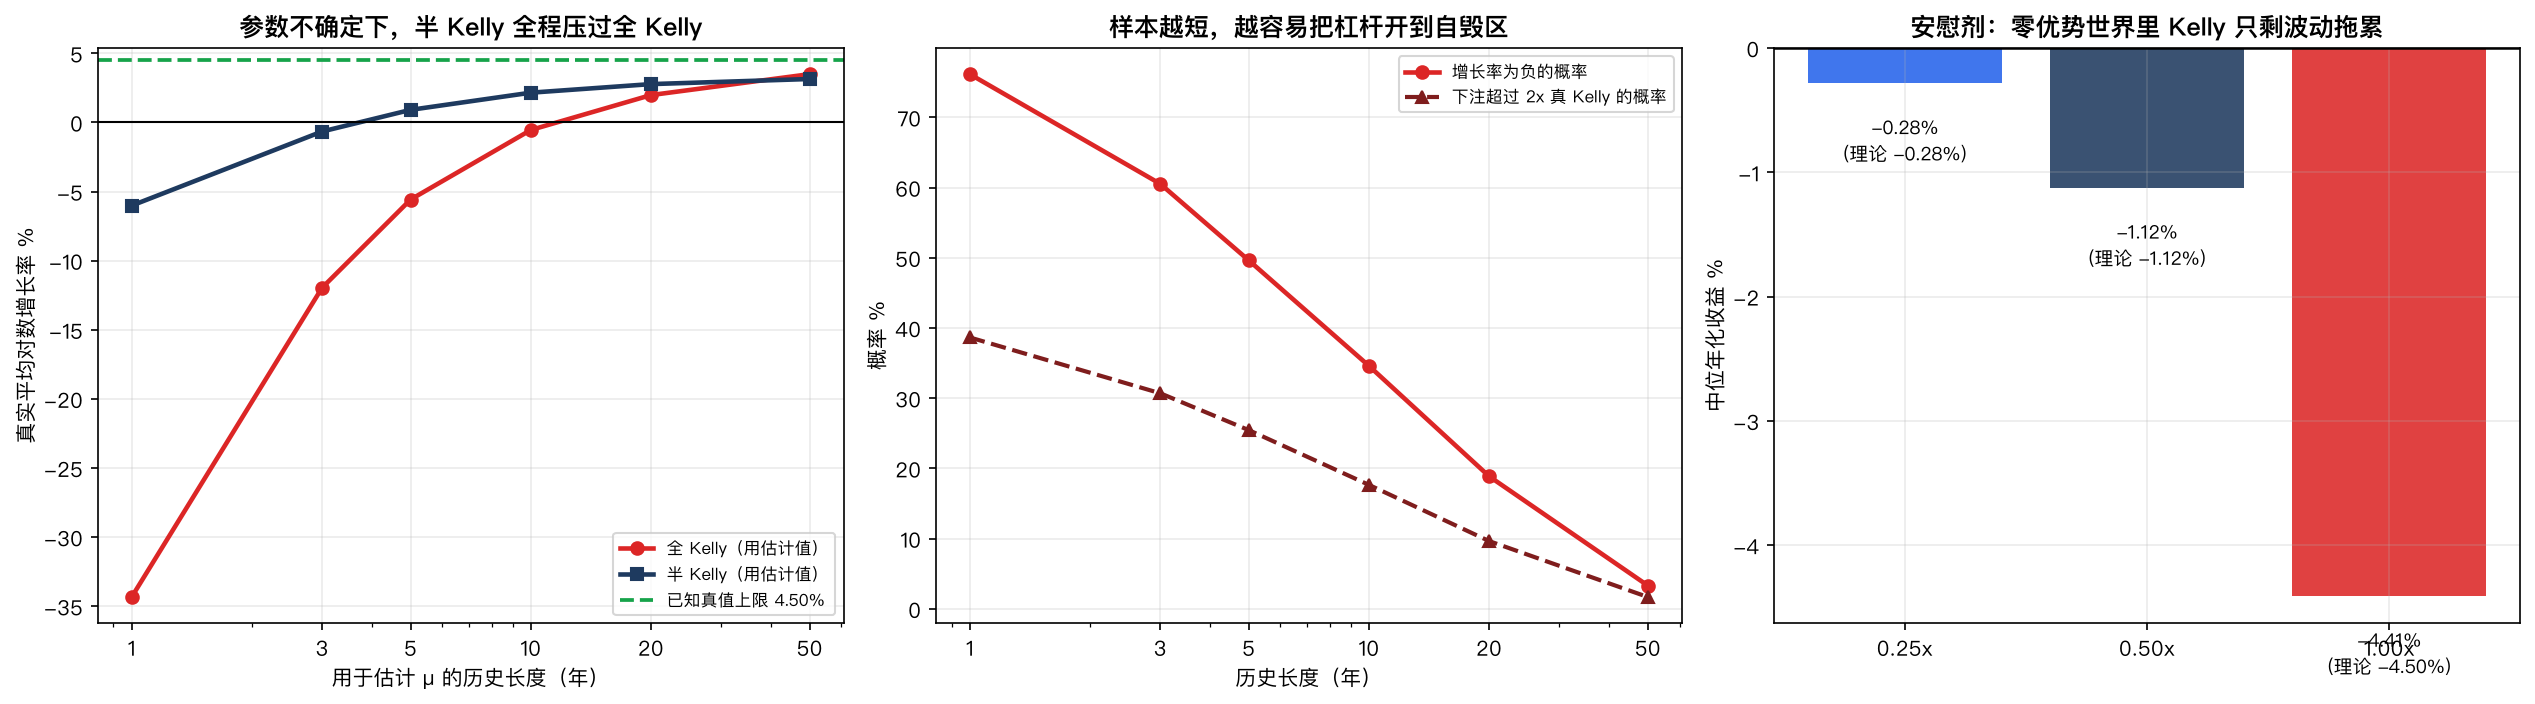
用估计出的 μ̂ 计算 f̂,然后用真值 μ 评估这个 f̂ 的真实增长率:
| 估计窗口 | SE(μ) | 全 Kelly 真实增长 | 半 Kelly 真实增长 | 增长为负概率 | 下注 >2x 真Kelly 概率 |
|---|---|---|---|---|---|
| 1 年 | 20.00% | −34.34% | −6.02% | 76.1% | 38.7% |
| 3 年 | 11.55% | −11.96% | −0.66% | 60.5% | 30.7% |
| 5 年 | 8.94% | −5.58% | +0.91% | 49.6% | 25.4% |
| 10 年 | 6.32% | −0.55% | +2.15% | 34.6% | 17.6% |
| 20 年 | 4.47% | +1.98% | +2.77% | 18.9% | 9.7% |
| 50 年 | 2.83% | +3.49% | +3.14% | 3.3% | 1.7% |
这张表是全文最重要的一张。
用 10 年历史数据估计参数、然后按全 Kelly 下注,平均真实增长率是 −0.55%。 你以为自己在执行最优策略,实际上在亏钱。而同样的估计误差下,半 Kelly 给出 +2.15%。
全 Kelly 要到 50 年数据才终于反超半 Kelly(3.49% vs 3.14%)。
原因在第二张图:估计窗口越短,把杠杆开到真 Kelly 两倍以上的概率越高——1 年数据时是 38.7%,10 年时仍有 17.6%。而我们在第一节已经看到,2x Kelly 的增长率精确等于 0,超过 2x 就是负的。
换句话说:用 10 年数据做全 Kelly,你有六分之一的概率把自己送进「数学上保证长期亏损」的区域。
半 Kelly 之所以稳健,不是因为它更保守,而是因为它把你的估计误差也减半了。它本质上是一种对参数不确定性的贝叶斯收缩。
第三张图是零优势安慰剂:把 μ 设为 0(真 Kelly 精确为 0),三档下注的实测中位 CAGR 是 −0.2826% / −1.1235% / −4.4073%,理论值是 −0.2812% / −1.1250% / −4.5000%。在一个完全没有优势的世界里,全 Kelly 每年精确亏掉 4.5% 的波动拖累,中位回撤 85.95%。
配套的零波动检验:σ→0 时中位 CAGR = 6.182898%,理论 6.183655%,偏差 7.57e-06。引擎在两个极端上都是准的。
四、跳跃:连续公式的盲区#
f* = μ/σ² 这个形式是连续时间下推导的,它隐含假设价格路径连续、没有跳空。
真实市场会跳。区分「厚尾」和「跳跃」很重要,因为它们的后果完全不同。
设计对照时必须小心一个陷阱:直接加一个负跳跃会同时降低期望收益,那样比较的就是两个不同优势的世界了。所以做期望补偿——把跳跃的无条件期望从漂移里减回去,让总期望收益与基准完全相同,只改变尾部形状:
if jump is not None:
    # 补偿跳跃:把跳跃的无条件期望从漂移中减回去,
    # 使总期望收益与基准一致 —— 只改尾部形状,不改优势
    p_j, size_j = jump
    hit = rng.random(n_paths) < p_j * dt
    r = r + hit * size_j - p_j * dt * size_j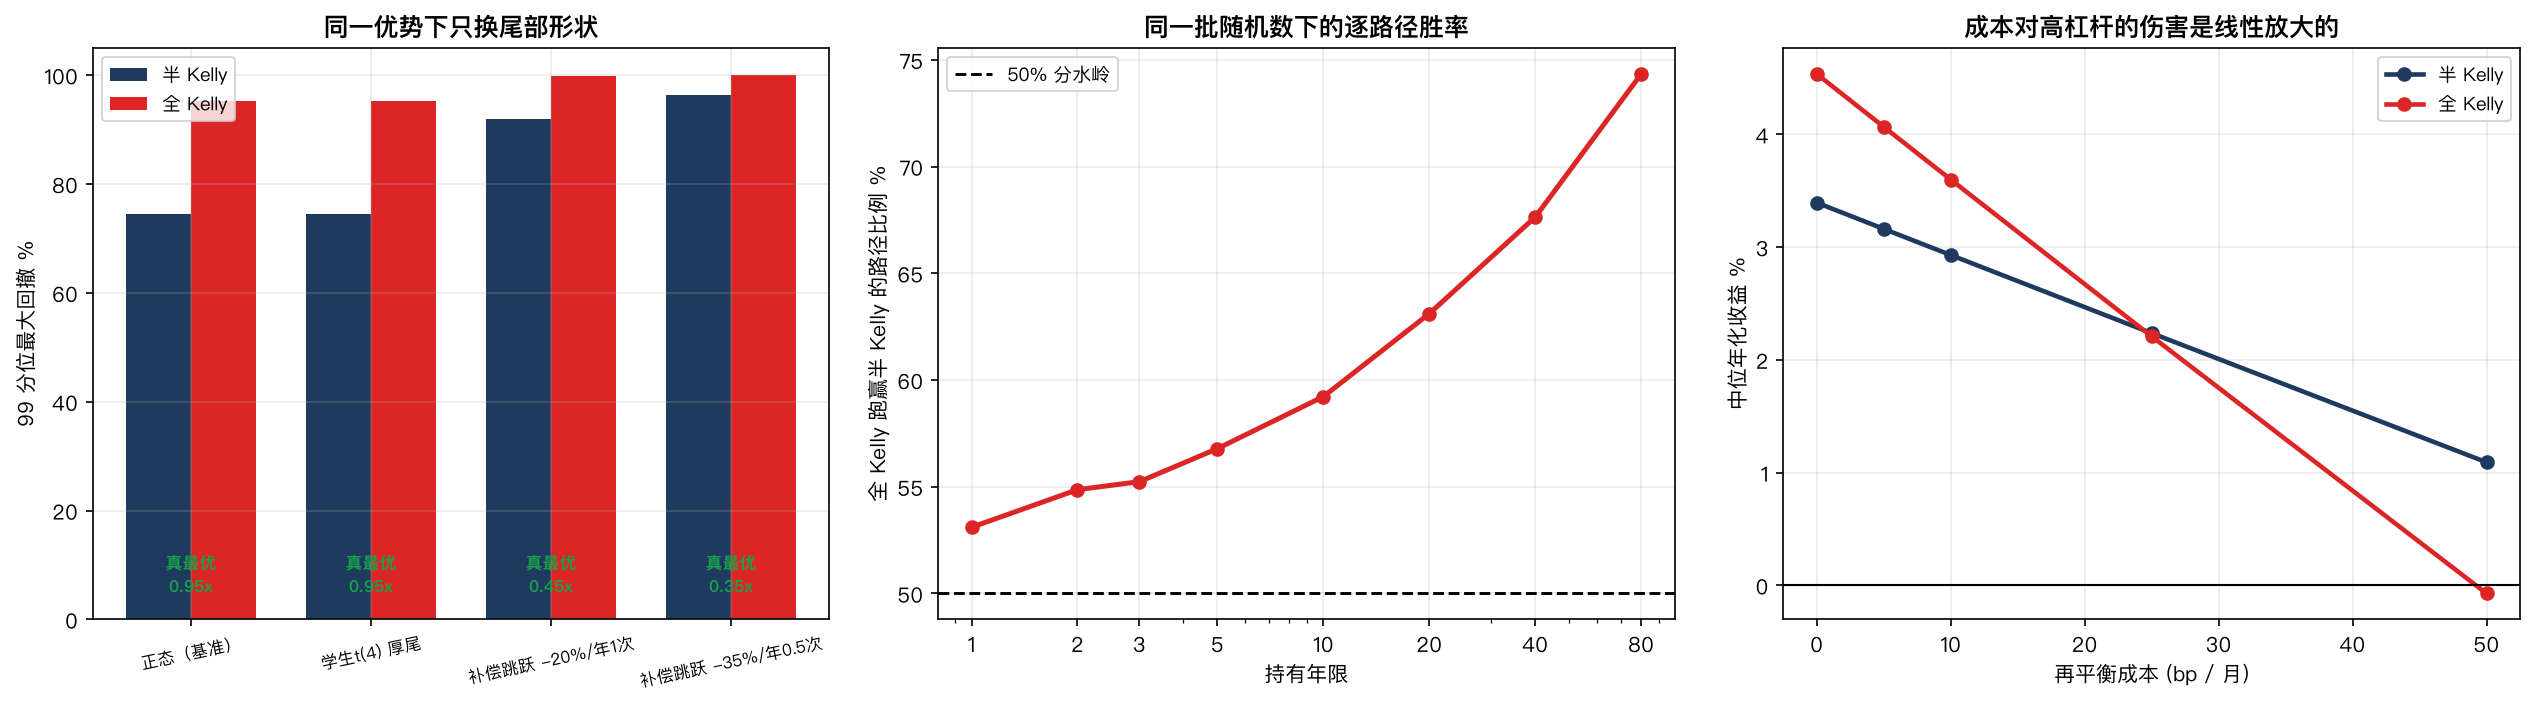
| 情形(优势相同) | 半 Kelly 中位 CAGR | 全 Kelly 中位 CAGR | 全 Kelly 出局率 | 数值搜索的真最优 |
|---|---|---|---|---|
| 正态(基准) | +3.37% | +4.48% | 2.28% | 0.95x |
| 学生 t(4) 厚尾 | +3.39% | +4.50% | 2.45% | 0.95x |
| 补偿跳跃 −20%/年1次 | +2.32% | −0.75% | 29.40% | 0.45x |
| 补偿跳跃 −35%/年0.5次 | +1.47% | −5.71% | 52.09% | 0.35x |
两个结论:
第一,厚尾几乎无影响。 学生 t(4) 的峰度远高于正态,但结果和基准几乎一模一样(真最优都是 0.95x)。因为日频厚尾在 252 天的复合中被中心极限效应抹平了。「收益不服从正态分布所以 Kelly 失效」这个常见说法,在日频复合的语境下基本站不住。
第二,跳跃是致命的。 同样的期望收益,加入一年一次的 −20% 跳空后,真实最优下注降到 0.45x,连续公式高估了 2.22 倍;−35% 跳空情形下真最优只有 0.35x,高估 2.86 倍。而此时全 Kelly 的中位收益已经翻负(−0.75%),出局率 29.4%。
这意味着:如果你的资产会跳空(个股、加密、新兴市场、任何有事件风险的东西),教科书 Kelly 给出的数字需要打对折甚至打三折——而这个折扣不是保守主义,是修正一个公式错误。
顺带说一句,即使在纯正态基准下,数值搜索出的真最优也是 0.95x 而非 1.00x。这 5% 的差距来自离散时间复合与连续时间近似的偏差。连续公式在任何离散执行的现实中都是略微高估的。
五、时间维度:全 Kelly 需要多久才「赢」#
支持全 Kelly 的最后一道防线是:「它长期一定赢,只要你活得够久。」
用同一批随机数逐路径对比:
| 持有年限 | 全 Kelly 跑赢半 Kelly 的比例 | 全 Kelly 中位财富 | 半 Kelly 中位财富 | 全 Kelly 中位回撤 |
|---|---|---|---|---|
| 1 年 | 53.1% | 1.05x | 1.03x | 26.5% |
| 5 年 | 56.8% | 1.26x | 1.19x | 48.4% |
| 10 年 | 59.2% | 1.57x | 1.40x | 59.8% |
| 20 年 | 63.1% | 2.45x | 1.96x | 70.3% |
| 40 年 | 67.6% | 6.06x | 3.86x | 80.0% |
| 80 年 | 74.3% | 35.35x | 14.66x | 87.5% |
20 年之后,全 Kelly 只有 63.1% 的概率跑赢半 Kelly。80 年之后也才 74.3%。
「长期一定赢」在数学上是对的(概率趋向 1),但收敛速度慢得离谱。而在这条极慢的收敛路上,你要一直忍受 70%–87% 的中位回撤。
没有人的投资生涯有 80 年。有 80 年资金久期的机构,也不会容忍 87% 的回撤。
成本让这个对比更糟。右图显示:月度再平衡成本 25bp 时,全 Kelly 的中位收益(2.21%)已经和半 Kelly(2.24%)持平;50bp 时全 Kelly 变负(−0.07%)而半 Kelly 还有 +1.09%。杠杆越高,同样的成本率吃掉的绝对收益越多——成本对高杠杆的伤害是线性放大的。
六、已知偏差#
第一,这是几何布朗运动 + 固定参数,不是历史回测。 真值由构造已知是这套方法论的核心优势(否则做不了零优势安慰剂),但也意味着没有 regime 切换、没有波动聚集、没有 μ 随时间漂移。真实世界里 μ 本身是不稳定的,这会让第三节的估计误差问题比这里展示的更严重,不是更轻。
第二,出局定义是「亏到只剩 10%」,这是个宽松的定义。 真实约束下,机构在回撤 30% 时就会面临大规模赎回,个人在回撤 50% 时基本会放弃策略。按现实约束算,全 Kelly 的「有效出局率」远高于 2.19%。
第三,没有建模融资成本和保证金追缴。 全 Kelly 对应 1.5x 杠杆,2x Kelly 对应 3x 杠杆。真实杠杆有融资利差(50–150bp),而且在回撤时经纪商会强制降杠杆——强制降杠杆恰好破坏了 Kelly 的「固定比例」前提,会把回撤永久化。这个效应在本文完全没有体现,它只会让高杠杆更糟。
第四,单一资产、单一优势。 多资产 Kelly 需要处理协方差矩阵的估计,而协方差矩阵的估计误差比均值更麻烦(维度诅咒)。多资产场景下分数 Kelly 的必要性只会更强。
七、实践 Checklist#
-
默认用 0.25x 到 0.5x Kelly。 半 Kelly 保留 75% 的理论增长率、砍掉 40% 的回撤;在 10 年参数估计误差下它的真实增长率(+2.15%)碾压全 Kelly(−0.55%)。
-
先算你的 μ 标准误,再算 Kelly。 SE = σ/√T。如果 SE 大于 μ 的一半(对应 T < 4σ²/μ²,本文设定下是 44 年),你就没有资格谈全 Kelly。
-
资产会跳空 → 再打对折。 −20%/年 的跳跃风险下真最优只有连续公式的 0.45 倍。个股、加密、新兴市场都属于这一类。厚尾不用怕,跳空要怕。
-
用中位数汇报,不要用均值。 全 Kelly 的均值/中位比是 2.48,均值完全被右尾主导,而你只能活在一条路径上。
-
把回撤当成硬约束而非软指标。 90% 的回撤在数学上可恢复,在现实中会通过赎回和心理崩溃变成永久损失——那一刻 Kelly 的前提就失效了。
-
成本高就再降。 月度 50bp 成本下,全 Kelly 的中位收益已经是负的,而半 Kelly 还有 +1.09%。
Kelly 公式没有错,它只是回答了一个和你的处境不同的问题:它假设你知道 μ、活得无限久、能承受任意回撤、且价格不跳空。 这四条假设你一条都不满足。
分数 Kelly 不是对最优解的妥协,它是在你真实的约束条件下重新求解之后得到的那个最优解。