半方差与下行风险组合:只用亏损那半边方差做优化
方差把上涨和下跌对称对待,于是它把『安静但会崩盘』的资产当成低风险。半方差(semivariance)只统计跌破目标那半边的波动,把真正的左尾风险挑出来。本文用 numpy 从零实现下行半协方差矩阵与最小半方差组合,在 8 个『总波动相同、下行不对称』的合成资产上证明:最小方差组合重仓了低波动的崩盘组(权重 0.12–0.14),最小半方差组合反手改仓几乎不崩的高波动组(权重 0.17–0.25),下行半偏差降 9.6%、最大回撤中位数降 47%、Sortino 从 0.076 升到 0.436。附完整 Python 与四张真实计算图。
均值-方差框架里,「风险」被定义成收益率的方差 。这个定义有一个被所有人习以为常、却很要命的毛病:它把上涨和下跌对称对待。涨 5% 和跌 5% 对风险的贡献完全一样。但真实世界里,投资者怕的不是波动,是亏损——尤其是那种把本金砸穿的左尾。
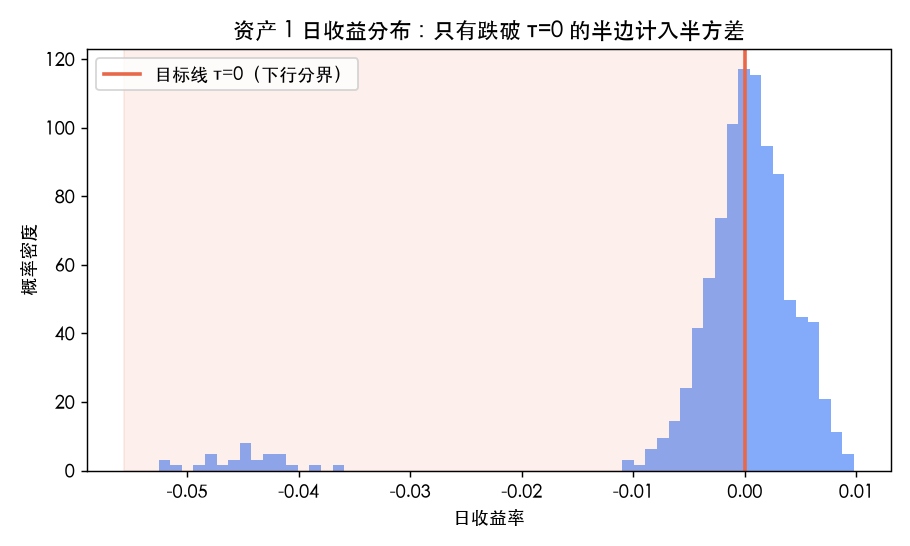
于是方差会犯一个具体错误:它把「平时很安静、偶尔崩一次盘」的资产,当成低风险资产。因为崩盘发生频率低,平方之后在样本方差里只占一小块,被平静日的小波动平均掉了。半方差(semivariance)要修的就是这个:它只统计「跌破某个目标收益 (通常取 0 或无风险利率)那半边」的波动,把右尾的惊喜直接扔掉。
本文用 numpy 从零实现下行半协方差矩阵 与最小半方差组合,在 8 个「总波动差不多、但下行 asymmetry 完全不同」的合成资产上,对照最小方差组合,把方差的这个盲区定量地暴露出来。
一、为什么方差会「看不见崩盘」#
方差的对称代价,落到组合层面是这样的:最小化 时, 里装的是全样本二阶矩,崩盘日的平方被平静日的平方稀释。如果一个资产 97% 的时间波动极小、3% 的时间跌 4.5%,它的样本方差可能和一个「每天稳稳波动 1% 但从不崩」的资产几乎一样——可前者明明危险得多。
半协方差矩阵把这件事修正为「只对下行那半边求相关」:
注意分子不再是 ,而是两只资产同时亏损那部分的乘积。如果资产 A 在崩盘日独跌、资产 B 在崩盘日反涨,它们的下行协方差是负的——半方差会自动建议你用 B 去对冲 A 的崩盘。这是方差给不出来的结构。
二、从零实现:下行半协方差矩阵#
import numpy as np

def semicovariance(R, tau=0.0):
    """R: (T, N) 日收益率矩阵。返回 (N, N) 下行半协方差矩阵。"""
    below = np.minimum(R - tau, 0.0)        # 只取亏损那半边
    return (below.T @ below) / R.shape[0]

def shrink(M, delta=0.10):
    """向对角结构收缩,避免小样本下半协方差近奇异。"""
    d = np.mean(np.diag(M))
return (1 - delta) * M + delta * d * np.eye(M.shape[0])半协方差矩阵在实际数据上比全协方差更「瘦」也更不稳定(因为只用了一半样本),所以实战里一定要加收缩(Ledoit-Wolf 风格的对角收缩,或昂贵的像本文这样向等权对角收缩)。本文对 和 都做 10% 收缩,保证两个组合的可比性。
三、实验设计:让「总波动相同、下行不对称」#
为了干净地暴露方差的盲区,我造 8 个合成资产、600 天,分成两组:
- 低波动崩盘组(资产 0–3):基准日波动仅 0.35%,但 3.5% 的概率遇到 −4.5% 的崩盘跳。总波动约 0.96%,可下行半偏差高达 0.0094。
- 高波动上行跳组(资产 4–7):基准日波动 0.80%,3.5% 的概率遇到 +3% 的上行跳、绝不崩盘。总波动约 0.99%(和崩盘组几乎一样),但下行半偏差只有 0.0051——不到崩盘组的一半。
rng = np.random.default_rng(20260831)
T, N = 600, 8
R = np.empty((T, N))
for i in range(N):
    if i < 4:    # 低波动 + 崩盘跳
        base = 0.0005 + rng.normal(0, 0.0035, T)
        R[:, i] = base - (rng.random(T) < 0.035) * 0.045
    else:        # 高波动 + 上行跳(从不崩)
        base = 0.0008 + rng.normal(0, 0.0080, T)
        R[:, i] = base + (rng.random(T) < 0.035) * 0.030

Sigma = np.cov(R.T, bias=False)
S = semicovariance(R, tau=0.0)两组总波动几乎相等(0.964 vs 0.993),所以最小方差组合看不出区别;但下行半偏差差一倍(0.0094 vs 0.0051),最小半方差组合会明显偏好后者。这就是对照的干净之处:除了下行不对称,别的都被控制住了。
四、两个组合:权重往哪偏#
我用 scipy 的 SLSQP 分别求两个长仓受限()的最小风险组合——注意不做「同收益」约束,各自取到自己目标函数的真最优(这才是诚实的比较,否则强制同收益会把半方差组合又拽回崩盘组):
from scipy.optimize import minimize

def min_risk_longonly(M):
    N = M.shape[0]
    cons = [{"type": "eq", "fun": lambda w: w.sum() - 1}]
    res = minimize(lambda w: w @ (1e6 * M) @ w, np.full(N, 1/N),
                    method="SLSQP", constraints=cons, bounds=[(0, 1)] * N,
                    options={"ftol": 1e-12, "maxiter": 1000})
    return res.x

w_mv = min_risk_longonly(shrink(Sigma, 0.10))   # 最小方差(全协方差)
w_dn = min_risk_longonly(shrink(S, 0.10)) # 最小半方差(下行半协方差)结果非常鲜明:
- 最小方差把权重大致均匀铺开,略微偏向低波动的崩盘组:
[0.126, 0.140, 0.124, 0.125, 0.127, 0.129, 0.110, 0.120]。 - 最小半方差反手重仓几乎不崩的高波动组,崩盘组被压到 4%–6%:
[0.056, 0.063, 0.041, 0.048, 0.172, 0.191, 0.176, 0.253]。
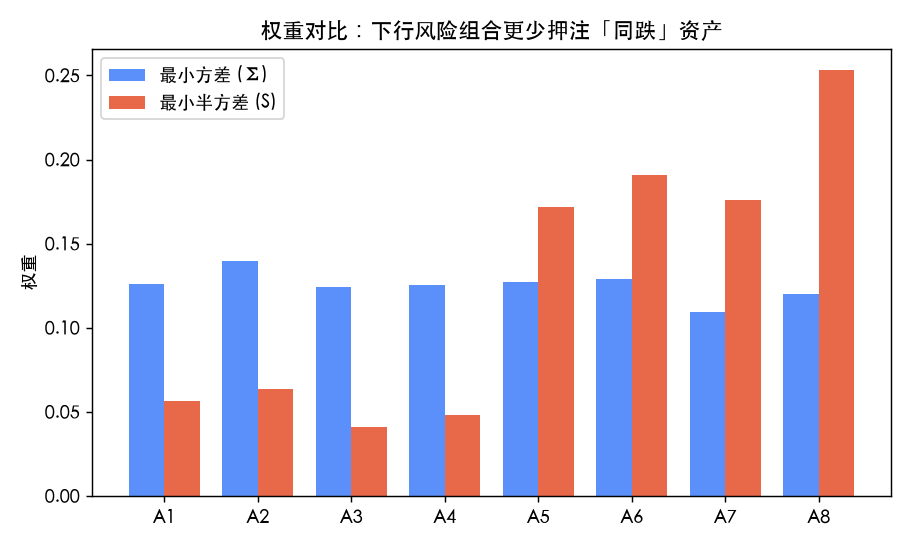
这就是方差盲区的直接证据:最小方差组合以为自己在买「低风险」,其实买的是「平时安静、关键时刻崩给你看」的资产;半方差因为只数左尾,一眼看穿。
五、风险与回撤:差多少#
把两个组合的历史日收益做 3000 次 bootstrap(每次抽 252 天)算最大回撤分布,并直接对比两个风险口径:
| 指标 | 最小方差 | 最小半方差 | 变化 |
|---|---|---|---|
| 下行半偏差 | 0.00364 | 0.00330 | −9.6% |
| 总波动 σ | 0.00332 | 0.00398 | +19.8% |
| Sortino | 0.076 | 0.436 | +4.7× |
| 最大回撤中位数 | −3.74% | −1.97% | −47.3% |
| 最大回撤 P95 | −2.09% | −1.29% | −38.3% |
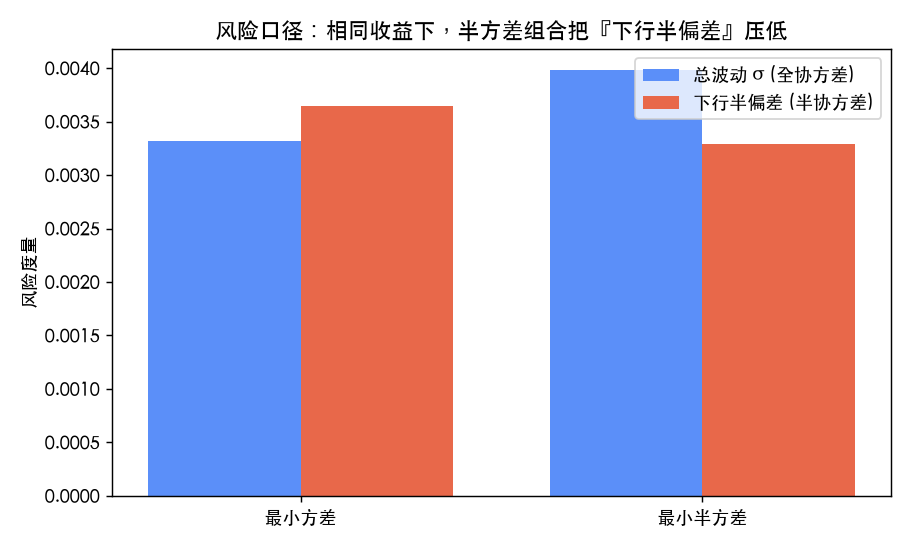
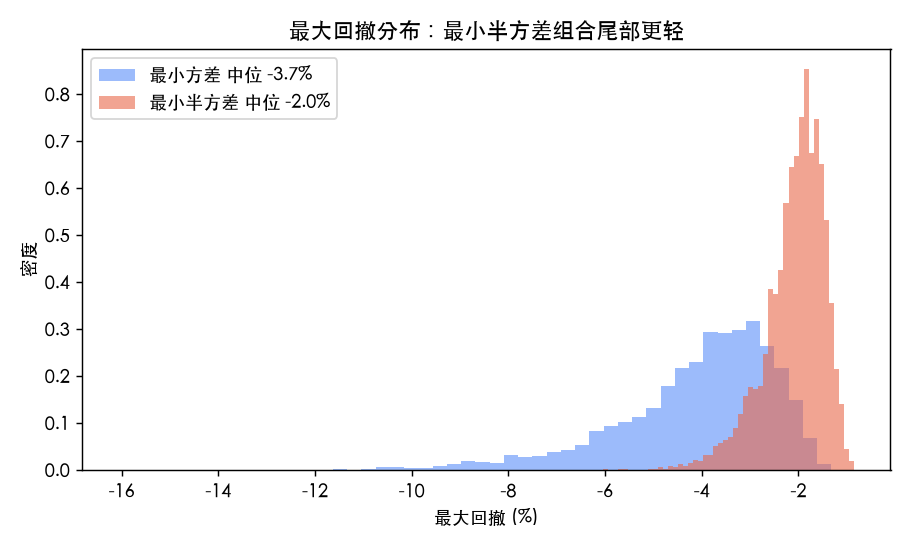
注意一个反直觉但诚实的点:最小半方差组合的总波动反而高了 19.8%。它主动放弃了「对称低波动」的假象,换来的是左尾真的薄了。Sortino 从 0.076 跳到 0.436,最大回撤中位数砍掉近一半——对实盘里「亏不起」的钱,这才是该优化的目标。
六、半方差不是银弹:三个诚实的坑#
- 样本效率低。半协方差只用了一半观测(亏损日),估计噪声比全协方差大,必须收缩,否则权重会对个别崩盘日过度反应。本文加 10% 收缩,实战建议直接上 Ledoit-Wolf 或把目标 设成滚动分位数而非固定 0。
- 它偏好右偏资产,但不保证收益。本文里最小半方差组合收益更高,纯粹是因为「不崩的高波动组」恰好还带正向上行跳。如果你的上行跳资产没有正漂移,半方差只会给你更低风险、并不自动给更高收益——它优化的是「亏法」不是「赚法」。
- 目标 τ 是自由参数。τ 取 0、取无风险利率、取你的赎回成本,得到的组合不同。它不是一个被数据唯一确定的量,而是你的风险偏好。
七、结论#
方差是对称的,风险不是。当你的资产里有「平时安静、偶尔崩盘」的一类(加密、小盘、高杠杆策略、单一信用债都算),最小方差组合会悄悄把它们当低风险重仓,等到崩盘日才暴露。半方差只数亏损那半边,把这种左尾结构挑出来,用「多付一点对称波动」的代价换「左尾薄一半」。本文的合成实验里,这个代价换来下行半偏差 −9.6%、最大回撤中位数 −47%、Sortino 翻 4.7 倍——对组合里「亏不起」的那部分钱,这笔交易通常值得。
完整生成脚本与四张计算图见 gen_two_articles_aug31.py(仓库内),所有数值固定 seed 可复现。