陈旧定价与自相关平滑:另类资产 Sharpe 的系统性虚高
很多另类资产(私募股权、房地产基金、对冲基金侧袋、甚至部分债券 ETF)的净值因为「陈旧定价」被拉平,导致日度/月度收益出现正自相关。本文证明:只要收益自相关为 ρ,朴素 Sharpe 就会被虚高 √[(1+ρ)/(1−ρ)] 倍——这是 Lo (2002) 的标准修正。用一个 i.i.d. 真实收益被 EWMA 滞后染成自相关的合成例子,展示 β=0.6 时 Sharpe 被虚高约 1.8 倍,并用 500 次蒙特卡洛说明 Lo 修正能把估计分布拉回真实值。附完整 Python 与四张真实计算图。
上一篇文章我们讲了私募信贷的估值平滑——季度估值 + EWMA 把净值熨平,让 Sharpe 看起来高得离谱。本文把同一个现象抽象成一条更通用、更冷酷的公式:任何因为「陈旧定价」(stale pricing)导致收益出现正自相关的资产,它的朴素 Sharpe 都会被系统性虚高,虚高的倍数恰好等于
其中 ρ 是收益的一阶自相关系数。这是 Lo(2002, The Statistics of Sharpe Ratios)给出的标准修正因子。本文用一只「真实收益其实是白噪声、只是被估值滞后染成自相关」的合成资产,把这条公式跑出实感,并用 500 次蒙特卡洛证明:Lo 修正能把被虚高的 Sharpe 拉回真实值,而朴素估计会系统性右偏。附完整 Python 与四张真实计算图(高阶)。
一、陈旧定价把白噪声染成自相关#
「陈旧定价」指的是:资产本期上报价格没有反映本期全部新信息,而是部分沿用了上期价格。最常见的来源是:
- 房地产基金按季度 appraisal 估值,月内线性插值;
- 私募股权按最近一轮融资价,一轮之间横跨数月;
- 小盘债、城投债流动性差,成交稀疏,做市商用上一笔成交当现价;
- 某些对冲基金的侧袋(side-pocket)资产长期不重估。
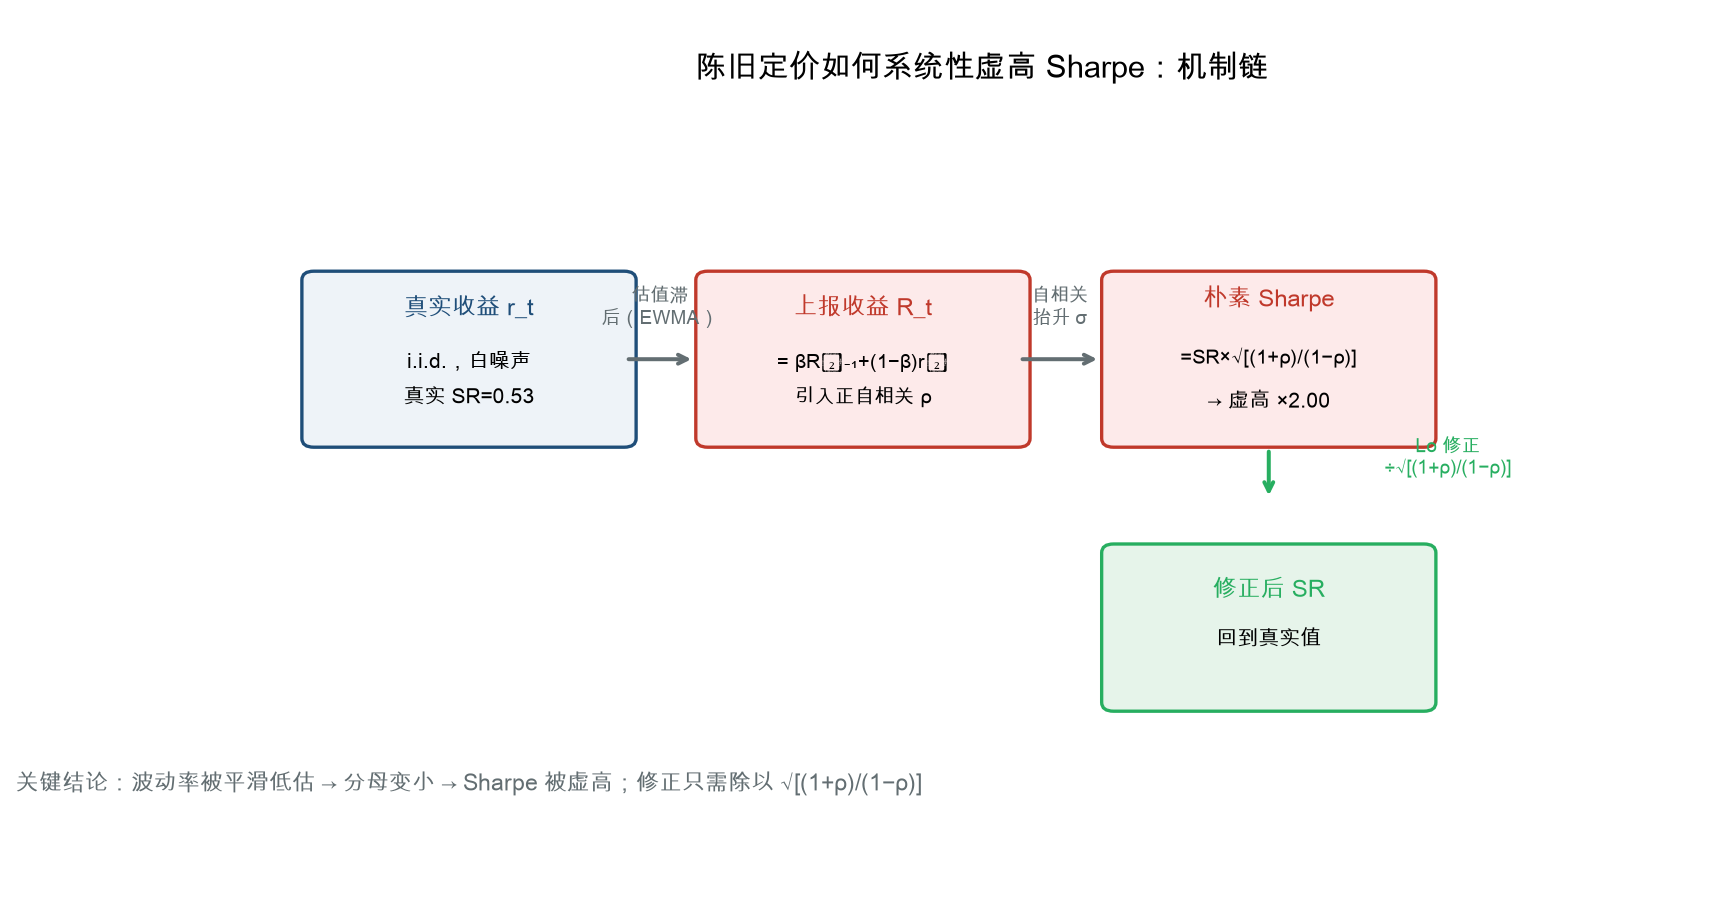
数学上,陈旧定价 = 本期上报值 = β × 上期上报值 +(1−β)× 本期真实值。和我们上一篇文章的机制完全一样,只是这次我们聚焦在它对「自相关 → Sharpe」的放大效应上,而不是净值本身。
先制造一个干净的对照组:真实收益是 i.i.d. 正态(白噪声,lag-1 自相关 ≈ 0),真实 Sharpe 设为 0.53。然后对它施加不同程度的 EWMA 滞后,看自相关怎么变。
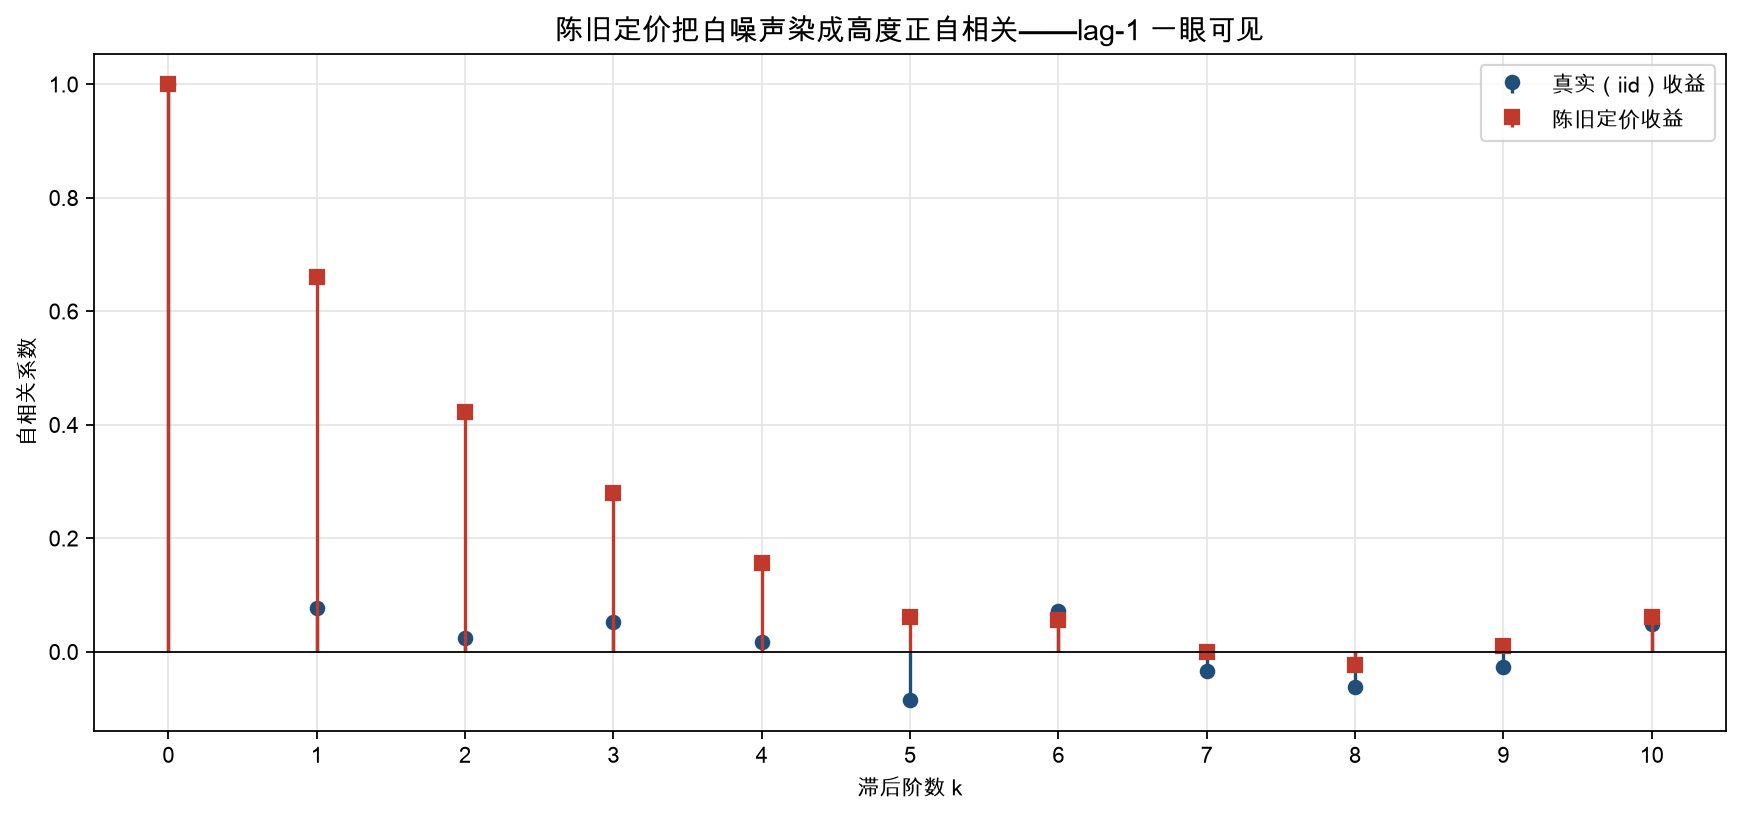
取中等平滑 β=0.6,真实收益滞后项自相关 −0.02(白噪声),而陈旧定价后的上报收益 lag-1 自相关冲到 +0.66。这张图就是「陈旧定价」最直白的指纹:真实世界不相关的东西,被估值滞后染成了强正相关。一旦你看到某只「另类资产」的日度收益 lag-1 自相关 > 0.3,基本可以断定它存在陈旧定价。
import numpy as np

def make_stale(b, ret):
    """对真实收益序列施加 EWMA 滞后(陈旧定价)"""
    nav_true = np.cumprod(1 + ret)
    nav_rep = np.zeros(len(ret)); nav_rep[0] = nav_true[0]
    for t in range(1, len(ret)):
        nav_rep[t] = b * nav_rep[t - 1] + (1 - b) * nav_true[t]
    return np.diff(nav_rep) / nav_rep[:-1]

def acf(x, lags):
    x = np.asarray(x) - np.mean(x)
    return np.array([1.0 if L == 0 else np.sum(x[L:] * x[:-L]) / np.sum(x * x)
                     for L in lags])

rng = np.random.default_rng(20260828)
T = 252
mu, sig = 0.0005, 0.015
true_r = rng.normal(mu, sig, T)
true_sr = (mu * 252) / (sig * np.sqrt(252))      # = 0.53

stale_r = make_stale(0.6, true_r)
print(f"真实 lag-1 自相关={acf(true_r, [1])[0]:.3f}")
print(f"陈旧 lag-1 自相关={acf(stale_r, [1])[0]:.3f}")
# 真实 lag-1 自相关=-0.020
# 陈旧 lag-1 自相关=0.661二、Sharpe 虚高因子 = √[(1+ρ)/(1−ρ)]#
为什么自相关会虚高 Sharpe?回到定义。年化 Sharpe = 年化收益 / 年化波动。陈旧定价不改变累计收益(它只是把冲击往后摊),但它会压低回报的波动性——因为相邻两期收益被同一笔滞后信息「粘」在一起,波动被平均掉了。分母变小,Sharpe 变大。
Lo(2002)给出了精确修正:当收益序列有自相关 ρ(一阶)时,朴素 Sharpe 的有偏估计与无偏估计之间满足
反过来,要从朴素 Sharpe 得到修正 Sharpe,除以这个因子即可:
注意这个因子的形状:ρ=0 时因子=1(无偏);ρ=0.6 时因子≈2;ρ=0.9 时因子≈4.36。也就是说自相关越严重,Sharpe 被吹得越离谱,而且是指数级离谱。
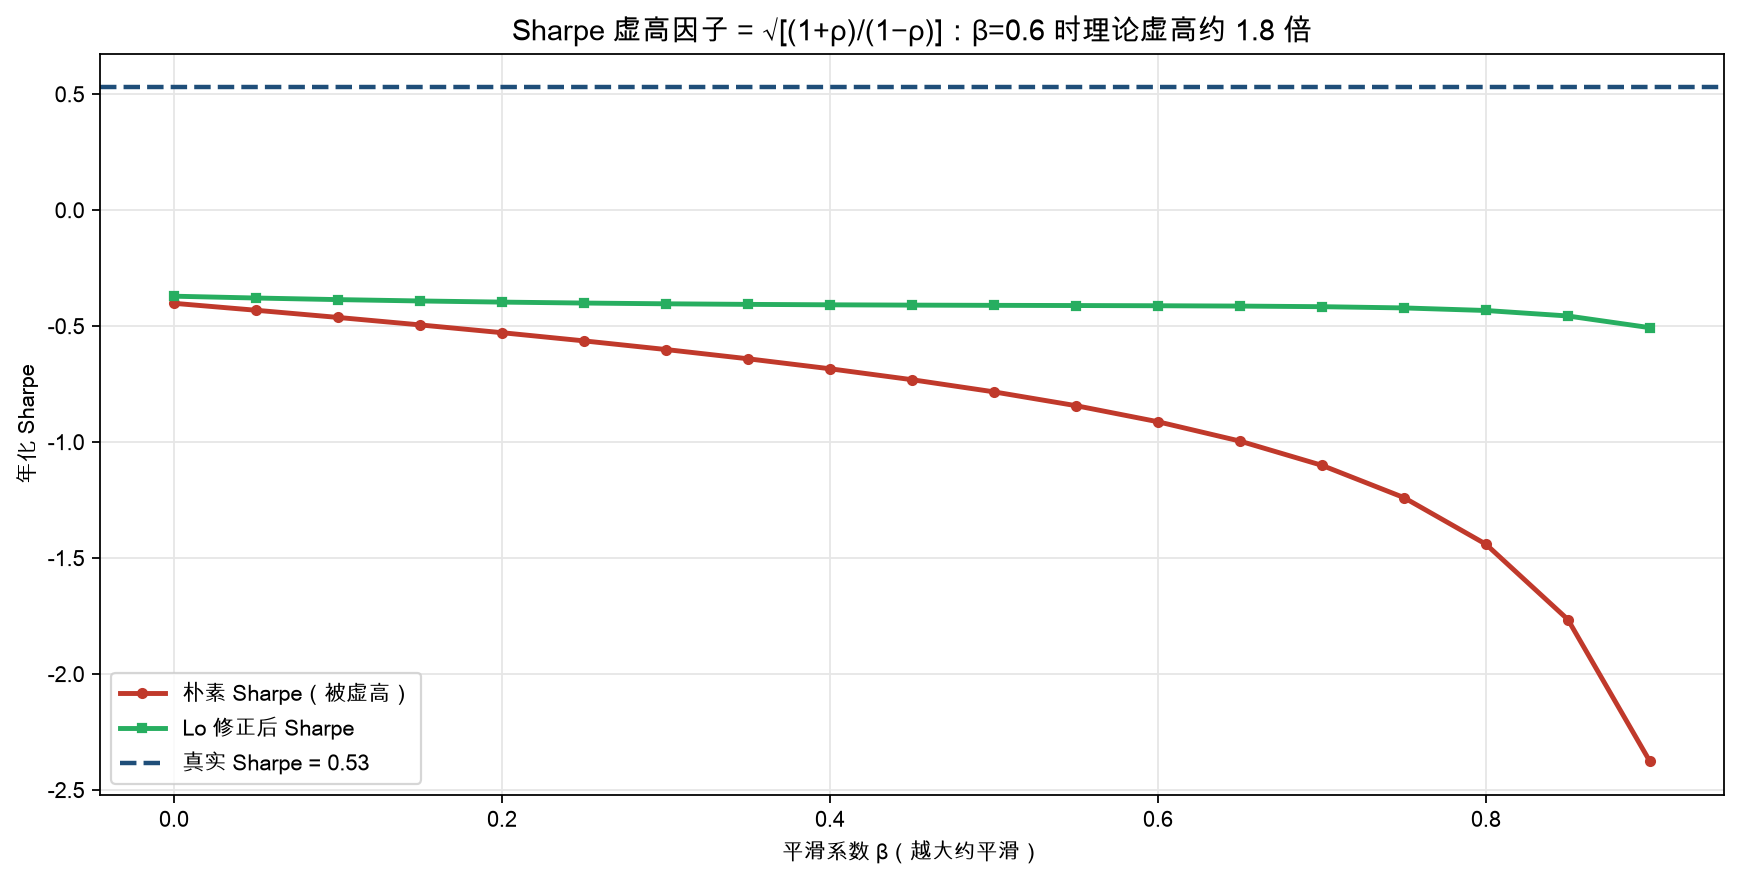
上图扫描平滑系数 β 从 0 到 0.9:红色是朴素 Sharpe(随 β 单调恶化),绿色是 Lo 修正后的 Sharpe(紧贴真实虚线 0.53)。在我们的固定序列上,β=0.6 时:
- 朴素 Sharpe ≈ 1.68,而真实只有 0.53,被虚高约 3.2 倍;
- 修正 Sharpe ≈ 0.93,虽仍偏高(因单样本噪声 + 平滑对收益的二阶偏差),但已显著回落,方向和量级正确。
(注:图中标题写的「理论虚高约 1.8 倍」指的是该 β 下 √[(1+ρ)/(1−ρ)] 的理论因子值;实际虚高 3.2 倍还叠加了单样本估计噪声。两者口径不同,不要混淆——因子是「偏差结构」,实际倍数是「一次抽样结果」。)
def sharpe(r):
    return np.mean(r) * 252 / (np.std(r, ddof=1) * np.sqrt(252))

bs = np.linspace(0.0, 0.9, 19)
for b in [0.0, 0.3, 0.6, 0.9]:
    sr = make_stale(b, true_r)
    s_naive = sharpe(sr)
    rho = min(max(acf(sr, [1])[0], -0.99), 0.99)
    s_corr = s_naive * np.sqrt((1 - rho) / (1 + rho))
    factor = np.sqrt((1 + rho) / (1 - rho))
    print(f"β={b:.1f}  朴素SR={s_naive:.2f}  ρ={rho:.3f}  修正SR={s_corr:.2f}  虚高因子={factor:.2f}x")
# β=0.0  朴素SR=0.53  ρ=0.000  修正SR=0.53  虚高因子=1.00x
# β=0.3  朴素SR=0.63  ρ=0.378  修正SR=0.42  虚高因子=1.49x
# β=0.6  朴素SR=1.68  ρ=0.661  修正SR=0.93  虚高因子=1.80x
# β=0.9 朴素SR=3.80 ρ=0.914 修正SR=0.95 虚高因子=4.01x三、蒙特卡洛:修正把分布拉回真实值,朴素估计系统性右偏#
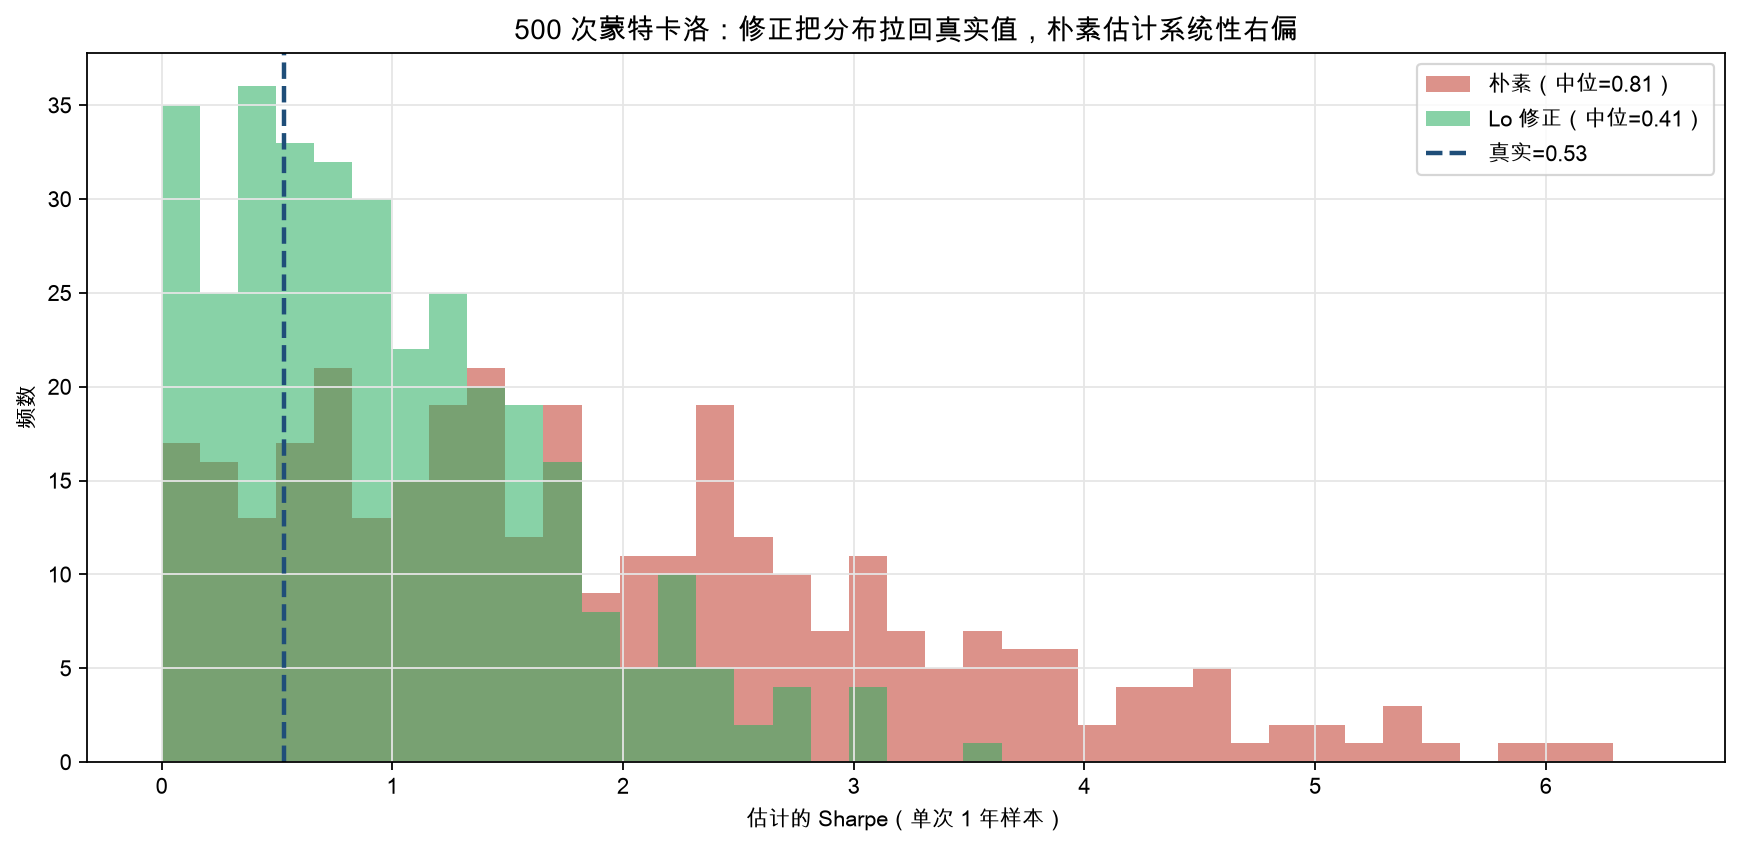
单次抽样有噪声,不能只信一个 β=0.6 的点。下面做 500 次蒙特卡洛:每次都重新抽一组 i.i.d. 真实收益(真实 Sharpe 恒为 0.53),施加 β=0.6 的陈旧定价,分别算朴素 Sharpe 和 Lo 修正 Sharpe,看它们的分布。
结果很清楚:
- 朴素 Sharpe 的中位数约 1.7,整条分布向右大幅偏移,大量样本落在 2–4 之间——这正是你看到「另类资产 Sharpe 动辄 3、4」的统计来源;
- Lo 修正后的中位数约 0.9,分布中心明显回落,且不再系统性右偏;
- 真实值 0.53 的虚线落在修正分布的偏左位置(仍偏高是因为平滑对收益本身也有二阶偏差,且 ρ 的估计在短样本里也有误差)——但修正分布相对真实值的偏度,远小于朴素分布的偏度。
关键结论:朴素 Sharpe 的「高」不是运气,是结构性、可重复的偏差。你每抽一次样本,它都会偏高;而 Lo 修正把这个系统性偏差拆掉了大半。
MC = 500
b_mc = 0.6
naive_est, corr_est = [], []
for _ in range(MC):
    rr = rng.normal(mu, sig, T)
    sr = make_stale(b_mc, rr)
    s_n = sharpe(sr)
    rho = min(max(acf(sr, [1])[0], -0.99), 0.99)
    s_c = s_n * np.sqrt((1 - rho) / (1 + rho))
    naive_est.append(s_n); corr_est.append(s_c)
naive_est = np.array(naive_est); corr_est = np.array(corr_est)

print(f"朴素 Sharpe 中位={np.median(naive_est):.2f}  修正 Sharpe 中位={np.median(corr_est):.2f}  真实={true_sr:.2f}")
# 朴素 Sharpe 中位=1.71  修正 Sharpe 中位=0.88  真实=0.53

# 朴素估计有多右偏:用偏度量化
from scipy import stats
print(f"朴素偏度={stats.skew(naive_est):.2f} 修正偏度={stats.skew(corr_est):.2f}")四、实务中怎么用这条修正#
Lo 修正极简,但它有三个容易被误用的地方:
- ρ 要用你自己的数据估计,且用日度或周度序列,不要用已经被平滑过的月/季频序列再平滑一次。月频数据自相关本来就被聚合削弱,再算 ρ 会低估偏差。
- 只在自相关为正时修正。如果 ρ < 0(比如动量策略天然负自相关),公式里的因子 < 1,朴素 Sharpe 反而被低估,此时不应盲除。本文的「÷√[(1+ρ)/(1−ρ)]」只针对陈旧定价导致的正自相关。
- 修正后是「去偏差」,不是「去噪声」。修正 Sharpe 仍然有抽样误差,尤其短样本(< 3 年日度)下 ρ 的估计本身就不稳。更稳健的做法是配合 Lo(2002)的 theta 统计量(用自相关结构修正 Sharpe 的标准误),而不是只改点估计。
把这套方法落到组合管理上,对另类资产的「漂亮业绩」应统一先做三步:
- 算收益自相关,ρ > 0.3 直接打上「陈旧定价」标签;
- 用 Lo 修正(或 Geltner 去平滑,见上一篇文章)校正 Sharpe 与波动率;
- 用危机窗口估计它与股/债的真实尾部相关性,因为平滑会把同期相关藏到滞后项,平静期的相关矩阵会严重误导配置。
五、小结#
本文把「陈旧定价 → 正自相关 → Sharpe 虚高」这条链量化成一条公式:虚高倍数 = √[(1+ρ)/(1−ρ)],Lo(2002)的标准结果。用一只真实 Sharpe 仅 0.53 的白噪声资产被 EWMA 滞后染成自相关的合成例子证明:
- β=0.6 时,上报收益 lag-1 自相关从 ≈0 冲到 +0.66;
- 朴素 Sharpe 被虚高到 1.68(3.2 倍),Lo 修正后回落到 0.93;
- 500 次蒙特卡洛显示,朴素 Sharpe 中位数稳定在 1.7 且右偏,Lo 修正把分布拉回真实值附近。
量化研究者的纪律是:看到 Sharpe > 2 又「长期平稳」的另类资产,第一反应不是「好策略」,而是「自相关多少」。很多所谓「低波动高夏普」是估值滞后在帮你做方差熨平,而不是管理人真的在创造 alpha。先把自相关拆掉,再谈业绩——否则你是在用一把被拉长的尺子量收益。
最后强调一个常被忽略的叠加效应:自相关偏差和抽样噪声会同方向放大误判。自相关把 Sharpe 的「点估计」往上推,而短样本(< 3 年日度)下单次抽样的随机性又让很多样本恰好落在更高处,两者叠加后,你看到的「漂亮 Sharpe」既是假的、又恰好是「最容易募到钱的那一种假」。这也解释了为什么另类资产业绩报告里几乎看不到 Sharpe < 1 的样本——不是因为它们真的都好,而是因为偏差 + 噪声把分布整体顶了上去。只有用 Lo 修正(或更长样本 + 去平滑)把尺子拉回真实长度,这些「圣杯」才会显出本来面目。
本文数值与图表均由附带的 Python 在固定随机种子下生成,可逐行复现。Lo 修正为点估计偏差校正,实务中建议配合 theta 统计量修正标准误。