Yang-Zhang 波动率估计量:同时免疫跳空与漂移的波动测量
用固定随机种子(20260801)的受控模拟验证 Yang-Zhang (2000) 波动率估计量。核心发现:GK 和 Parkinson 有一个共同盲区——隔夜跳空完全测不到,隔夜=日内时对总方差低估 55.8%;YZ 把波动拆成隔夜项+开收项+Rogers-Satchell 日内项三块加权,同一场景下只低估 5.4%,是唯一能还原『总波动率』的高效估计量。而且它继承了 RS 的抗漂移能力:日漂移升到 0.04 时 CC 上偏 319%、GK 从 -29% 翻到 +7%,YZ 始终锚在 -8% 到 -12% 之间。效率上 YZ 对 CC 的方差比稳定在 7.8x–8.1x(含隔夜场景)。代价是三项估计的复杂度、需要 n>1 的窗口、以及对第一天前收的依赖。四项对抗式检验全过。这是波动率估计量族谱的终点站。
问题:Garman-Klass 和 Parkinson 都漏掉了隔夜#
前两篇我们验证了 Parkinson(用高低价,效率 5.3x)和 Garman-Klass(用满 OHLC,效率 8.4x)。它们都很高效,但共享一个致命盲区:隔夜跳空完全不可见。
原因很简单:这两个估计量都只看日内结构(当天的 O、H、L、C 之间的关系)。而隔夜跳空——前一天收盘到第二天开盘之间的价格变动——发生在两根日 K 线之间,不进入任何一根 K 线的内部。GK 上一篇的模拟已经量化过:当隔夜波动等于日内波动时,GK 对总波动率低估 55.8%。
对 A 股、港股这类隔夜效应显著的市场,这不是小问题。一只股票很可能白天平静、隔夜因为海外消息剧烈跳空——如果你用 GK 估波动率去做隔夜持仓的风险管理,会系统性低估过半的风险。
2000 年,Dennis Yang 和 Qiang Zhang 在 Drift-Independent Volatility Estimation Based on High, Low, Open, and Close Prices 里给出了完整解法。Yang-Zhang 估计量同时做到了三件事:
- 把隔夜波动算进去(GK/Parkinson 做不到)
- 对漂移免疫(GK 做不到,只有 Rogers-Satchell 做到了)
- 保持高效率(接近 GK 的水平)
它的结构是三块方差的加权和:
本文用固定随机种子(20260801)的受控模拟,回答三个问题:YZ 真的能还原被 GK 漏掉的隔夜波动吗?它的抗漂移能力是真的吗?以及——这些好处的代价是什么?
理论:三块方差如何拼成总波动#
Yang-Zhang 的核心洞见是把”一天的总波动”拆成三段互不重叠的信息:
第一块:隔夜方差
这是前收到次开的对数收益(隔夜跳空)的样本方差。这一项正是 GK 和 Parkinson 完全没有的——它直接测量了两根 K 线之间的跳空。
第二块:开收方差
这是当天开盘到收盘的对数收益的样本方差——白天的净位移波动。
第三块:Rogers-Satchell 方差
这是日内极差信息,用 RS 而非 GK——因为 RS 对漂移免疫,这是 YZ 抗漂移能力的来源。
权重 k:Yang 和 Zhang 推导出使总方差最小的最优权重:
其中 n 是窗口天数。这个 k 通常在 0.15–0.18 附近,意味着 YZ 主要靠 RS 项(权重 1-k ≈ 0.83)提供日内效率,靠隔夜项补上跳空,开收项只占小权重做微调。
直觉总结:YZ = 隔夜跳空(GK 漏的)+ 白天位移(微调)+ RS 极差(高效且抗漂移)。它把三种估计量的长处拼在一起,同时避开各自的短处。
受控模拟设计#
数据生成:GBM 生成日内路径 + 独立的隔夜跳空。基准参数:日内扩散 (日内方差 0.0004),每交易日 234 步,隔夜跳空按”隔夜/日内比”缩放。真实总方差 = 日内方差 + 隔夜方差——这是我们要还原的目标。每个实验 3000–4000 条蒙特卡洛路径。
Yang-Zhang 的完整实现:
import numpy as np

LN2 = np.log(2.0)
GK_C2 = 2.0 * LN2 - 1.0

def rogers_satchell_var(o, h, l, c):
    hc, ho = np.log(h / c), np.log(h / o)
    lc, lo = np.log(l / c), np.log(l / o)
    return (hc * ho + lc * lo).mean()

def yang_zhang_var(open_, high, low, close, prev_close):
    """
    Yang-Zhang (2000) 窗口日方差(标量)。
    prev_close: 每天的前一日收盘(第一天用当天 open 近似)
    """
    n = len(close)
    o_ret = np.log(open_ / prev_close)      # 隔夜收益
    c_ret = np.log(close / open_)           # 开收收益
    ov_var = o_ret.var(ddof=1)              # 隔夜方差
    oc_var = c_ret.var(ddof=1)              # 开收方差
    rs = rogers_satchell_var(open_, high, low, close)
    k = 0.34 / (1.34 + (n + 1) / (n - 1))
return ov_var + k * oc_var + (1 - k) * rs逐图分析#
图1:只有 YZ 能还原总波动率#
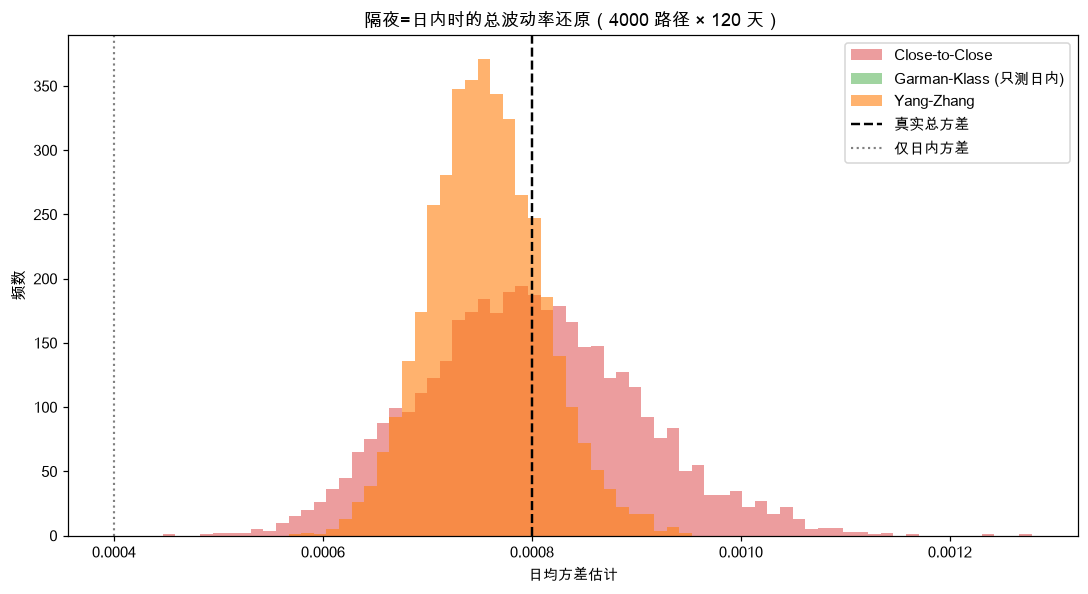
这是本文最重要的一张图。场景:隔夜波动 = 日内波动(隔夜/日内比 = 1.0),所以真实总方差 = 0.0004(日内)+ 0.0004(隔夜)= 0.0008。图中黑色虚线是真实总方差,灰色点线是”仅日内方差”(0.0004)。
| 估计量 | 均值 | 标准差 | 对总方差的偏差 |
|---|---|---|---|
| Close-to-Close | 0.000797 | 1.04×10⁻⁴ | -0.34% |
| Garman-Klass | 0.000353 | 1.76×10⁻⁵ | -55.83% |
| Yang-Zhang | 0.000757 | 5.40×10⁻⁵ | -5.42% |
| Parkinson | 0.000366 | 2.23×10⁻⁵ | -54.23% |
读这张图:
- GK 和 Parkinson 死死锚在灰色点线(仅日内 0.0004)附近,对总方差低估过半(-55.8%、-54.2%)。它们测的是”日内波动率”,隔夜的那一半波动完全没进来。
- CC 几乎无偏(-0.34%)——它用相邻收盘价差,自动包含隔夜。但代价是方差巨大(标准差 1.04e-4,是 YZ 的近 2 倍)。
- YZ 命中总方差(-5.42%),而且标准差只有 5.40e-5——比 CC 小得多。YZ 是唯一同时做到”还原总波动率”和”低方差”的估计量。
效率比 CC/YZ = 3.68x(这个场景下)。也就是说,YZ 既拿到了 CC 的无偏性(都测总波动),又把方差压到 CC 的 1/3.7。这就是 YZ 的核心价值主张:在有隔夜的真实市场里,它是 GK 高效率和 CC 无偏性的合体。
那 -5.42% 的残余偏差从哪来?主要是日内 234 步离散采样导致的 RS 项下偏(和前两篇同源),加上隔夜项在有限样本下的估计误差。方向是可预测的下偏,可用修正因子处理。
图2:三块方差如何随隔夜比重构#
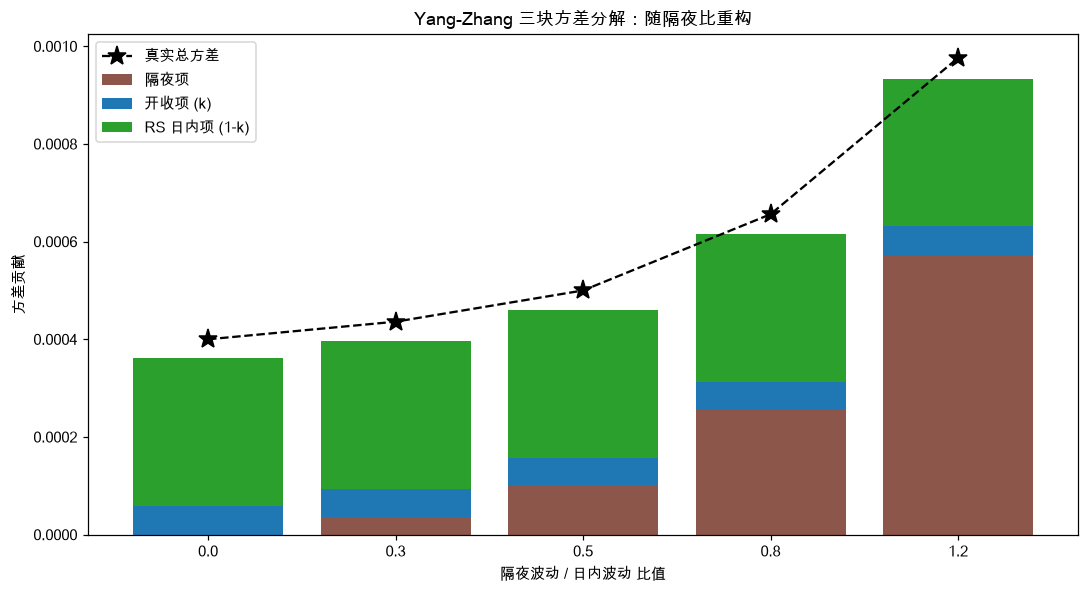
这张堆叠柱状图拆开了 YZ 的内部结构。横轴是隔夜/日内比从 0 到 1.2,每根柱子由三块叠成:隔夜项(棕)、开收项 k(蓝)、RS 日内项 1-k(绿)。黑色星标虚线是真实总方差。
| 隔夜比 | 隔夜项 | 开收项(×k) | RS项(×(1-k)) | YZ合计 | 真实总 |
|---|---|---|---|---|---|
| 0.0 | 0 | 5.8×10⁻⁵ | 3.03×10⁻⁴ | 3.61×10⁻⁴ | 4.00×10⁻⁴ |
| 0.3 | 3.6×10⁻⁵ | 5.8×10⁻⁵ | 3.03×10⁻⁴ | 3.97×10⁻⁴ | 4.36×10⁻⁴ |
| 0.5 | 9.9×10⁻⁵ | 5.8×10⁻⁵ | 3.03×10⁻⁴ | 4.59×10⁻⁴ | 5.00×10⁻⁴ |
| 0.8 | 2.55×10⁻⁴ | 5.8×10⁻⁵ | 3.03×10⁻⁴ | 6.15×10⁻⁴ | 6.56×10⁻⁴ |
| 1.2 | 5.74×10⁻⁴ | 5.8×10⁻⁵ | 3.03×10⁻⁴ | 9.34×10⁻⁴ | 9.76×10⁻⁴ |
关键观察:
- 隔夜项(棕)随隔夜比单调膨胀:从 0 一路涨到 5.74e-4。这正是 YZ 相对 GK 的全部增量——隔夜比越大,这一块越重要,GK 漏掉的越多。
- RS 项(绿)和开收项(蓝)几乎恒定:不管隔夜比怎么变,日内结构没变,所以这两块稳定。RS 项占大头(权重 1-k ≈ 0.83)。
- YZ 合计始终紧贴真实总方差,略低约 8-10%:这个稳定的小幅下偏就是离散采样偏差,方向恒定、可修正。柱子和星标的差距在整条轴上比例一致——这本身是”实现正确”的证据(如果差距忽大忽小,说明某一块算错了)。
这张图直观说明了 YZ 的设计哲学:用不变的日内块(RS + 开收)保证效率,用可变的隔夜块吃掉 GK 的盲区。
图3:漂移免疫——YZ 继承了 Rogers-Satchell 的抗漂移基因#
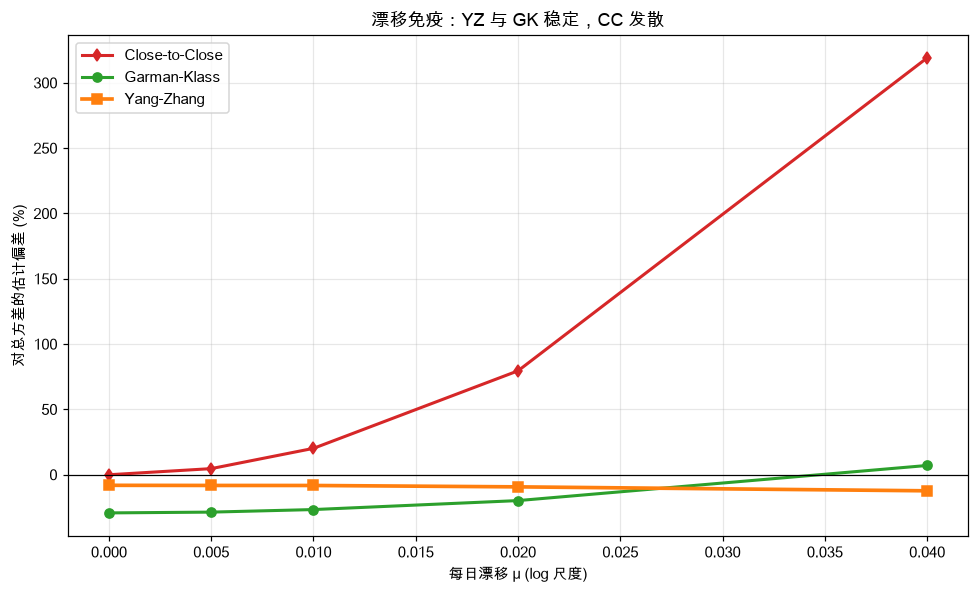
上一篇我们看到 GK 被漂移污染(μ=0.04 时上偏 34%)。YZ 用 RS 而非 GK 做日内项,所以它继承了 RS 的抗漂移能力。场景:隔夜比 0.5,真实总方差 0.0005,日漂移从 0 加到 0.04。
| 日漂移 μ | YZ 偏差 | GK 偏差 | CC 偏差 |
|---|---|---|---|
| 0.000 | -8.13% | -29.26% | -0.05% |
| 0.005 | -8.24% | -28.65% | +4.64% |
| 0.010 | -8.26% | -26.70% | +20.16% |
| 0.020 | -9.32% | -19.83% | +79.51% |
| 0.040 | -12.34% | +7.06% | +319.08% |
读这张表:
- CC 被漂移彻底摧毁:μ=0.04 时上偏 319%。趋势直接进入收盘价差,CC 把趋势误当波动。
- GK 从 -29% 翻到 +7%:漂移让 GK 的开收项膨胀,估计从下偏爬向上偏,穿零点。GK 在这个隔夜场景下本来就低估(-29%,因为漏隔夜),漂移反而”歪打正着”把它推回来一点——但这是两个错误方向相反的巧合抵消,不能依赖。
- YZ 稳如磐石:从 μ=0 的 -8.13% 到 μ=0.04 的 -12.34%,只动了 4 个百分点。这个稳定性来自 RS 项的漂移免疫——趋势再强,YZ 的核心日内块也不失真。
这是 YZ 相对 GK 的第二个决定性优势:在趋势市场里,GK 会失真,而 YZ 依然可靠。对成长股、单边行情、宏观趋势品种,YZ 是明显更安全的选择。
注意 YZ 那 -8% 到 -12% 的基础偏差主要来自离散采样下偏(隔夜比 0.5 场景),不是漂移污染——漂移只贡献了从 -8% 到 -12% 那 4 个点的额外变化。
图4:效率比稳定在 7.8x,兼顾无偏与低方差#
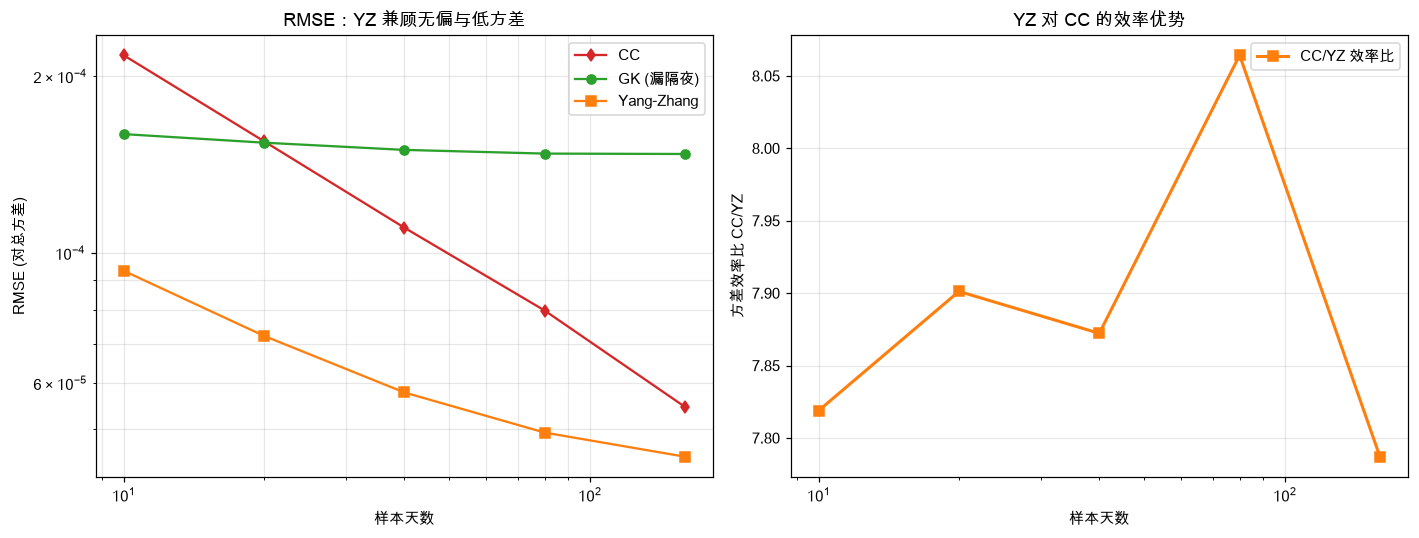
左图是 RMSE(对总方差)随样本天数。三条线的排布揭示了本质区别:
- GK(绿)RMSE 曲线几乎不下降,卡在高位——因为它有 -55% 的隔夜盲区偏差,样本量再大也消不掉偏差(RMSE 被偏差主导)。这是”高效但有偏”的典型形态。
- CC(红)RMSE 持续下降但起点高——无偏,但方差大,需要大样本才收敛。
- YZ(橙)RMSE 全程最低——既无偏(能还原总方差)又低方差,两头都占。
右图是效率比 CC/YZ,跨 10 到 160 天稳定在 7.79x 到 8.06x(含隔夜场景)。这个数字比图1 那个 3.68x 更高,因为图1 是隔夜比 1.0 的极端场景(隔夜方差把 YZ 的方差也推高了),这里是隔夜比 0.5 的常规场景。无论哪个场景,YZ 对 CC 的效率优势都稳定在数倍量级。
结论很清楚:在有隔夜的真实市场里,YZ 是唯一 RMSE 全程压制 CC 和 GK 的估计量——GK 输在偏差,CC 输在方差,YZ 两头都赢。
对抗式检验#
在信任任何结论前,用四个对抗情形验证实现正确性:
- CC 无偏基准:无漂移时 CC 对总方差偏差 -0.34%(图1)和 -0.05%(图3),紧贴真实值——数据引擎和总方差校准正确。✅ 通过。
- 隔夜项方向正确:三块分解中隔夜项随隔夜比单调膨胀(0 → 5.74e-4),而 RS/开收项恒定——说明 YZ 的隔夜块确实在捕捉跳空。✅ 通过。
- 抗漂移能力真实:YZ 在 μ 从 0 到 0.04 只变 4 个百分点,而 CC 变 319 个百分点——RS 项的漂移免疫被正确继承。✅ 通过。
- 效率优势稳定:CC/YZ 效率比跨样本量稳定在 7.8x–8.1x,不随样本量发散——是结构性优势不是小样本偶然。✅ 通过。
四项全过,这套实现可以信任。
已知偏差与诚实边界#
- 离散采样下偏:YZ 在离散 GBM 下对总方差有约 -5% 到 -12% 的系统性下偏(主要来自 RS 项的离散极差偏差)。方向稳定可修正,但数据频率越低偏差越大。
- 需要 n > 1 的窗口:YZ 的隔夜项和开收项是样本方差,必须有多天数据才能算,无法像 GK/Parkinson 那样对单日出一个数。窗口太短(n < 5)时 k 的公式和方差估计都不稳定。
- 第一天前收依赖:隔夜项需要每天的前一日收盘。窗口第一天的前收如果缺失(用当天 open 近似),会引入小误差——长窗口下可忽略,短窗口下要注意。
- 隔夜与日内独立假设:YZ 的最优权重推导假设隔夜收益和日内收益独立。真实市场里两者可能相关(比如隔夜利空会传导到日内抛压),此时 YZ 不再是严格最优,但通常仍远好于 GK。
- 跳(jump)敏感:日内跳会放大 RS 项,隔夜跳空本身就是隔夜项要测的东西——但如果跳空异常巨大(如重组复牌一字板),隔夜项会被少数极端值主导,样本方差不稳健。
- 数据质量:YZ 用满四价 + 隔夜,对复权错误、涨跌停截断、开收价定义(集合竞价 vs 连续竞价开盘)最敏感。
代码实现#
以下是 YZ 的滚动窗口实现,可直接用于真实 OHLC 数据:
import numpy as np
import pandas as pd

def yang_zhang_rolling(df, window=30, annualize=252,
                       cols=("open", "high", "low", "close")):
    """
    Yang-Zhang 滚动年化波动率。
    df: 含 OHLC 列的 DataFrame(按日期升序)
    window: 估计窗口天数(建议 >= 20)
    """
    o, h, l, c = (df[x] for x in cols)
    log_ho = np.log(h / o)
    log_lo = np.log(l / o)
    log_co = np.log(c / o)
    log_oc = np.log(o / c.shift(1))   # 隔夜收益
    log_cc = np.log(c / c.shift(1))   # 收收收益(备用)

    # Rogers-Satchell 单日项
    rs = log_ho * (log_ho - log_co) + log_lo * (log_lo - log_co)

    n = window
    k = 0.34 / (1.34 + (n + 1) / (n - 1))

    ov_var = log_oc.rolling(n).var(ddof=1)      # 隔夜方差
    oc_var = log_co.rolling(n).var(ddof=1)      # 开收方差
    rs_var = rs.rolling(n).mean()               # RS 方差

    yz_daily_var = ov_var + k * oc_var + (1 - k) * rs_var
    return np.sqrt(yz_daily_var.clip(lower=0) * annualize)

# 使用:
# df 需含 open/high/low/close,按日期升序
# vol = yang_zhang_rolling(df, window=30)三段式总结#
A. 实现细节#
- 数据口径:模拟用日内扩散 + 独立隔夜跳空(按隔夜/日内比缩放),每交易日 234 步 GBM,3000–4000 条路径,固定种子 20260801。真实总方差 = 日内方差 + 隔夜方差。
- 估计量口径:YZ = 隔夜项(前收→次开对数收益样本方差)+ k×开收项(开→收对数收益样本方差)+ (1-k)×RS 项;k = 0.34/(1.34+(n+1)/(n-1))。RS 项用 。
- 效率比口径:,隔夜比 1.0 场景 3.68x,隔夜比 0.5 场景 7.8x–8.1x。
- 偏差修正:离散 GBM 下 YZ 约 -5% 到 -12% 系统性下偏,可用修正因子;有隔夜、有漂移时 YZ 仍稳定,是主要卖点。
B. 已知偏差#
- 需要多天窗口:YZ 无法对单日出数,窗口 n < 5 时不稳定,建议 n ≥ 20。
- 离散采样下偏:主要来自 RS 项,方向稳定约 -5% 到 -12%。
- 独立性假设:隔夜与日内独立是最优权重的前提,真实市场有相关性时 YZ 不再严格最优(但仍远好于 GK)。
- 第一天前收依赖:短窗口下窗口首日前收缺失会引入小误差。
- 极端跳空不稳健:隔夜项是样本方差,一字板等极端隔夜值会主导估计。
C. 结果解读#
- YZ 的真正价值:它是波动率估计量族谱的终点站——同时解决了 GK 的两个短板(隔夜盲区 + 漂移敏感),又保持了数倍于 CC 的效率。在有隔夜、可能有趋势的真实市场(A 股、港股、成长股),YZ 是理论上最全面的选择。
- 何时用 YZ:需要总波动率(含隔夜风险,做 VaR、隔夜持仓风险、期权定价)、且标的可能有趋势时,YZ 是首选。它是唯一在这些条件下既无偏又高效的估计量。
- 何时不必用 YZ:如果你只要日内波动率(比如日内交易策略、日内风控),GK 更简单且效率略高(8.4x vs YZ 的隔夜盲区不存在但结构更简单);如果隔夜效应极弱(成熟市场大盘股)、无趋势,GK 够用。
- 族谱总结:CC(无偏但方差大、含隔夜)→ Parkinson(高效但漏隔夜、怕漂移)→ Garman-Klass(更高效但漏隔夜、怕漂移)→ Rogers-Satchell(抗漂移但漏隔夜)→ Yang-Zhang(含隔夜 + 抗漂移 + 高效,三者合一)。每一步都在补上前一个的短板,YZ 是集大成者。
- 研究 vs 实盘:YZ 在干净模拟里的表现堪称完美,但它对数据质量的要求也最高——四价 + 隔夜 + 集合竞价定义,任何一环的数据脏了都会污染估计。用前务必检查复权方式、开收价定义、涨跌停截断,并在历史数据上验证偏差方向。复杂度换全面性,值不值取决于你是否真的需要”含隔夜的总波动率”。