波动率的波动率因子:一个测不准的风险溢价
vol-of-vol 在论文里是漂亮因子,拆到估计层却发现你测的东西 95.5% 是噪声。400 只股票、10 年、真实 ξ 已知的受控模拟:常规做法(21 日 RV + 63 日滚动标准差)与真实 vov 相关仅 0.212、水平高估 92.0%、回归斜率 0.027。噪声有解析形式:log(RV_w) 估计误差方差约 1/(2w),21 日窗口下比信号大 72 倍。两个改动把相关提到 0.676:换无重叠窗口(0.212→0.449)、RV 窗口拉到 63 日。溢价是真的——上帝视角按真实 ξ 排序价差 3.22%(t=1.99)与理论 3.00% 吻合,但最优可观测估计量只抓到 40.8%(t=0.77)。窗口敏感性是警告:t 值在 0.05–1.97 间漂移,且估计质量最好的配置不是 t 值最高的配置——这就是过拟合的具体形态。15 个种子里 6 次符号翻转。持续性对比最有诊断价值:vov 排名前后半期相关仅 0.115、高组留存 27.5%,普通波动率则是 0.958 和 73.8%。
问题:一个理论上很硬、实证上很软的因子#
波动率的波动率(vol-of-vol,下文简称 vov)在理论上站得很稳。随机波动率模型里它是一个显式参数——Heston 模型的 ξ、SABR 的 ν——描述的是「波动率本身有多不稳定」。一个 vov 高的资产,你连它未来的风险水平都估不准,这是二阶不确定性。厌恶这种不确定性的投资者应该愿意为规避它付费,于是高 vov 资产应该有更低的预期收益。
实证文献里这个因子的表现比理论弱得多。有的研究找到显著的负溢价,有的找不到,有的换个估计窗口结论就反了。常见的解释是「样本期不同」或者「市场结构变化」。
本文提出一个更朴素的可能:这个因子的实证结果不稳定,可能主要是因为你根本测不准它。
为了把「溢价不存在」和「溢价存在但测不出来」这两件事分开,我做了一个真实 vov 参数完全已知的受控模拟。真实数据里做不到这一点——你只能比较两个估计量,永远不知道谁更接近真相。
模拟设计:溢价是我亲手放进去的#
- 400 只股票,2520 个交易日(10 年)
- 每只股票的对数波动率服从 OU 过程,vol-of-vol 参数 ξ_i 从 U(0.10, 0.75) 抽取,横截面均值 0.409
- 市场层同样有自己的随机波动率
- 预期收益里显式植入 vov 溢价:年化漂移 = −λ·ξ_i,λ = 0.06
def gen_panel(rng, N, T, mkt_r, lam=0.06):
    xi = rng.uniform(0.10, 0.75, N)          # 真实 vol-of-vol,这是要被估计的目标
    beta = rng.uniform(0.6, 1.4, N)
    base_vol = rng.uniform(0.012, 0.028, N)

    logv = np.zeros((T, N)); logv[0] = np.log(base_vol)
    kappa, theta, dt = 0.02, np.log(base_vol), np.sqrt(1/252)
    shocks = rng.normal(0, 1, (T, N))
    for t in range(1, T):
        logv[t] = logv[t-1] + kappa*(theta - logv[t-1]) + xi*dt*shocks[t]
    vol = np.exp(logv)

    drift = -lam * xi / 252.0                # 溢价:高 vov -> 低预期收益
    r = beta[None,:]*mkt_r[:,None] + rng.normal(0,1,(T,N))*vol + drift[None,:]
return r, vol, xi, beta, base_vol关键设计是 ξ 和 base_vol 独立抽取,横截面相关只有 0.024。这意味着在这个世界里 vov 和 vol 是两个正交的属性,任何「高 vov 组顺手也是高 vol 组」的现象都只能来自估计误差,不能来自真实结构。
溢价的理论量级:λ×(ξ的Q5−Q1跨度) = 0.06 × 0.50 = 3.00% 年化。这是上限,任何估计量最多抓到这么多。
结果一:常规估计量几乎捂不住真实 vol-of-vol#
最常见的 vov 估计流程是两步:先算滚动已实现波动,再算它的滚动标准差。
def realized_vol(r, w=21):
    c = np.cumsum(np.vstack([np.zeros(r.shape[1]), r**2]), axis=0)
    out = np.full(r.shape, np.nan)
    out[w-1:] = np.sqrt((c[w:] - c[:-w]) / w)
    return out

def rolling_std_of_logvol(rv, w=63):
    """vov 代理:log 已实现波动的一阶差分的滚动标准差,年化"""
    lv = np.log(rv)
    out = np.full(lv.shape, np.nan)
    for t in range(w, len(lv)):
        seg = lv[t-w+1:t+1]
        out[t] = np.std(np.diff(seg, axis=0), axis=0) * np.sqrt(252)
return out21 日已实现波动 + 63 日滚动窗口,是文献里的常见配置。结果:
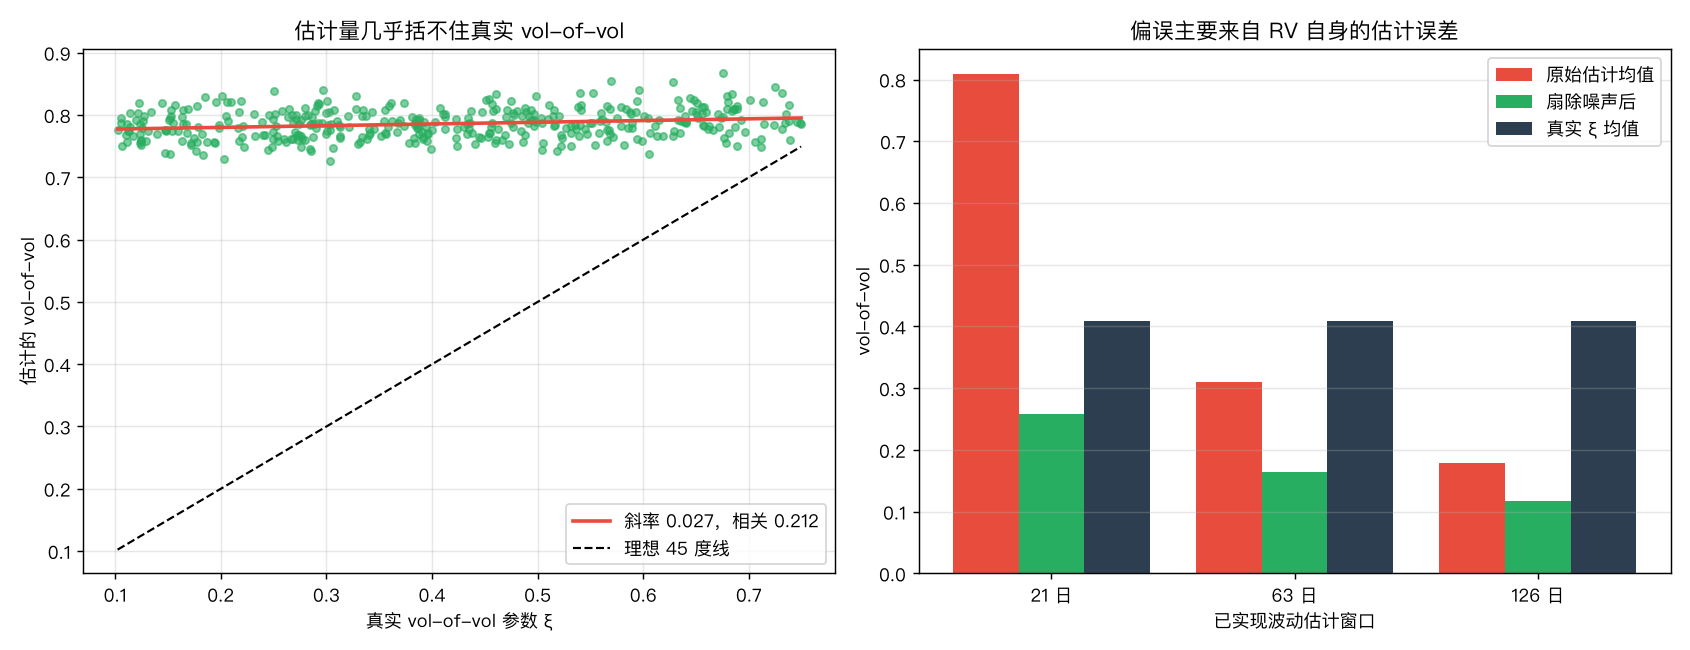
| 指标 | 数值 |
|---|---|
| 与真实 ξ 的横截面相关 | 0.212 |
| 回归斜率 | 0.027 |
| 估计均值 | 0.786 |
| 真实均值 | 0.409 |
| 水平偏误 | +92.0% |
| 信号占方差比 | 4.49% |
斜率 0.027 这个数字值得停一下。 它的意思是:真实 vov 从 0.10 涨到 0.75(跨度 0.65),估计值平均只涨 0.018。而估计值本身的横截面标准差是 0.024。也就是说,整个真实 ξ 的变化范围投影到估计量上,产生的变异还不如噪声的一个标准差大。
方差分解更直白:估计量总方差里只有 4.49% 来自真实信号,95.5% 是噪声。
这不是「因子弱」,这是「你手上这个变量和你想测的东西基本无关」。任何用它做的排序,五分之四以上的分组决策是掷骰子。
结果二:噪声来自哪里,以及怎么砍掉一大半#
好消息是这个噪声不神秘,它有解析形式。
已实现波动本身是个估计量。在对数尺度下,用 w 个观测算出的 log(RV_w) 的估计误差方差约为 1/(2w)。当你对 log(RV) 做一阶差分再求标准差时,两期的估计误差都进去了:
var(Δ log RV) ≈ var(真实波动率变动) + 2 × 1/(2w)21 日窗口下噪声项是 2×(1/42) = 0.0476。而真实的日频对数波动率变动方差是 ξ²/252 ≈ 0.409²/252 = 0.00066。噪声比信号大 72 倍。
这解释了 +92% 的水平高估——你测的几乎全是 RV 自身的抖动,不是波动率真的在抖。
两个改动可以大幅改善:
改动一:用无重叠窗口。 滚动窗口里相邻两天的 RV 共享 20 天数据,人为制造了平滑,同时让差分序列带上虚假的自相关结构。
def vov_nonoverlap(r_mat, w_rv=21):
    """无重叠分块:每 w_rv 天算一个 RV,再对块间差分求标准差"""
    T, N = r_mat.shape
    nb = T // w_rv
    rv = np.sqrt((r_mat[:nb*w_rv]**2).reshape(nb, w_rv, N).mean(axis=1))
    lv = np.log(rv)
return np.std(np.diff(lv, axis=0), axis=0) * np.sqrt(252/w_rv)改动二:把 RV 窗口拉长。 噪声项 1/(2w) 随窗口线性衰减。
| RV 窗口 | 块数 | 原始估计均值 | 与真实 ξ 相关 | 扣噪声后均值 | 扣噪声后相关 |
|---|---|---|---|---|---|
| 21 日 | 120 | 0.809 | 0.449 | 0.259 | 0.450 |
| 63 日 | 40 | 0.310 | 0.676 | 0.165 | 0.684 |
| 126 日 | 20 | 0.179 | 0.670 | 0.117 | 0.679 |
| (真实 ξ 均值) | — | — | — | 0.409 | — |
两点结论:
- 仅仅换成无重叠窗口,相关系数就从 0.212 跳到 0.449。 重叠窗口不只是「效率略低」,它主动损害了横截面区分能力。
- RV 窗口 21→63 日,相关系数再从 0.449 提到 0.676。 但 126 日不再改善(0.670)——此时块数只剩 20 个,差分序列只有 19 个点,采样误差接管。
最优配置在 63 日无重叠,相关系数 0.676。 这比常规做法的 0.212 好了三倍多,代价是 10 年数据只能给出 40 个观测块。
那个「扣噪声」的修正(从方差里减去 1/(2w) 再开方)能把水平偏误压下去——21 日从 0.809 修到 0.259,但真实值是 0.409,从高估 98% 变成低估 37%。它对横截面相关几乎没有改善(0.449→0.450),因为它扣的是一个对所有股票相同的常数,不改变排序。这是一个容易踩的坑:水平校准和横截面区分度是两件事,修好前者不代表后者变好。
结果三:溢价是真的,但只抓得到 40.8%#
现在把估计量放进因子测试。因为真实 ξ 和 base_vol 正交,我用波动率中性分组(先按 RV 分 5 组,组内再按 vov 分 5 组)来排除任何残余的波动率污染。
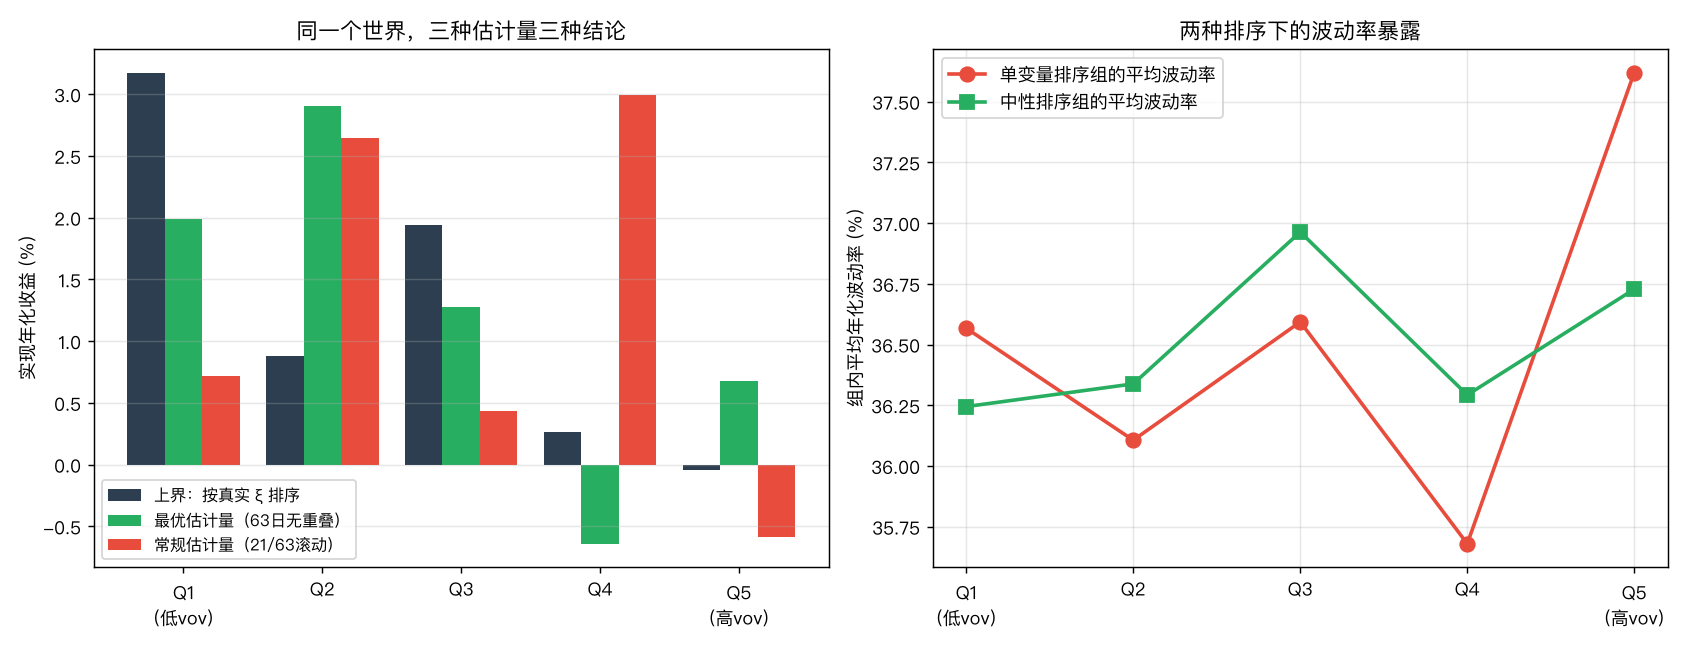
| 分组 | 上帝视角(按真实 ξ) | 最优估计量(63 日无重叠) | 常规估计量(21/63 滚动) |
|---|---|---|---|
| Q1(低 vov) | 3.18% | 1.99% | 0.72% |
| Q2 | 0.88% | 2.91% | 2.65% |
| Q3 | 1.94% | 1.28% | 0.43% |
| Q4 | 0.26% | −0.64% | 2.99% |
| Q5(高 vov) | −0.05% | 0.67% | −0.58% |
| Q1−Q5 价差 | 3.22% | 1.31% | 1.30% |
| t 值 | 1.99 | 0.77 | 0.87 |
上帝视角的 3.22% 与理论值 3.00% 吻合(t=1.99),说明溢价确实被正确植入了,引擎没问题。 注意即便在上帝视角下 t 值也只是勉强够 2——400 只股票、10 年,一个 3% 的年化横截面价差本来就在统计功效的边缘。
可观测估计量只抓到 40.8%(1.31%/3.22%),t 值 0.77,不显著。
为什么损失这么大?看各组捕获的真实 ξ 跨度:
| 排序方式 | Q5−Q1 的真实 ξ 跨度 | 占上帝视角比例 |
|---|---|---|
| 上帝视角 | 0.500 | 100% |
| 最优估计量 | 0.338 | 67.6% |
| 常规估计量 | 0.108 | 21.6% |
常规估计量的排序只拉开了真实 ξ 跨度的五分之一——你以为在比较「vov 最高的 20%」和「vov 最低的 20%」,实际比较的是两组 vov 相差不到四分之一个理论跨度的股票。 收益价差自然被稀释。
有意思的是最优估计量捕获了 67.6% 的 ξ 跨度,却只换回 40.8% 的收益价差。差额来自分组内部:单只股票的实现收益方差远大于 3% 的预期收益差,80 只股票一组的标准误就有约 1.0-1.3 个百分点(见下节误差棒)。信号衰减和噪声放大是乘在一起的。
对照检验#
纯净对照:没有溢价的世界#
同一套代码,把 λ 设成 0(不植入任何 vov 溢价),重跑:
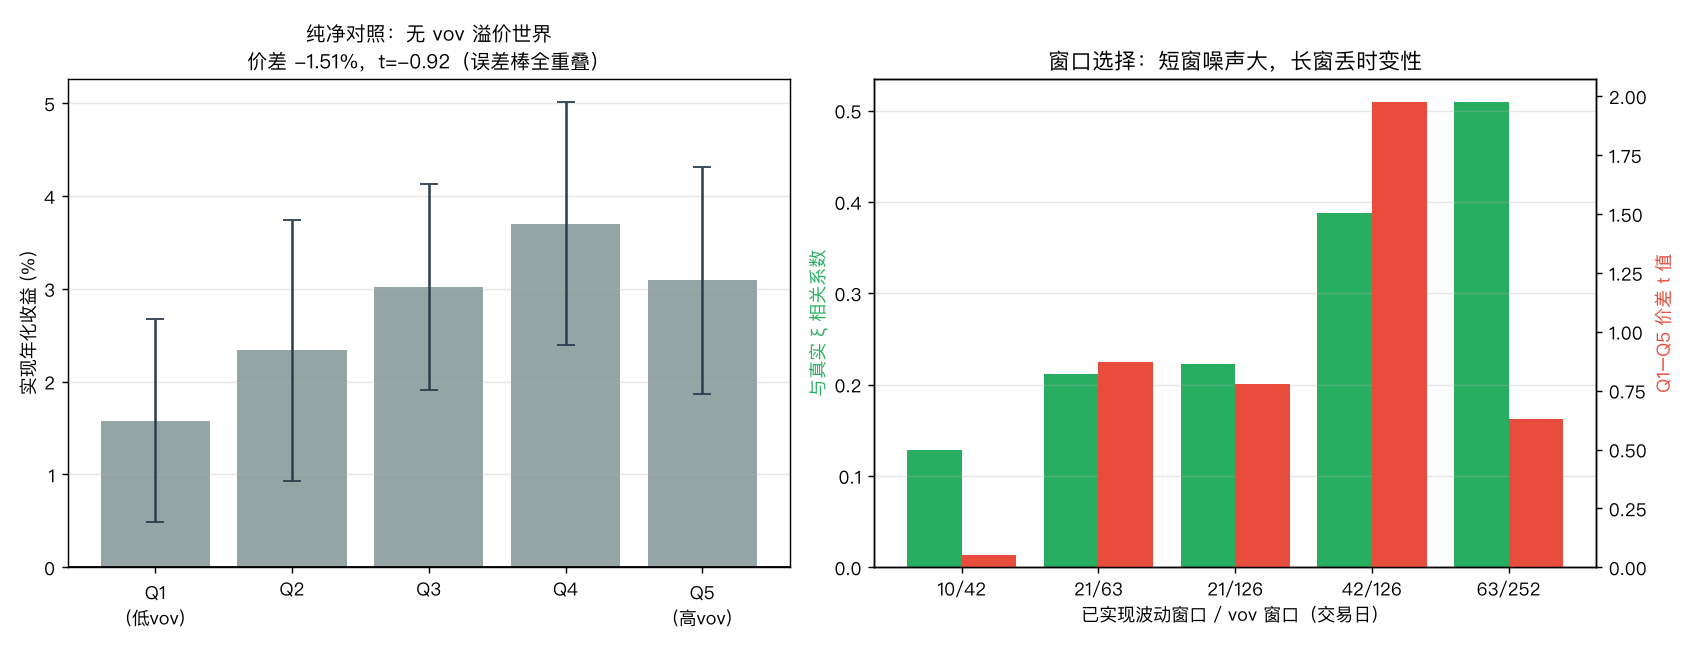
| 分组 | Q1 | Q2 | Q3 | Q4 | Q5 |
|---|---|---|---|---|---|
| 收益 | 1.58% | 2.34% | 3.02% | 3.70% | 3.09% |
| 标准误 | ±1.09 | ±1.40 | ±1.11 | ±1.31 | ±1.22 |
Q1−Q5 价差 −1.51%(t=−0.92),方向甚至反了,但完全不显著。
这张图里我特意加了误差棒,因为柱子看上去有个从 Q1 到 Q4 的上升趋势,容易被误读成「有效应」。误差棒全部重叠——任何两组之间的差异都在噪声范围内。 这正是一个纯净对照该有的样子:引擎不会凭空造出显著信号。
对照组还给出另一个数字:即便在无溢价世界,估计量与真实 ξ 的相关也有 0.157(用常规配置),这个相关是真实存在的(估计量确实弱相关于真实值),只是不带任何收益含义。
窗口敏感性:结论随窗口漂移#
| RV/vov 窗口 | 与真实 ξ 相关 | Q1−Q5 价差 | t 值 |
|---|---|---|---|
| 10/42 | 0.128 | 0.08% | 0.05 |
| 21/63 | 0.212 | 1.30% | 0.87 |
| 21/126 | 0.223 | 1.19% | 0.78 |
| 42/126 | 0.388 | 2.85% | 1.97 |
| 63/252 | 0.509 | 1.02% | 0.63 |
42/126 配置跑出 t=1.97,几乎就是「显著」。 而 10/42 配置跑出 0.08%,等于什么都没有。同一份数据、同一个真实溢价,换个窗口结论从「强证据」变成「零证据」。
这一行是本文对实证文献的主要怀疑来源。如果一个因子的显著性对估计窗口这么敏感,那么文献里那些显著结果里,有多少是试了几个窗口之后留下的那个? 注意 42/126 的相关系数(0.388)还不如 63/252(0.509),但 t 值高得多——估计质量最好的配置不是 t 值最高的配置,这几乎是过拟合的定义。
多种子稳健性#
15 个独立种子重跑(常规配置):
| 指标 | 数值 |
|---|---|
| 价差均值 | 0.69% |
| 价差标准差 | 2.19% |
| 最小 / 最大 | −2.95% / +3.36% |
| t 值均值 | 0.45 |
| 价差为正的次数 | 9 / 15 |
在一个确定植入了 3% 溢价的世界里,用常规估计量做实证,15 次里有 6 次会得到符号相反的结果。价差标准差 2.19% 是均值 0.69% 的 3 倍多。
这就是文献结论不一致的一个完全充分的解释——不需要假设市场变了、样本期特殊或者因子失效。 估计噪声本身就足以产生这种散布。
结果四:换手率与载荷稳定性#
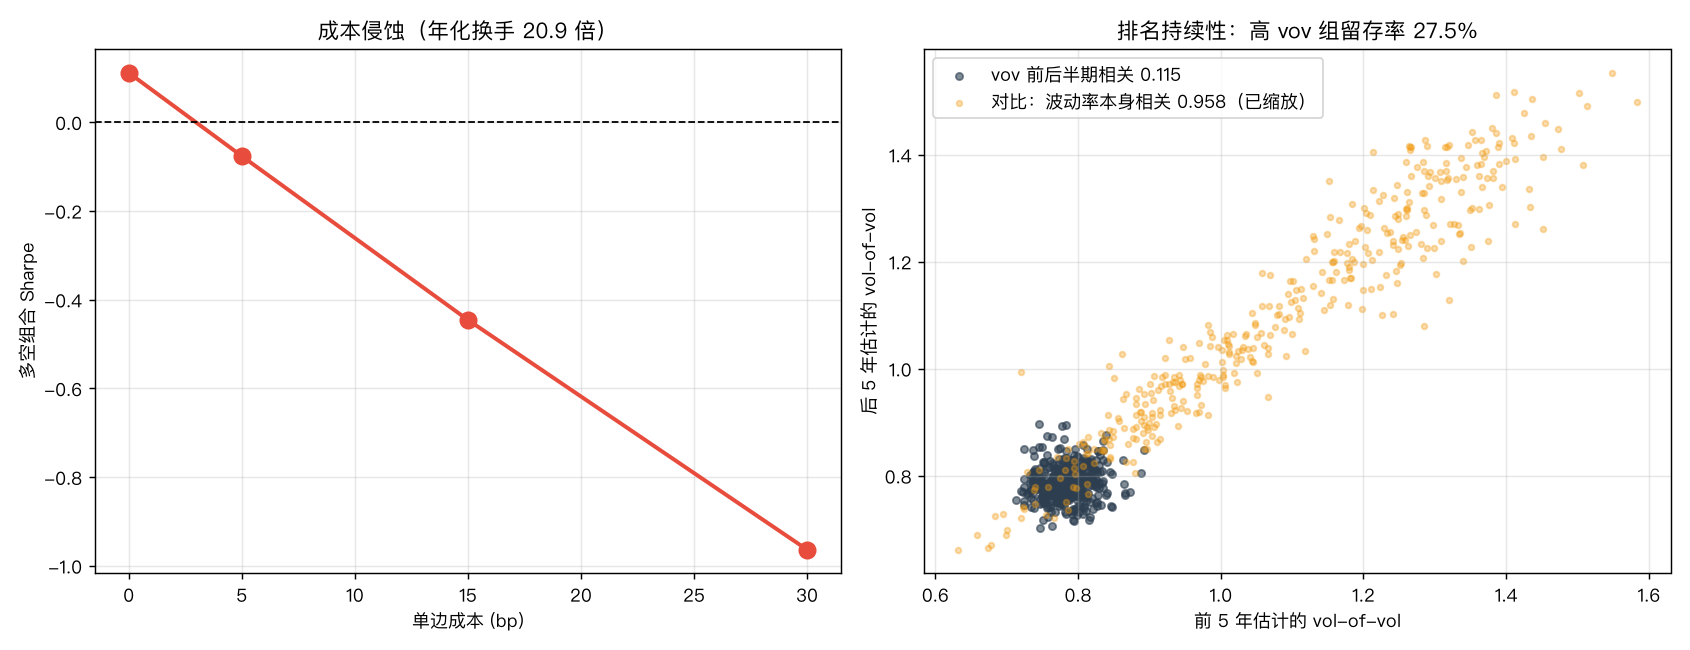
月度重构的多空组合(多低 vov、空高 vov,波动率中性):
| 单边成本 | 年化收益 | Sharpe |
|---|---|---|
| 0 bp | 0.62% | 0.11 |
| 5 bp | −0.43% | −0.08 |
| 15 bp | −2.52% | −0.45 |
| 30 bp | −5.65% | −0.96 |
年化单边换手 20.9 倍。 零成本 Sharpe 只有 0.11,5bp 就转负。
换手率为什么这么高?答案在右图:
| 指标 | vol-of-vol | 普通波动率 |
|---|---|---|
| 前后半期估计值相关 | 0.115 | 0.958 |
| 秩相关 | 0.132 | — |
| 最高组 5 年后仍在最高组的比例 | 27.5% | 73.8% |
在一个 ξ 被设定为恒定不变的世界里,vov 排名的前后半期相关只有 0.115。 真实值一动不动,估计值几乎完全洗牌——这是 95.5% 噪声占比的直接后果。高 vov 组的留存率 27.5%,只比随机的 20% 高一点。
对比普通波动率:同样是 5 年间隔,相关 0.958、留存 73.8%。同一批数据、同一个估计框架,一个稳如磐石,一个几乎是白噪声。
这条对比是本文最有诊断价值的一处。它给出一个不需要知道真实值就能在实盘上做的检查:把因子载荷做前后期分割,看排名持续性。 如果一个理论上应该缓变的属性,它的估计值持续性很低,那么问题几乎肯定在估计量而不在市场。
顺带解释了 20.9 倍换手:不是策略设计激进,是排序变量本身每个月都在重新洗牌。
实盘落地的估计量#
import numpy as np

def vov_estimate(returns, w_rv=63, denoise=True):
    """
    推荐配置:63 日无重叠块 + 噪声修正
    returns: (T, N) 日频收益
    """
    T, N = returns.shape
    nb = T // w_rv
    if nb < 8:
        raise ValueError(f"数据不足:只有 {nb} 个块,至少需要 8 个")

    rv = np.sqrt((returns[:nb*w_rv]**2).reshape(nb, w_rv, N).mean(axis=1))
    lv = np.log(rv)
    raw_var = np.var(np.diff(lv, axis=0), axis=0)        # 块间对数波动变动方差

    if denoise:
        raw_var = np.maximum(raw_var - 2*(1/(2*w_rv)), 1e-9)   # 扣掉 RV 估计误差
    return np.sqrt(raw_var * 252 / w_rv), nb

def diagnose(score_early, score_late, label="vov"):
    """上线前必做:载荷持续性检查"""
    n = len(score_early)
    top_e = set(np.argsort(score_early)[-n//5:])
    top_l = set(np.argsort(score_late)[-n//5:])
    return dict(
        corr=float(np.corrcoef(score_early, score_late)[0, 1]),
        top_retention=len(top_e & top_l) / (n//5) * 100,
        verdict="可用" if np.corrcoef(score_early, score_late)[0,1] > 0.5 else "估计量噪声过大",
)diagnose 比 vov_estimate 更重要。任何因子上线前都应该跑一遍持续性检查,成本极低,能识破的问题很多。留存率接近 20%(随机水平)就说明你的载荷是噪声,后面所有回测都不用看了。
已知偏差#
1. ξ 被设定为恒定。 真实的 vol-of-vol 自身会随市场状态变化(危机期普遍上升)。这个设定让本文的持续性检验成为一个纯粹的估计噪声度量——真实世界里低持续性会混合「估计噪声」和「真实时变」两个来源,无法用本文方法区分。也就是说,实盘看到的持续性比 0.115 高一些,不等于估计量比这里好。
2. 无跳跃。 真实收益含跳跃,会污染已实现波动,进而放大 vov 估计误差。本文的 95.5% 噪声占比在含跳跃数据上只会更差。用 bipower variation 等抗跳跃估计量可以缓解,本文未测。
3. 没有用期权隐含数据。 实务上 vov 的一个更好代理是 VVIX 类指标或期权隐含波动率曲面的波动,它们不依赖于从收益反推波动率,噪声结构完全不同。本文的结论只适用于「从日频收益估 vov」这一条路径。A 股无个股期权,这条路在国内基本是唯一选择——这恰恰说明国内做个股 vov 因子的难度被系统性低估了。
4. 溢价设为线性且时不变。 真实的 vov 溢价可能在高不确定性时期才显现。本文的检验对这种条件性溢价没有功效。
5. 400 只股票是小样本。 上帝视角的 t 值只有 1.99,说明即便测量完美,这个量级的溢价在 400 只股票上也处于统计功效边缘。扩到 3000 只股票,理论 t 值会到 5 以上——样本量本身可以救回一部分,但救不回估计量的 95.5% 噪声。
结果解读#
先说最重要的结论:这篇文章没有证明 vov 溢价不存在,它证明了在常规估计流程下你无法判断它是否存在。 上帝视角的 3.22%(t=1.99)和可观测估计量的 1.31%(t=0.77)来自同一份数据。前者说有,后者说不知道。差别不在市场,全在测量。
因子研究的失败模式有两种,混淆它们会导致完全错误的下一步。 第一种是「信号不存在」——再好的估计量也测不出东西,正确反应是放弃。第二种是「信号存在但估计量太差」——正确反应是改进估计量。这两种在实证结果上长得一模一样(都是 t 值不显著),而受控模拟是少数能把它们分开的手段。本文的 vov 属于第二种:噪声占 95.5%,改进空间巨大(0.212→0.676 只用了两个简单改动),但即便改到最优也只抓到 40.8%。
「捕获 67.6% 的 ξ 跨度只换回 40.8% 的收益价差」这个损耗比值得记住。 因子载荷的测量误差不是线性传导到收益的——它先稀释排序、再被分组内的收益噪声放大。一个「相关系数 0.68 还不错」的估计量,落到收益上可能只剩四成。评估估计量质量时看相关系数会系统性乐观。
窗口敏感性那张表应该让所有做因子研究的人警觉。 t 值从 0.05 到 1.97,跨度覆盖了「毫无证据」到「几乎显著」的整个区间,而这只是换了估计窗口。更微妙的是估计质量最好的配置(63/252,相关 0.509)不是 t 值最高的配置(42/126,相关 0.388)。如果你按 t 值挑窗口,你会挑中一个估计质量更差的配置——这就是过拟合在因子研究里的具体形态,它不需要任何主观作弊,只需要「试几个参数选效果好的」这个看起来完全合理的做法。
持续性检查应该成为标准动作。 0.115 vs 0.958 这个对比几乎是免费的诊断——不需要知道真实值、不需要模拟、不需要额外数据。任何理论上缓变的因子载荷,如果前后期相关低于 0.5,先怀疑估计量。我不觉得这个检查有多聪明,但它在本文里的判别力比任何统计检验都强。
成本这一关基本封死了这个因子的独立可交易性。 年化换手 20.9 倍、零成本 Sharpe 0.11——即便估计量改到最优,这个换手率也不是「优化一下调仓频率」能救的,因为换手来自载荷本身的不稳定。真正的出路是把 vov 当风险控制变量而不是 alpha 来源:在组合优化里对高 vov 暴露加惩罚项,不产生额外交易,只调整已有持仓的权重。这条路本文没测,但从换手结构看,它是唯一说得通的用法。
最后一个不太舒服的推论。 15 个种子里有 6 个跑出反向符号——这意味着如果 15 个研究团队在 15 个独立样本上做同一个正确的研究,会有 6 篇论文报告反向效应。而按发表偏好,最可能被发表的是那个跑出 +3.36% 的种子。文献里那些不一致的 vov 实证结果,可能压根不需要用「市场结构变化」来解释。